
4つの変化、1つの方向性
AI動画の多くには見分けがつく特徴があり、それは解像度ではありません。すべてが1人の人物に、1つの場所で、1種類のショットで起きていることです。ミュージックビデオは、90秒間、背景の前に立つ歌手だけになります。授業はナレーション付きの静止画になります。2人が登場するシーンは、2回に分けて生成したものを編集でつなぎ、誰も細かく見ないことを祈るしかありません。
最近加わった4つの変更は、いずれもこの同じ壁に挑んでいます。Music Performanceは、歌うシーンの繰り返しではなく、楽器演奏やステージパフォーマンスを含む、さまざまなシーンタイプを組み合わせる構成をデフォルトで作成するようになりました。また、開始時に自分の入力を取り込めるようになり、用意した画像から歌うキャラクターと歌わないキャラクターの両方をキャスティングできます。Kids Performanceは、リップシンク付きの先生キャラクターを軸にした授業を構成できます。そして、リップシンクが1本の動画内の複数のキャラクターに対応しました。
個別に見ると、4つの独立した改善に見えます。まとめて見ると、1つの変化を表しています。かつては自分で組み立てる必要があった動画の要素が、生成の中で完結するようになったのです。
Atlabsの新機能を見る
Music Performance:1人の歌手だけではないシーン

ここでの変化は、構成とフレーミングにあります。Music Performanceは、カメラに向かって歌う1人の人物のバリエーションではなく、楽器シーンやステージパフォーマンスを含む、より幅広いシーンタイプを1本の動画の中で作成するようになりました。
なぜそれが重要なのかを理解するために、本物のミュージックビデオがどう編集されているかを考えてみましょう。尺のうち、ボーカリストの静止したショットはほとんどありません。ボーカリスト、次にフレットボードの上を動く手、次に部屋の奥で半分だけ照らされたドラマー、次にシルエットになった観客を従えたステージの全景、そして異なる角度と距離からのボーカリストに戻ります。こうしたカットのリズムこそが、歌っている人の録画ではなく、ミュージックビデオらしさを感じさせる大きな要素です。最初のショットタイプしか作れないモデルでは、技術的には問題なくても構造的に単調な映像素材になってしまい、これまでは追加のショットタイプを個別に生成して自分で編集でつなぐしかありませんでした。
こうしたショットタイプを1つのフローの中で作成できるということは、別の編集作業なしでカットのリズムが手に入るということです。動画は最初から変化に富んだ状態で届きます。単調な状態で届いて変化を加える必要がある動画とは、出発点が違います。
注目すべき点は、これがデフォルトモードで適用されることです。詳細設定をして初めて現れる改善は、ほとんどの人が出会うことのない改善です。多くの人はデフォルト設定で1回生成し、返ってきたものでツールを判断するからです。設定していない最初の実行でより良い出力が得られることこそ、この改善が実際にユーザーに届く形です。
実際には、このフローを使える人の幅が広がります。シングルをリリースするインディーズのアーティストは、リリックビジュアルではなく、よりパフォーマンス動画に近いものが手に入ります。カバーアーティストは、カメラを持たなくても楽器の映像を得られます。撮影の予算はめったにないのに、きちんとした動画への視聴者の期待はある地域言語の音楽コンテンツを制作する人も、その期待を支えるショットのバリエーションを手にできます。
自分だけのミュージックビデオをキャスティングする
2つ目の変更は、Music Performanceの始まり方の再設計です。フローの冒頭で自分の入力を追加でき、キャスティングでは歌うキャラクターと歌わないキャラクターの両方の画像を受け付けます。
この後半部分は、見た目以上に重みがあります。これまで、生成されたミュージックビデオの人物はモデルが作り出した人物であり、それが出力の使い道に上限を設けていました。見知らぬ人が出演する動画は、雰囲気を楽しむための作品です。アーティスト本人が出演する動画は、リリースのための素材です。自分の歌手を追加できるということは、画面上でパフォーマンスしている人が、トラックでもパフォーマンスしている人だということです。この1つの変更が、出力を、友人に見せるものから、リリースに載せるものへと引き上げます。
歌わないキャラクターの枠は、これまで完全に閉ざされていたカテゴリーを開きます。多くの曲は歌う行為についてではなく、ある人物についての歌であり、その人物はセリフを言うことなく画面に登場する必要があります。ラブソングが最もわかりやすい例です。ラブソングは2人芝居です。アーティストがパフォーマンスし、もう1人の主役が、歌詞を口パクするのではなく歌詞が描く場面に登場して、物語の感情面の半分を担います。パートナー、友人、俳優を歌わないキャラクターとしてキャスティングすれば、その第2の主役を直接得られます。
この構造は、探してみるとロマンスよりはるかに多くの場面をカバーします。アーティストが歌い、ほかのキャラクターが物語を演じる物語仕立ての演出。歌わずに被写体が最初から最後まで登場するトリビュート。実在の人物が本人として登場する家族やコミュニティの作品。ブランドとのコラボレーションで、広報担当者がパフォーマンスするアーティストと並んで登場するもの。いずれも同じ形、つまり1つの声と、複数の顔です。
お気に入りの曲に合わせたリップシンクと組み合わせることで、このフローは、出力をそのまま受け入れる生成ツールではなく、キャスティングツールになります。これは姿勢の大きな変化です。誰が出演しているかを生成後に確かめるのではなく、生成の前に自分で決めるのです。
良い元画像を選ぶことは、アイデンティティを軸にしたあらゆる生成と同じように、ここでも役立ちます。正面を向き、均一に照らされ、遮るもののない顔であれば、モデルが推測する部分が最も少なくて済みます。顔の半分に濃い影がかかっている、サングラスをかけている、被写体ブレがある、極端な角度といった画像は、その人物がシーンをまたいでどれだけ一貫して保たれるかを下げます。生成を使って確かめる前に、画像選びに1分かける価値があります。
自分だけのミュージックビデオをキャスティングする
Kids Performance:実際に話す先生
Kids Performanceは、先生キャラクターを軸にした教育コンテンツを作成できるようになりました。その口は、自分のセリフのときだけ、自分のセリフに合わせて動きます。
子ども向けの教育動画には、一般的な動画生成が見落としがちな要件が1つあります。幼い視聴者は顔を追うということです。キャラクターが自分のほうを見て話しかけてくれると注意が続き、反応のないイラストにかぶせてナレーションが流れると注意は途切れます。これはその年齢の注意の働き方に近く、どのプラットフォームでも成功している子ども向けのフォーマットのほとんどが、司会者、パペット、あるいは視聴者に直接語りかけるキャラクターを軸にしているのはそのためです。
かつて問題になっていたのは、2人目のキャラクターが同じフレームに入ったときでした。シーン内のすべての口がすべてのセリフに合わせて動くため、先生と生徒の両方が先生の文を口パクし、動画は授業ではなくエラーのように見えてしまいました。今は、発話が誰のものかがきちんと割り当てられます。先生がセリフを話し、生徒はじっと立って耳を傾け、視聴者は誰が話しているかがわかります。これが2人のキャラクターによる授業の土台のすべてです。
こうした形式が成り立つのは、リップシンクだけでなく、この割り当てがあるからです。概念の説明が成り立つのは、キャラクターが「こうするとどうなるか見てみて」と言ってから、実際にやってみせられるからです。フォニックスや文字の音が成り立つのは、口の形が偶然ではなく教えの一部だからです。数を数える、数列を学ぶという内容が成り立つのは、ペースがキャプションのタイマーではなく話す人から生まれるからです。ステップごとの科学実験が成り立つのは、司会者が、静止画にかぶせたナレーションではできない形で、視聴者を手順に沿って案内できるからです。質問と回答の形式も、以前には到底できなかった形で成り立ちます。生徒が質問し、先生が答えるとき、2人が同じことを言っているように見えることがないからです。
子ども向けチャンネルの運営者にとって、これは制作の問いを、ナレーション付きスライドショーをいかに早く作るかから、キャストのいる授業をいかに作るかへと変えます。先生やエドテック企業のチームにとっては、誰も撮影することなく、一貫した司会者と、教室で出る質問をする2人目のキャラクターを教材に登場させられるということです。
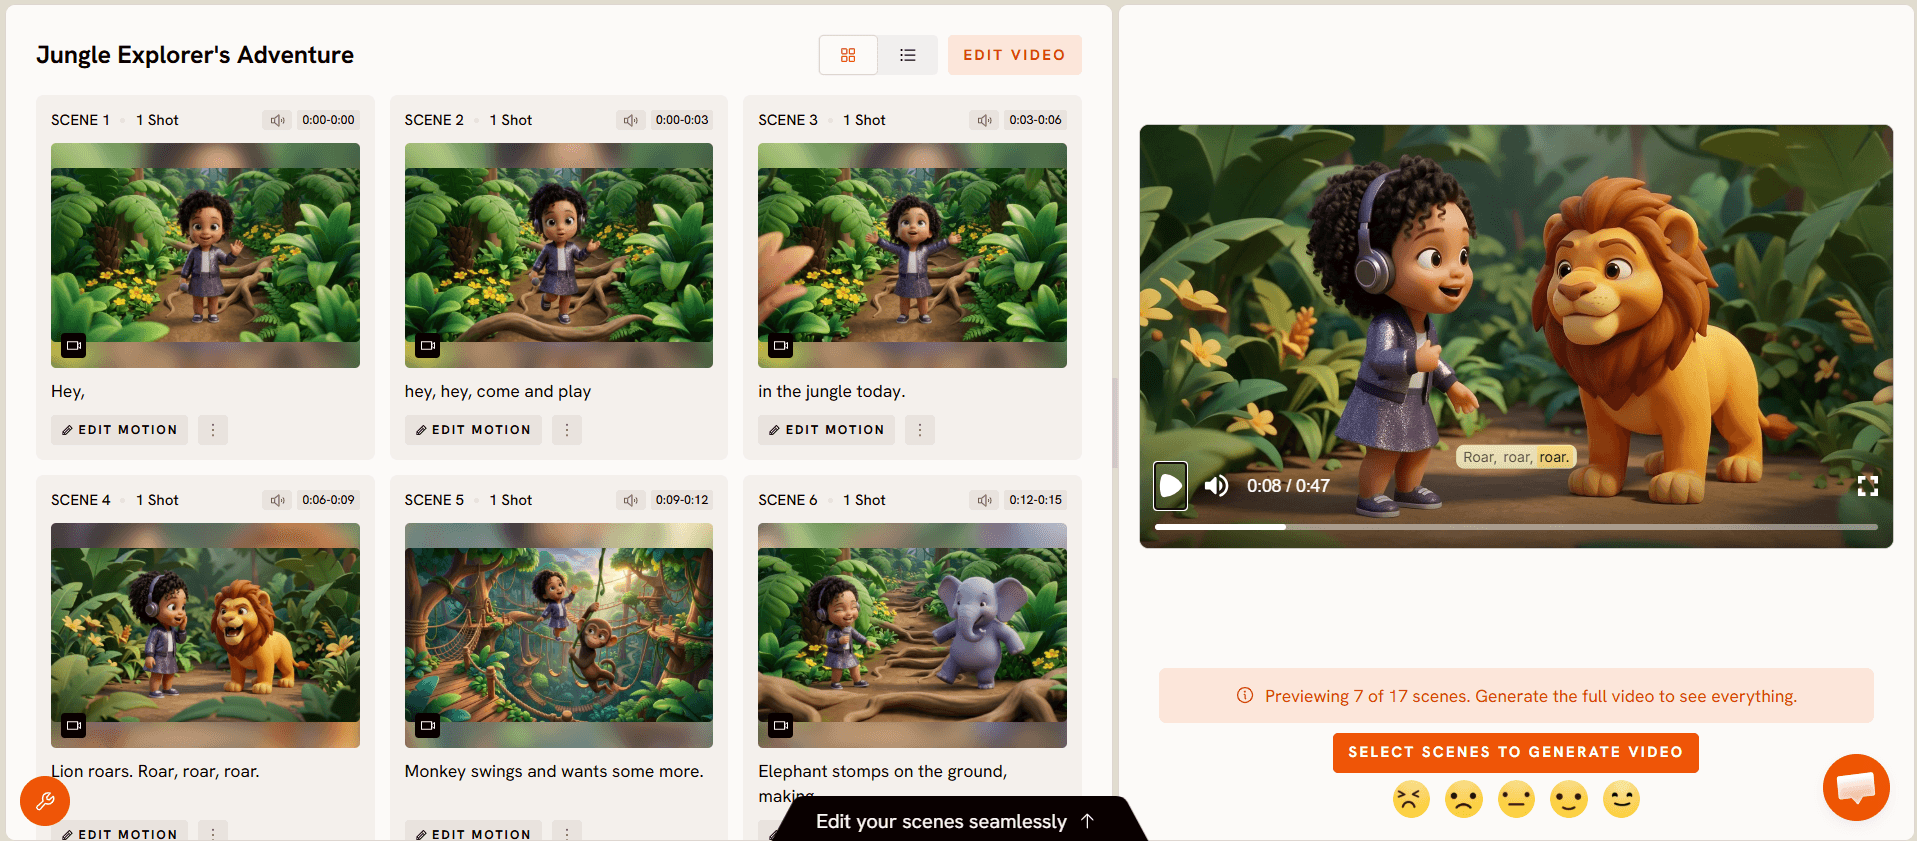
この視聴者に向けた台本は、控えめであるほど報われます。1つのビートに1つのアイデア、短い文、そして要となるフレーズの意図的な繰り返しです。リップシンクされたキャラクターが、大人向けの密度の高い文を読み上げると、技術的には成り立っていても何も教えない動画になります。話し方が聞き手を追い越してしまうからです。
マルチキャラクター・リップシンク
リップシンクが、1人ではなく複数のキャラクターに対応しました。
単一キャラクターのリップシンクが対象とするのは話す顔のアップですが、話す顔のアップは、人々が作りたいものの意外に狭い範囲しかカバーしません。会話にまつわるものはすべてその外側にあります。2人のキャラクターがセリフを交わす。先生と生徒。インタビュー。製品解説の中のお客様とサポート担当者。物語の中の親と子。コーラスのコール・アンド・レスポンスの部分。そのどれにおいても、返答はセリフと同じくらい重要です。
単一キャラクターのリップシンクでそれらを作るには、話し手をそれぞれ個別に生成して、編集でつなぐ必要がありました。時間がかかるうえ、さらに重要なことに、見た目がそのまま作り物だとわかります。2つの映像は決して同じ部屋にいるようには見えず、視線は合わず、照明はずれ、やり取りのタイミングは演じられたものではなく編集で作り出さなければなりません。この方法で2人の会話を偽装しようとした人なら、結果が2つの独白を並べただけに見えることをご存じでしょう。
1回の生成の中で複数の話し手を扱えることで、対話がネイティブな出力になります。やり取りは1つの空間で、1つの照明設定のもと、あなたのタイムラインではなくシーンに属するタイミングで進みます。
これは、ほかの3つの変更の多くを支える土台となる機能でもあります。歌わない2人目の主役を加えたキャスティング付きのミュージックビデオは、そのキャラクターが何かを話す必要が生じた瞬間に説得力を失います。先生キャラクターのいる授業は、授業が答える質問を2人目のキャラクターが投げかけられるようになると、格段に良くなります。マルチキャラクター・リップシンクが、こうした形式をまとまりのあるものにします。
これらの変更を最大限に活かす方法
1. 何かを書く前にキャストを決める。 誰が歌い、誰が登場し、誰が話すのかは、今や3つの別々の問いであり、最初に答えを出しておくと、書く内容が変わります。2人目の主役がいる曲には、その主役が登場できるシーンが必要です。
2. 元画像をきちんと集める。 正面を向き、均一に照らされ、1枚につき1つのはっきりした顔。ここでもう1分かけたほうが、あとからアイデンティティのずれの原因を探るよりずっと早く済みます。
3. まずデフォルトモードで生成する。 シーン構成の改善はそこで適用されるため、最初の実行は設定作業ではなく、このフローの公正なテストになります。基準となる結果を見てから変更しましょう。
4. 2つの演説ではなく、やり取りとして対話を書く。 複数のキャラクターが話せるようになった今、長いブロックよりも、短い交互のセリフのほうが効果的です。2人目のキャラクターに、割り込ませる、尋ねさせる、反応させるなどしましょう。
5. 子ども向けコンテンツでは、紙面ではなくビートに合わせて台本を書く。 1つのビートに1つのアイデア、要となるフレーズを繰り返し、キャラクターが聞かれるだけでなく見てもらえる余白を残しましょう。
プロンプトの例
1. バンドのフルパフォーマンス。 An indie four piece performing in a converted warehouse at dusk, string lights overhead, dust in the air. Cut between the vocalist at the mic, hands moving on a bass fretboard, the drummer half lit at the back, and a wide of the room with the small crowd silhouetted. Warm practical lighting, shallow depth of field, handheld feel on the wide shots. Atlabs Music Performanceで試す
2. ロマンティックな2人の主役の演出。 A rooftop at blue hour, city haze catching the last light. The artist performs against the skyline while a second character, who never sings, moves through the scenes the lyrics describe, sitting on the ledge, walking the stairwell, watching from the doorway. Soft cool grade, warm skin tones, slow camera moves throughout. Atlabs Music Performanceで試す
3. ソロ楽器にフォーカス。 A single performer at an upright piano in an empty rehearsal room, morning light through high windows. Alternate between a wide of the room, a close on the hands, a profile at eye level, and a slow push toward the face on the final phrase. Muted palette, natural light only. Atlabs Music Performanceで試す
4. 先生キャラクターの解説。 A friendly animated teacher in a bright classroom explains why ice floats, addressing the camera directly. She holds up a glass of water, drops an ice cube in, and points as it rises. Short sentences, one idea at a time, the key phrase repeated at the end. Warm colours, simple background, nothing competing with her face. Atlabs Kids Performanceで試す
5. 2人のキャラクターによる授業。 A teaching character and a curious student in a garden setting. The student asks why leaves change colour, the teacher answers in three short steps, and the student repeats the answer back. Both characters speak on camera with matched lighting and eyelines. Bright, soft, storybook palette. Atlabs Kids Performanceで試す
Atlabsで実行する
よくある質問
ミュージックビデオで自分の顔を使えるようになりましたか? はい。Music Performanceでは、フローの冒頭で、歌うキャラクターと歌わないキャラクターの両方について、自分の画像を取り込めます。
歌わないキャストメンバーは何のためにありますか? ボーカルを担当せずに登場するすべてのキャラクターのためです。ロマンスの主役、物語のキャラクター、トリビュートの対象、あるいはパフォーマンスではなくコンセプトにとって存在が重要な人物などです。
改善されたシーン構成には特別な設定が必要ですか? いいえ。より幅広い構成、フレーミング、シーンタイプはデフォルトモードで適用されるため、設定なしの最初の生成にも反映されます。
Music Performanceは現在どのようなショットを作成しますか? カメラに向かって歌うシーンに加えて、楽器シーンやステージパフォーマンスを含む、さまざまなシーンタイプを同じ動画内で組み合わせて構成します。
マルチキャラクター・リップシンクは何に役立ちますか? 複数の人が話すあらゆる動画に役立ちます。会話、先生と生徒のやり取り、インタビュー、コール・アンド・レスポンスのシーケンスが、1回の生成で可能になります。
リップシンクされた先生キャラクターで何を作れますか? 概念の説明、フォニックスや文字の音、数を数えるシーケンス、ステップごとの科学実験、語学学習、ストーリー仕立ての授業などです。ナレーションよりも司会者が伝えたほうがうまくいくものなら何でも作れます。
これらの変更は組み合わせて使えますか? はい。そこにこそ価値の大部分があります。キャスティングとマルチキャラクター・リップシンクの組み合わせが、2人の主役のミュージックビデオや2人のキャラクターによる授業を、1つのシーンとしてまとまったものにします。
すべてを合わせるとどうなるか
4つの変更に共通するのは、かつては生成のあとに行っていた作業が、生成の最中に行われるようになったということです。ショットのバリエーションは編集の問題でした。2人目のキャラクターは、2回目の生成でした。対話は、2つのクリップをつないだものでした。キャスティングは、実際にはまったく利用できませんでした。
音楽クリエイターにとっては、生成されたものではなく編集されたように見え、本物のアーティストと、曲が歌う本物の人々が登場する動画になります。教育クリエイターにとっては、ナレーション付きスライドショーではなく、司会者のいる授業になります。どちらの場合も、すり合わせる別々の生成が減り、継ぎ目が見える箇所も減ります。








