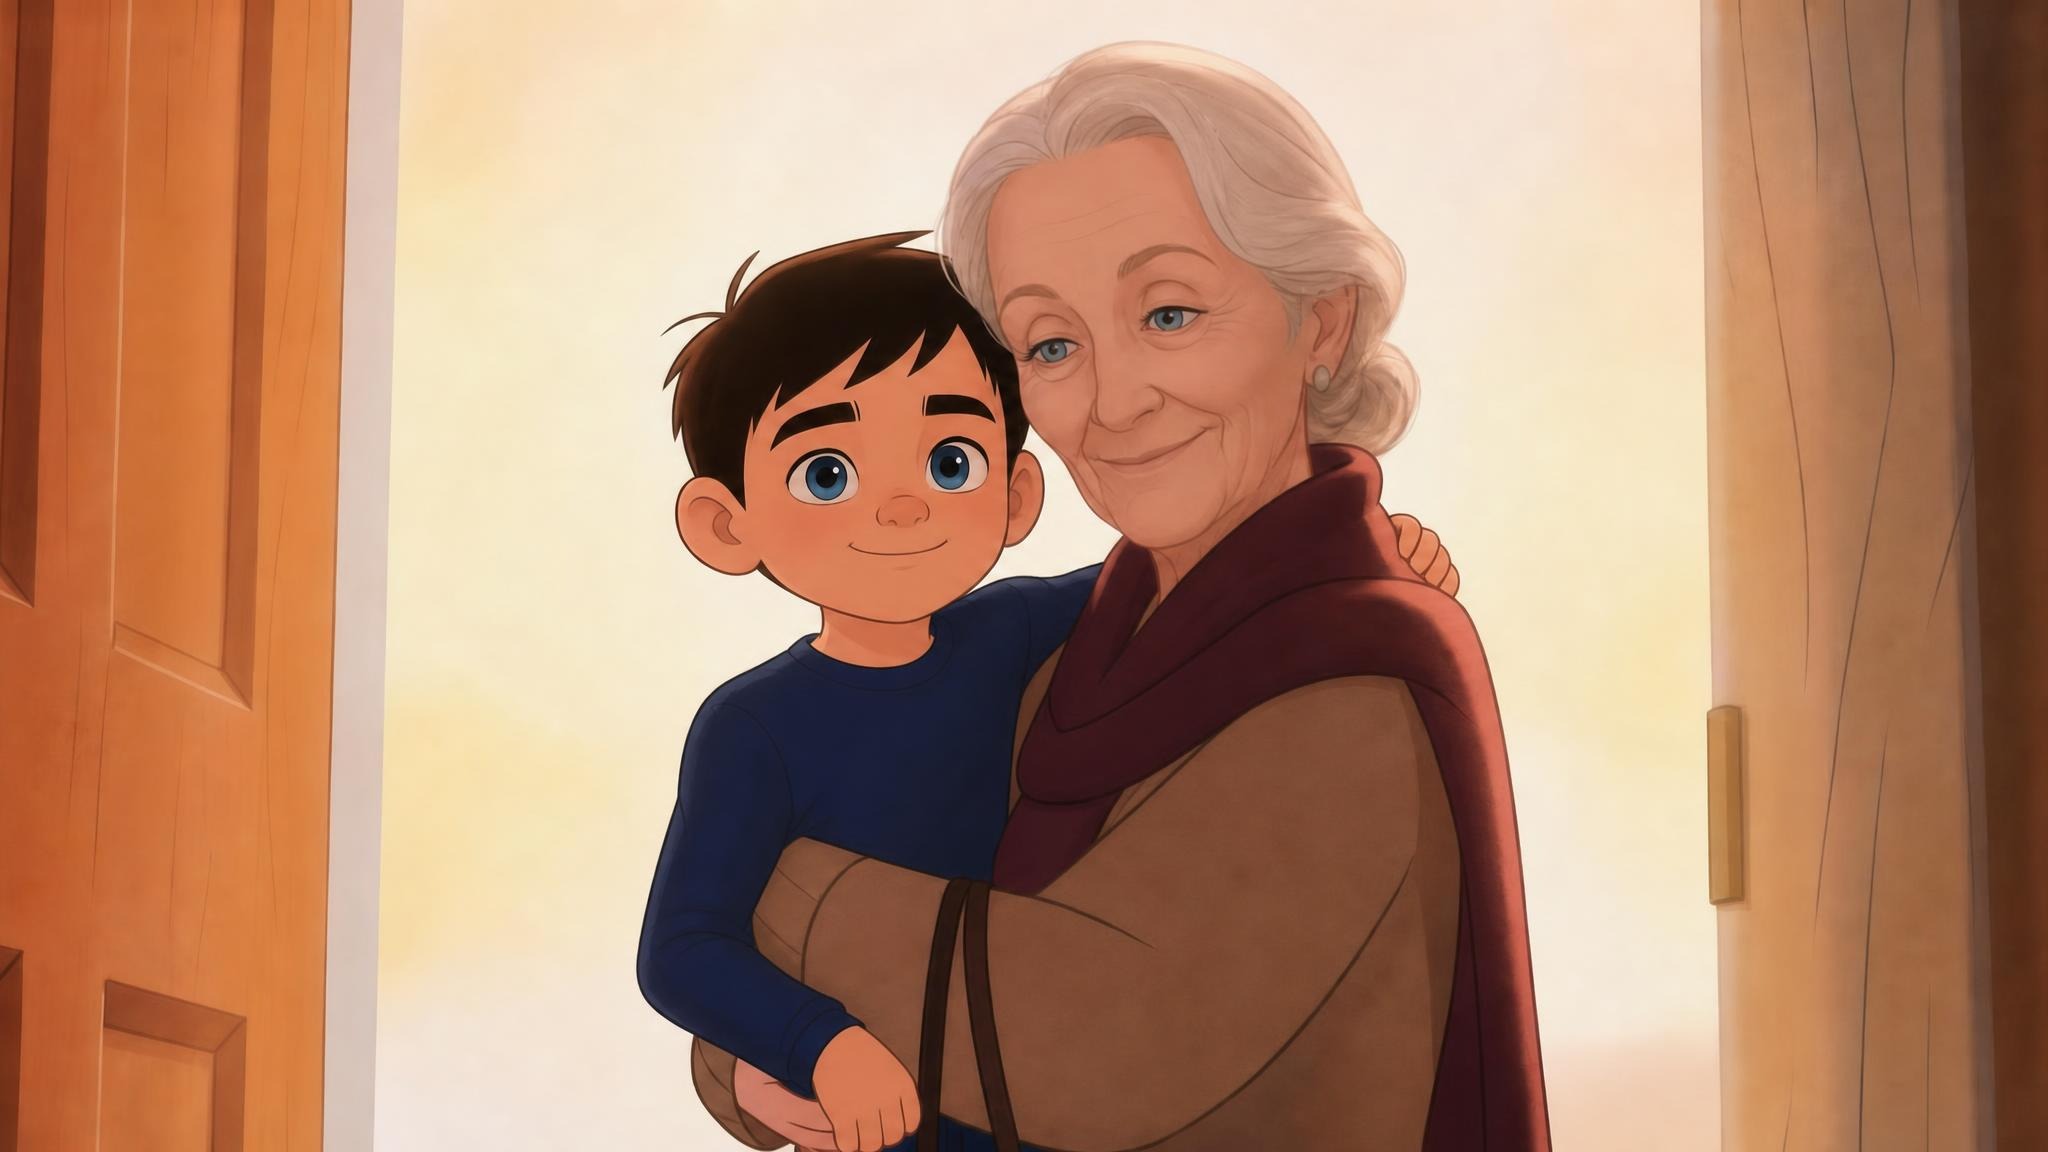
一个年轻男子坐在沙发上,旁边是一位红发女子。他脑中闪过什么。他站起身,大喊“AUNT MAY!”,沿着走廊奔跑。跑的同时,他在变小。没有剪切,没有闪光,而是连续不断地,一步一步,直到走廊尽头拉开门的人变成了一个小男孩。门后等着的是抚养他长大的那位女士,她接住了他。
如果你是看着蜘蛛侠长大的,你就已经知道这为什么能打动人。这个角色之所以一直成立,是因为拥有超能力的英雄,同时也是那个从未停止需要姨妈的孩子。十秒,一个镜头,没有剪切,整段关系就呈现在屏幕上,没有一句说明性的台词。
本教程会准确讲解这个片段是如何制作出来的。这里的角色是原创的风格化设计,而不是对任何人的服装或形象的复制,这才让致敬依然是致敬。这项技巧本身适用于任何情感类动画短片,只要其中的角色需要在一切都在改变的同时,依然能被认出是他自己。
为什么单镜头变身是最难的部分
大多数AI视频看起来像AI视频,是因为镜头与镜头之间发生的事情。为同一个角色生成两个片段,你会得到两个略有不同的人。下颌更窄,头发分向另一边,夹克的蓝色也不一样。观众会立刻注意到这一点,即使他们说不出哪里不对,而一旦脸不再是同一张脸,情感节点就死了。
年龄回溯的序列会让这个问题更糟而不是更好,因为角色本来就应该发生变化。模型必须理解哪些变化是故事的一部分,也就是身高、比例、面部的柔和程度,哪些变化是错误,也就是身份、发色、服装逻辑、眼睛的具体形状。这条界线搞错了,观众看到的就是走廊中途冒出来另一个人,而不是同一个人在变年轻。
解决办法不是更好的动作提示词,而是把身份完全锁定在视频提示词之外。你先把角色做成图像,然后把这些图像作为命名的参考交给视频模型,并在提示词中准确告诉它,哪一张参考图在第几秒控制哪个角色。模型就不再凭空编造面孔,而是开始为你给它的那些面孔制作动画。
驱动这一切的两个工具
这两个步骤都在 Atlabs.
GPT Image 2 中完成,它负责构建角色参考。这是你花费最多精力的地方,因为最终视频的每一帧都会继承这些图像。你在这里做的不是概念图,而是一份视频模型必须遵守的角色设定表。
Seedance 2.0 Ref to Video 负责生成片段。Seedance 2.0是适合这件事的模型,因为它在风格化角色创作和富有表现力的面部动画上,比写实类模型更出色,而Ref to Video模式允许你传入多张带标签的参考图,并在提示词中按名称调用。正是这种标签化,让多角色、多阶段的镜头能够在一次生成中完成。
分步教程
第一部分:在GPT Image 2中构建你的角色参考
1. 打开GPT Image 2,生成你的第一张参考图。 前往 GPT Image 2。这第一张图确立你的角色的成年版本,以及与他共处开场场景的人物。把提示词写成选角描述,而不是情绪板。肤色、发型和发色、眼睛颜色、确切的服装、姿态,全部清楚地写明,因为任何你留得模糊的东西,之后都会由视频模型替你决定。
这部短片使用的开场场景参考图,描述的是一个深色头发的年轻男子和一位红发女子坐在米色沙发上,处于温暖的金色室内光线中,正面朝向镜头,腰部以上,采用16:9的精致3D动画电影风格。一些小细节在不抄袭任何东西的前提下承载了致敬:他衬衫领口处一个若隐若现的几何蛛网状图案,比一整套服装更能说明问题。完整的提示词在下面的提示词部分。

2. 生成你的第二张参考图:年轻版本和年长的女士。 同样的工具,新的图像。这一张承载的是这个男人变成的男孩,以及等在走廊尽头的年长女士。这里的关键细节是,男孩必须看起来像是你第一张图中成年人的合理年轻版本。同样的发色,同样的眼睛颜色,同样的脸型,只是因年龄而显得更柔和。如果这两张图在这些方面不一致,变身看起来就会像是替换,而不是回溯。
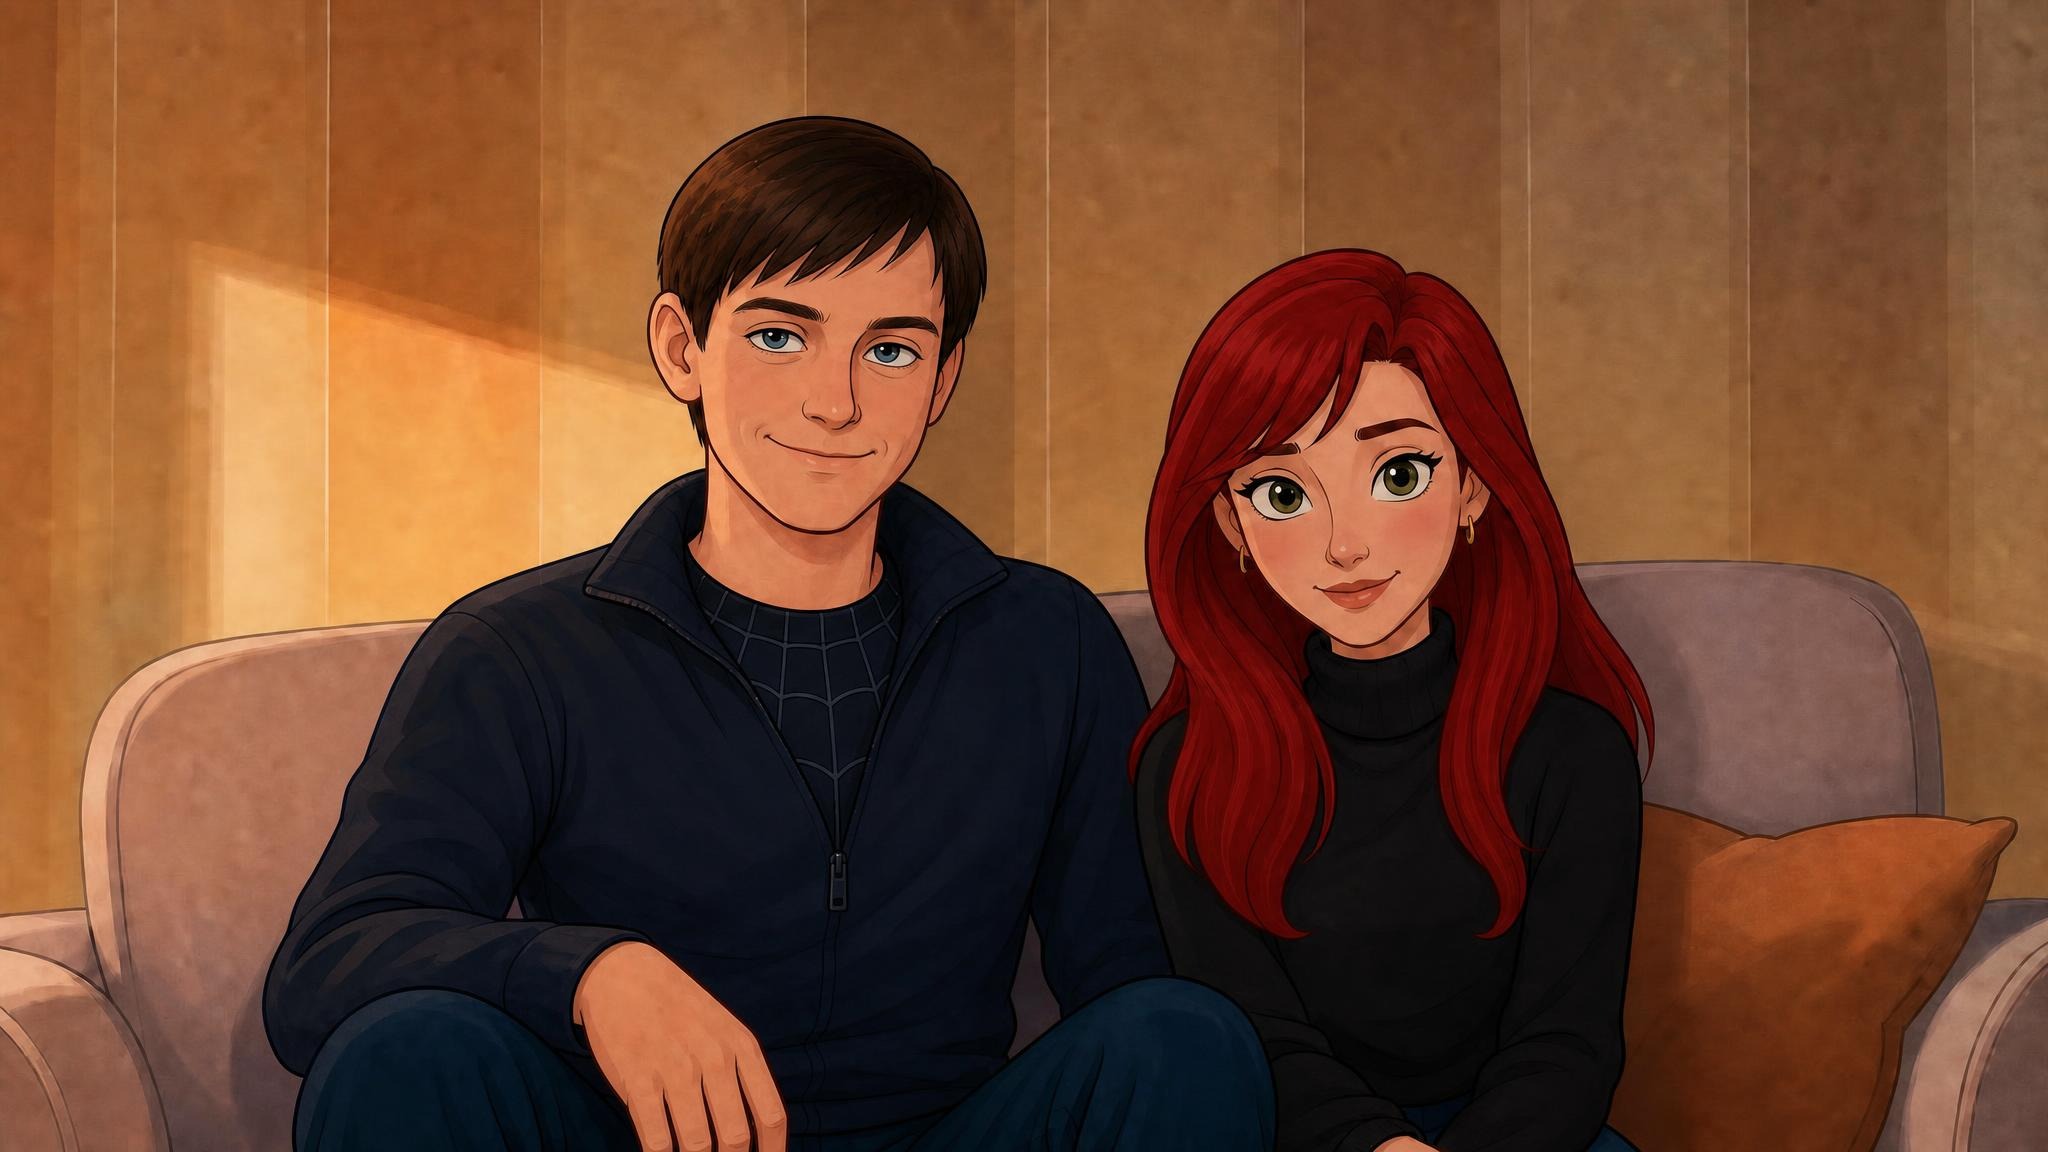
3. 继续之前,先把两张图互相对照检查。 把它们并排放在一起。光线语言是否一致,两张都是温暖的金色室内光。动画风格是否一致,同样的风格化程度,同样的眼睛大小逻辑,同样的皮肤渲染。身份在年龄差距之间是否保持一致。现在就修正任何不匹配,因为你以后在视频阶段是没法修正的。
准备好构建你自己的参考图了吗? 从GPT Image 2开始.
第二部分:在Seedance 2.0 Ref to Video中生成镜头
4. 打开Seedance 2.0 Ref to Video并上传两张参考图。 前往 Seedance 2.0 Ref to Video。上传你的沙发场景图和团聚场景图。它们会变成 @img1 和 @img2,这些标签就是你在提示词中指代每个角色的方式。
5. 把提示词写成时间线,而不是描述。 这是区分一个成功的片段和一个差一点成功的片段的关键。不要把场景当作一个整体来描述,而是把这十秒拆成带标签的节拍,并写明每一拍发生什么:
前两秒是顿悟。男子站起来,大喊“AUNT MAY!”,开始移动。第二到第六秒是奔跑和变身,这里你要写明年龄变化是在他奔跑的过程中连续发生的,从成年人到年轻成年人,到少年,再到小男孩,镜头始终不切走。第六到第八秒是开门。第八到第十秒是团聚和拥抱。
6. 添加约束块。 在时间线下面,写明模型不能做什么。没有闪光,没有溶解,没有瞬移,没有突然变形,变身期间没有剪切,没有重复的角色,没有文字或水印。在这样的镜头里,否定性约束起到很大作用,因为模型解决一个困难变身的最简单办法,就是把它藏在剪辑之后,而你明确地把这条路堵死了。
7. 分别指定镜头、光线、情绪和音频。 为每一项各写一个块。镜头涵盖从中景到跟拍再到亲密特写的运动。光线涵盖沿着走廊越来越温暖的室内光。情绪说明意图,让面部动画有方向。音频涵盖管弦乐的递进、喊出的台词、脚步声和房间底噪。
8. 生成,然后对照你的参考图进行检查。 先看一遍变身,再看一遍身份。变身应当在发生的过程中可见,而不是在画面之外完成。门口的男孩应当就是你第二张参考图里的男孩,年长的女士应当与她的参考图完全吻合。如果身份发生漂移,就收紧提示词中的参考表述,而不是盲目重新生成。
为什么这种方法行得通
参考锁定消除了猜测。因为 @img1 和 @img2 是真正的图像而不是描述,模型是在与像素匹配,而不是在解读形容词。两个人读到“短的深棕色头发”,会想象出两种不同的发型,同一个模型的两次生成也是如此。图像则完全消除了这种歧义。
带时间戳的节拍给模型一个可以填充的结构,而不是一个需要自己编造的故事。用散文写成的十秒提示词会被不可预测地压缩,由模型决定每个时刻持续多久。写成0:00到0:02、0:02到0:06、0:06到0:08、0:08到0:10,节奏就由你掌控。奔跑拿到完整的四秒,因为那是变身必须清晰可辨的地方。
Seedance 2.0是为风格化角色表演而构建的。整部短片依赖于脸部传达情感,而这个模型在富有表现力的动画特征和可信的物理互动上,比为写实调校的模型处理得更好。为工作选对模型,比提示词的长度更重要。
提示词中的音频指示省去了单独的一轮处理。管弦乐的递进、喊出的名字、脚步声和房间底噪都与画面一起指定,所以音乐的情感高点落在拥抱上,而不是事后再剪辑去迁就。
专业技巧
把时间花在参考图上,而不是视频提示词上。薄弱的参考图无法靠更长的视频提示词挽救,而强有力的参考图能让简短的视频提示词奏效。如果你发现自己在第八次视频生成中还在试图修正一张脸,那问题出在上游。
把否定项写得和肯定项一样具体。“No cuts”比“no flash, no dissolve, no teleportation, no sudden morph, no cut during the transformation”要弱。你是在封堵模型可能走的每一条捷径,而你留下的每一条,都是它可能选择的。
给最难的节拍最多的时间。变身占据十秒中的四秒,因为它需要清晰可辨。如果你把它压缩到两秒,模型就必须动得太快,并会以一种你没要求的方式完成这个变化。按难度而不是按对剧情的重要性来分配屏幕时间。
在两张参考图之间保持光线连续。第一张是温暖的金色室内光,第二张也是温暖的金色室内光。当两张参考图在光线方向或色温上不一致时,视频模型必须在镜头中途去调和它们,而你就会看到接缝。
常见问题
我可以使用多少张参考图? Ref to Video的设计就是围绕传入多张带标签的参考图,并在提示词中按名称引用每一张。这部短片使用了两张,每个场景一张,第二张参考图包含两个角色。把一起出场的角色归入同一张参考图,能让他们的相对比例和光线保持一致。
为什么不把变身拆成单独的片段再剪辑在一起? 你可以这样做,而且会更容易,但读起来不会一样。这个镜头的情感分量,来自观众看着变化发生,而没有任何剪切可以躲藏。一旦你剪辑了,它就变成了蒙太奇,而不是变身。
我能围绕蜘蛛侠这样的现有角色来制作吗? 请自己设计角色,而不是复制现有的服装、标志或演员形象。人们回应的是情感节点,而风格化的原创角色同样能承载它。一些带有暗示性的小细节,比如领口处的蛛网状纹理而不是一整套战衣,能让致敬清晰可辨,又不抄袭任何东西。
我可以用真人而不是动画角色来做吗? 工作流是一样的。先构建你的参考图,然后传给Ref to Video。这里使用风格化3D,是因为Seedance 2.0特别擅长处理富有表现力的动画面孔,但参考锁定的方法适用于任何风格。
如果角色的身份在中途漂移了怎么办? 在重新生成之前,先收紧提示词中的参考表述。重申某张特定的参考图控制某个特定的角色,并点明必须保留什么,通常就能解决。如果问题依然存在,那很可能是两张参考图在身份上本来就不一致。
片段可以多长? 这一条是按十秒写的,足够容纳一个有清晰情感弧线的四拍结构。更长的镜头为漂移留下更多空间,所以由几个严格控制的镜头组成一部更长的作品,往往比要求一次长生成更稳妥。
最终结论
大多数AI动画之所以让人觉得空洞,是因为它看起来像是拼装出来的,而不是表演出来的。面孔在镜头之间变化,变身被藏在剪辑背后,情感节点始终无法落地,因为观众在悄悄地琢磨自己看的是不是同一个人。
在GPT Image 2中把角色锁定为图像,然后在Seedance 2.0 Ref to Video中逐拍导演他们,可以一次性解决这两个问题。在任何一帧动起来之前,你先批准角色阵容,然后像导演而不是提示词工程师那样去写这个镜头。构建你自己的角色,而不是复制现有角色,这份致敬就依然属于你。