
要用AI制作口型同步音乐视频,你需要把人声音轨上传到 Atlabs,选择 Performance 视频类型,挑选视觉风格和角色,系统就会让画面中表演者的嘴部动作与你的音频匹配。AI口型同步会读取每个字的发音,预测发出该音的嘴型,并逐帧为人脸制作动画,让角色看起来真的在唱你的歌。无需摄像机、无需演员,也不需要剪辑时间线。
AI口型同步究竟是如何工作的
AI口型同步从音频开始,而不是从画面开始。模型会聆听你的人声音轨,把它拆分成称为音素的细小声音片段,音素是构成说话和歌唱的基本单位。每个音素都对应一种发音的嘴型:发“啊”时下巴张开,发“m”时双唇紧闭,发“呜”时嘴唇收圆。模型通过大量人们说话和唱歌的影像学会了这些对应关系。
一旦知道每个时刻发的是哪个声音,它就会预测匹配的嘴型,并为视频的每一帧重绘下半张脸。现代系统不止处理嘴唇,它们还会移动下颌、调整脸颊、改变下巴,让整个下半张脸的表现像真正的歌手一样。结果是,角色的嘴部紧密跟随你的人声线条,观众会把它视为真实的表演,而不是木偶。
对音乐视频来说,有两点让它比基础的“说话头像”同步更难。唱歌拉长元音的时间远超说话,而且整段片段中时间必须始终与节拍对齐。Atlabs 在音乐视频工作流中处理这一点的方式,是把你上传的音轨作为主时间基准,因此嘴部动作和音频永远不会错位。
你 需要 准备什么
三样东西,大约十分钟。你需要一个免费的 Atlabs 账号、一条 mp3 或 Suno 链接形式的人声音轨,以及对想要外观的大致想法,比如电影感且情绪化、明亮流行、霓虹都市。你不需要摄像机、演员、口型同步练习或任何剪辑软件。如果你的歌曲人声清晰,就可以直接同步。
在YouTube上观看完整视频
如何制作口型同步音乐视频,分步指南
整个流程都在音乐视频工作流中完成。下面是从上传到完成表演视频的完整演示。
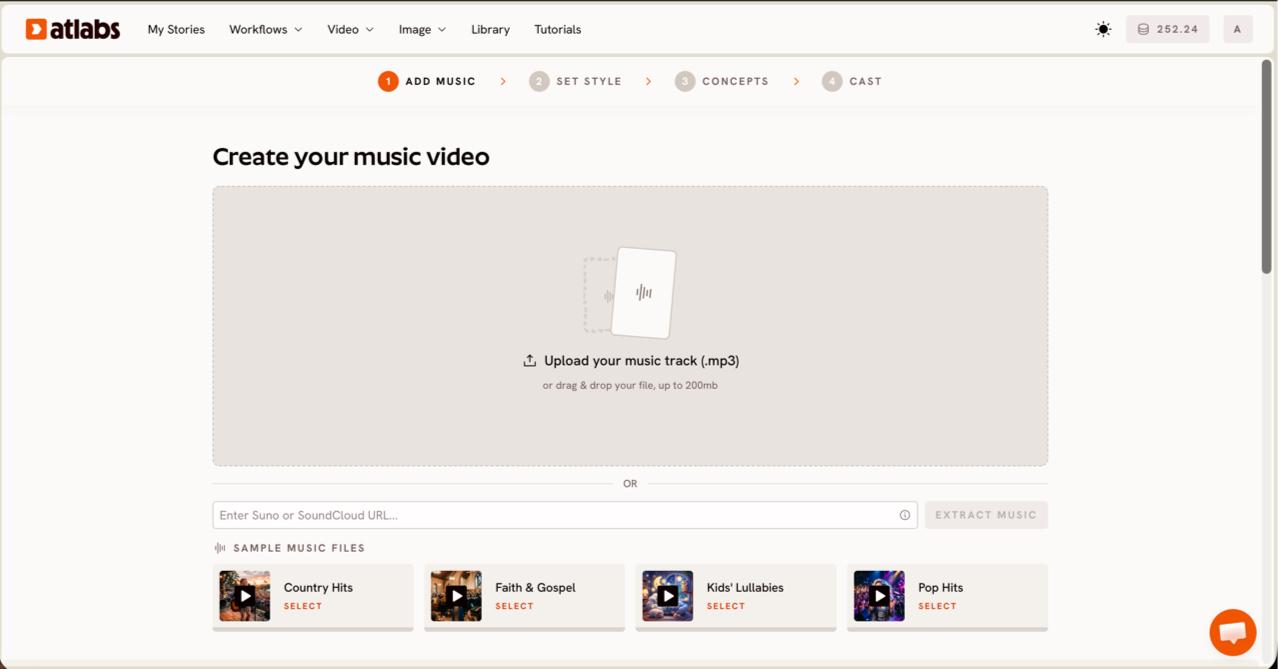
第1步
打开音乐视频工作流并上传你的音轨。在 Add Music 界面,上传最大 200MB 的 mp3,或粘贴 Suno 音乐链接并点击 EXTRACT MUSIC。Atlabs 会自动检测歌曲的节奏、情绪和曲风,以便后续流程与之匹配。
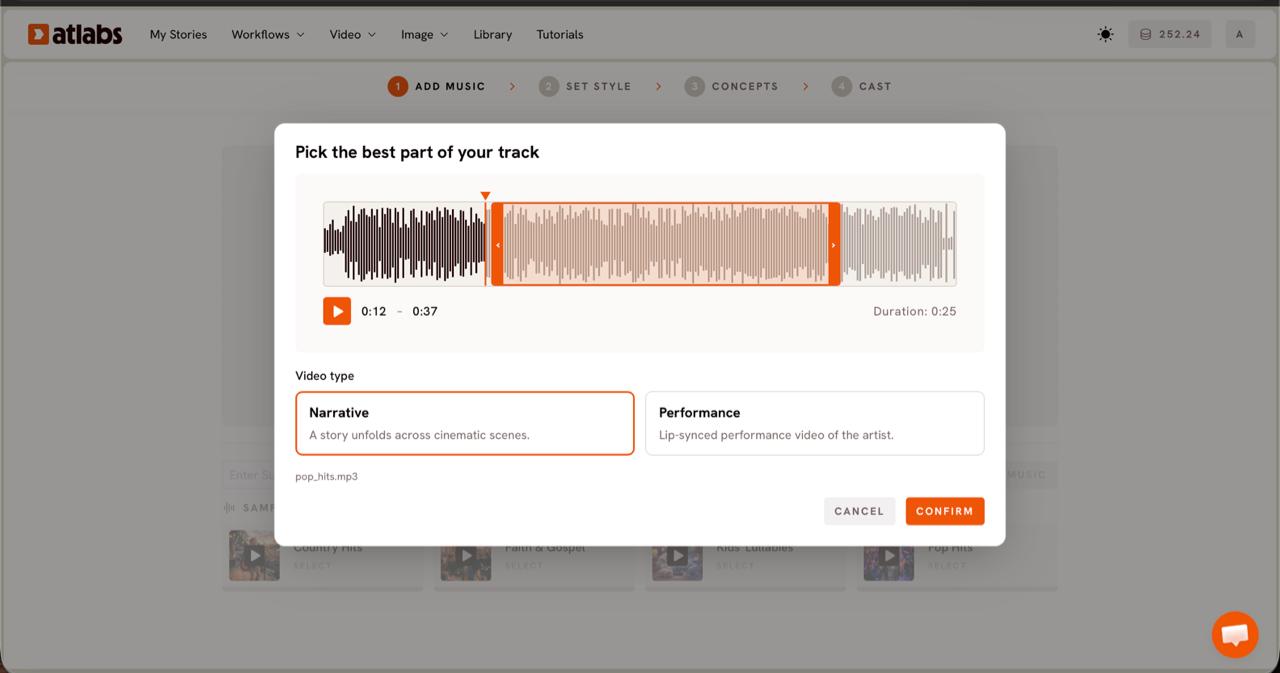
第2步
选取片段,并将视频类型选为 Performance。会打开“Pick the best part of your track”窗口。拖动绿色选择窗口覆盖波形,选出你想呈现的部分,通常最长约25秒。选择 Performance,这个选项专为歌曲有人声、且你希望艺人出镜的口型同步表演视频而设计。
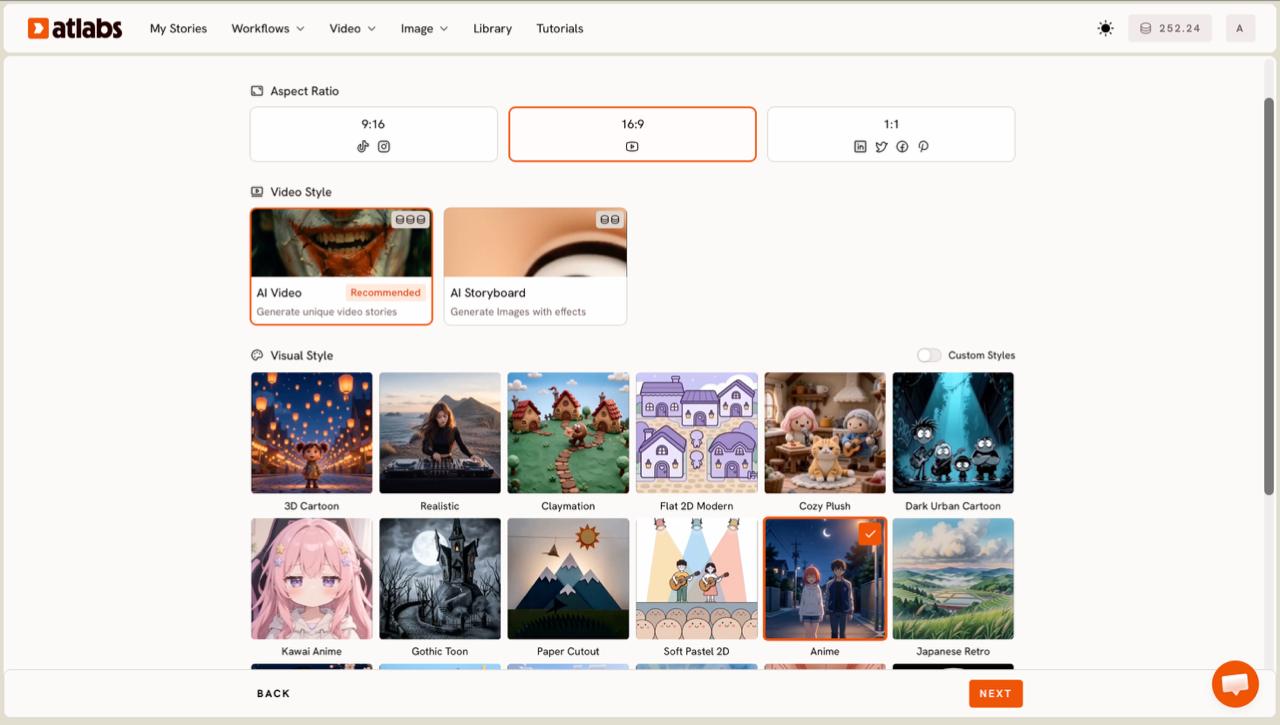
第3步
设定风格。选择宽高比:TikTok 和 Instagram 用 9:16,YouTube 用 16:9,Facebook 和 Pinterest 用 1:1。视频风格保持 AI Video 以生成独一无二的场景,然后选择视觉风格,比如 Realistic 带来真人实拍感,或 Dark Urban Cartoon 呈现风格化外观。
第4步
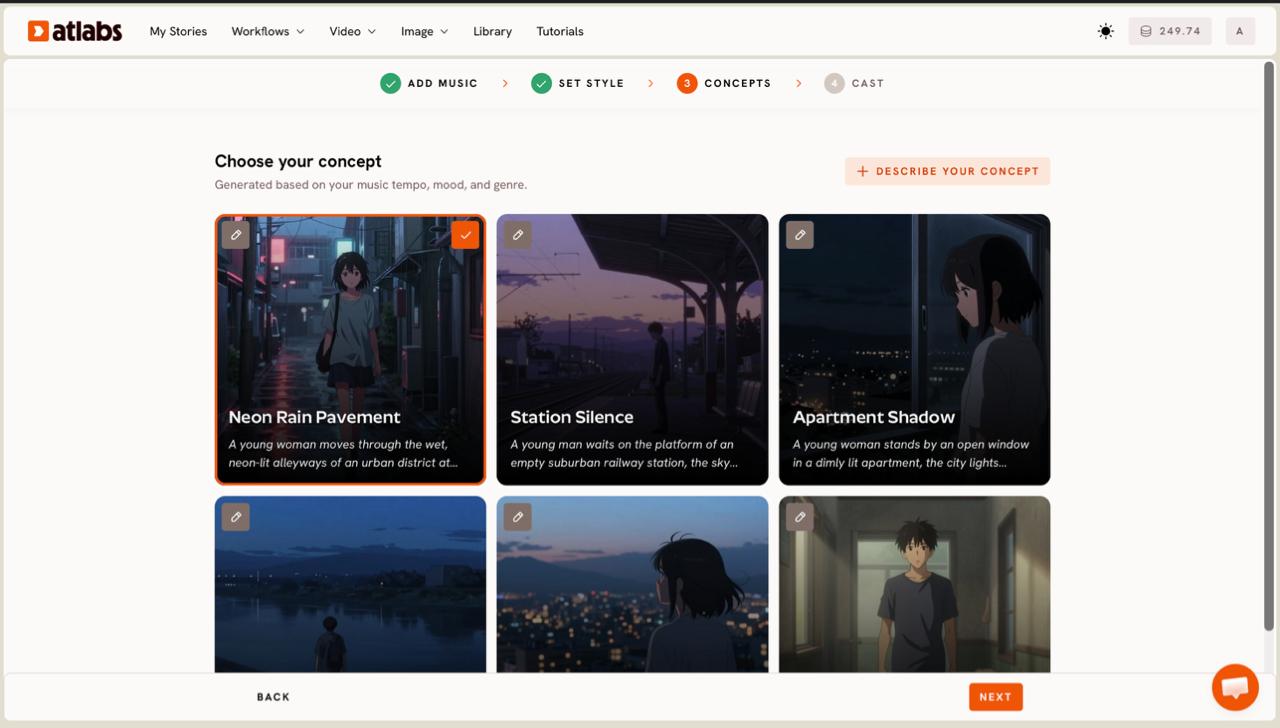
选择你的创意。Atlabs 会展示根据你音轨的节奏、情绪和曲风生成的六个场景创意,每个都是带编辑铅笔图标的卡片。选择最适合你歌曲的一个,或点击 DESCRIBE YOUR CONCEPT,完整写下你自己的方向。
第5步
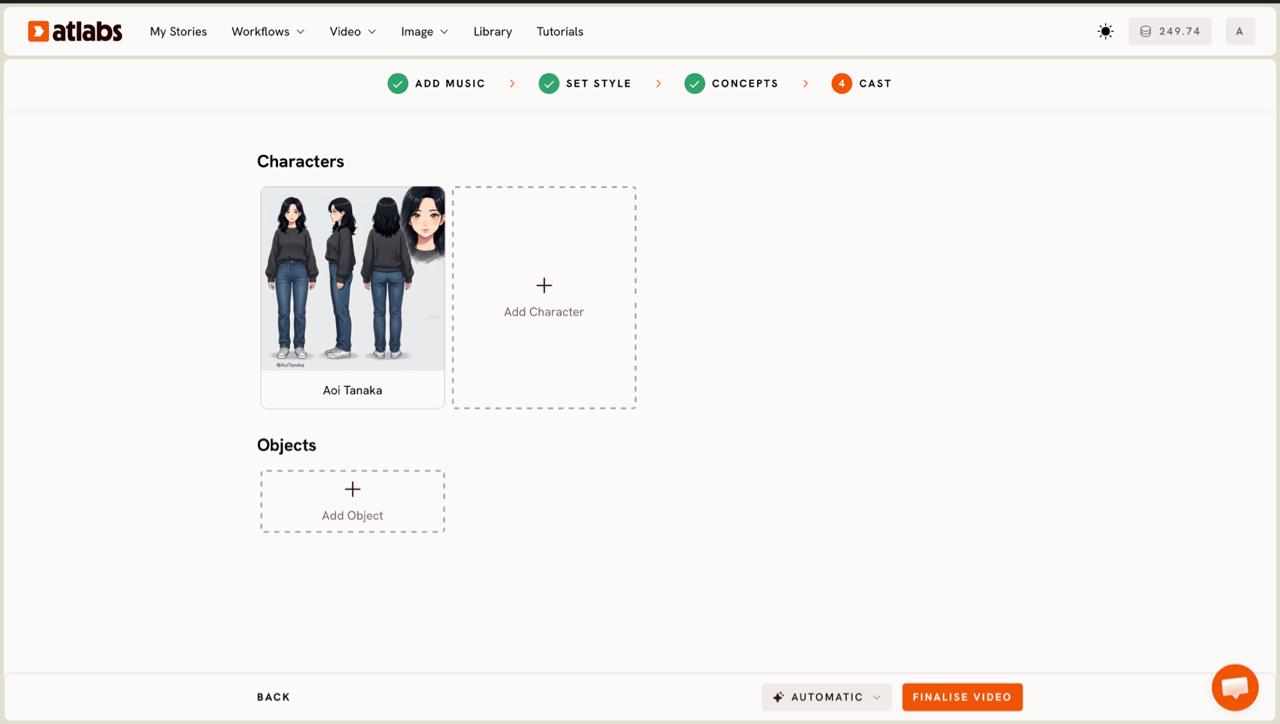
设定表演者并生成。在 Cast 步骤中,定义将在画面中演唱的角色。每张角色卡片都会显示包含多个角度的生成参考图,保证同一张脸在每个场景中保持一致。点击空位即可 Add Character,或打开 Click to edit 微调外观,然后生成。Atlabs 会构建表演,并让角色的嘴部与你的人声音轨同步。
让口型同步更干净的技巧
从干净的人声混音开始。模型读取的是人声线条,所以人声清晰地位于伴奏之上的音轨,同步效果会比人声被淹没的音轨更紧密。如果你有清唱版或人声突出的版本,那是最好的输入。选择咬字清晰、有力的段落,而不是长段的纯器乐,因为字词清楚时嘴部动作有最多可依据的信息。想让表演有真人实拍感时选择 Realistic 视觉风格,并在整个视频中只用一个角色,让同一张脸贯穿每个场景。如果第一次生成在快速段落中出现偏移,请把片段裁剪到更紧凑的部分后重新生成。
可直接复制的提示词
如果你在第4步自己撰写创意,这些提示词能给生成器清晰的表演指引。把其中一条粘贴到 DESCRIBE YOUR CONCEPT,再按你的歌曲调整细节。
一名独唱歌手在昏暗的录音棚中表演,只有一盏温暖的台灯照明,副歌时镜头缓慢推向面部,浅景深,胶片颗粒,表演者以特写镜头直视镜头演唱,让口型同步清晰可辨。
黄昏时分的屋顶表演,身后是城市灯光,艺人以中近景朝镜头演唱,轻微的手持晃动,冷蓝色天空衬着温暖的肤色,剪辑点落在音轨的节拍上。
常见问题
制作口型同步音乐视频需要多长时间?
大部分工作在五步设置中,大约需要十分钟。之后是生成过程,具体时间取决于你所选片段的长度和所选的视觉风格。
我需要剪辑或动画技能吗?
不需要。你上传人声音轨、做几个选择,Atlabs 就会处理口型同步和场景生成。没有需要学习的剪辑时间线,也不需要手工做动画。
我可以使用哪些音频文件?
你可以在 Add Music 界面上传最大 200MB 的 mp3,或粘贴 Suno 音乐链接。人声突出的混音能带来最干净的同步,因为模型直接读取人声。
同一位歌手可以出现在整个视频中吗?
可以。在 Cast 步骤中,每张角色卡片都带有多角度参考图,让同一张脸在视频的每个场景中保持一致。
开始使用
上传人声音轨,选择 Performance,看着你的歌曲变成口型同步视频。
打开Atlabs








