
四项更新,一个方向
大多数AI视频的输出都有一个破绽,而且并不是分辨率。而是所有事情都发生在同一个人、同一个地点、同一种镜头里。一支音乐视频变成了歌手站在背景前唱九十秒。一堂课变成了配着图片的旁白。一个有两个人的场景,变成了两次单独的生成,你把它们剪在一起,还要祈祷没人看得太仔细。
最近上线的这四项更新,都在冲破同一堵墙。音乐表演现在默认会组合多种场景类型,包括乐器演奏和舞台表演,而不是重复的演唱镜头。它还能在一开始接收你自己的输入,并根据你提供的图片为演唱和非演唱角色选角。儿童表演可以围绕一个会口型同步的教学角色来构建一堂课。而口型同步现在可以在同一个视频中处理多个角色。
单独来看,它们像是四项独立的改进。放在一起看,它们描述的是同一个转变:视频中过去需要你自己拼装的部分,现在都在生成过程中完成了。
查看 Atlabs 的新功能
音乐表演:不止一位歌手的场景

这次的变化在于构图和取景。音乐表演现在可以在单个视频中生成更多种类的场景,包括乐器场景和舞台表演,而不再只是一个人对着镜头唱歌的各种变体。
要理解这为什么重要,不妨想想真正的音乐视频是怎么剪辑的。几乎没有哪段时长是歌手的静态镜头。你先看到歌手,然后是手指在指板上移动,接着是鼓手在房间后方半明半暗,再来是舞台全景与剪影般的观众,然后又回到歌手,换了一个角度、一个距离。这些剪辑的节奏,在很大程度上决定了它看起来像一支音乐视频,而不是对某人唱歌的录像。只能生成第一种镜头的模型,给你的素材技术上没有问题,但结构上平淡无奇,而过去的解决办法是分别生成每一种额外的镜头,再自己剪辑。
在一个流程中生成这些镜头类型,意味着剪辑节奏无需单独的剪辑环节就能获得。视频出来时就已经富于变化,这与一个出来时千篇一律、还需要再加以变化的视频,起点完全不同。
值得注意的细节是,这在默认模式下就适用。只有配置高级设置后才会出现的改进,大多数人根本不会遇到,因为大多数人都用默认设置生成一次,然后根据出来的结果来评判这个工具。在未经配置的首次运行中获得更好的输出,才是真正触达用户的那种改进。
实际上,这拓宽了这个流程的服务对象。发行单曲的独立艺人得到的更接近一支表演视频,而不是歌词视觉。翻唱艺人无需拥有摄像机,就能获得乐器镜头。任何制作小语种音乐内容的人,通常没有拍摄预算,但观众却期待一支像样的视频,现在也能获得这种期待所依赖的镜头多样性。
为你自己的音乐视频选角
第二项更新是对音乐表演起始方式的重新设计。你可以在流程开始时加入自己的输入,选角同时接受演唱者和非演唱者的图片。
后半句的分量比乍看起来要重。到目前为止,生成的音乐视频里的人物都是模型凭空创造的,这限制了输出的用途。有陌生人出镜的视频只是一段氛围片;有艺人本人出镜的视频才是发行素材。加入你自己的歌手,意味着画面中表演的人就是歌曲中演唱的人,这一个变化,就让输出从给朋友看的东西,变成了可以用于发行的东西。
非演唱者席位开辟了一个过去完全封闭的类别。很多歌曲并不是关于唱歌这个行为,而是关于某个人,而这个人需要出现在画面中,却不必唱出任何一句。浪漫题材是最明显的例子。情歌是一出双人戏。艺人负责演唱,第二位主角承担故事的情感另一半,出现在歌词所描绘的场景中,而不是对口型。把伴侣、朋友或演员作为非演唱角色加入,就直接给了你这位第二主角。
一旦你去找,同样的结构所涵盖的远不止浪漫题材。艺人演唱、其他角色演绎故事的叙事型处理。主角全程出现却不唱歌的致敬作品。真实的人以本人身份出现的家庭或社区作品。代言人与演唱艺人同框的品牌合作。这些都是同一个形态:一个声音,多张面孔。
再结合你所选歌曲的口型同步,这个流程就成了一个选角工具,而不是一个你只能被动接受结果的生成器。这是姿态上有意义的转变。你是在生成之前决定谁出现在视频中,而不是事后去评判谁出现了。
选择好的源图片,对任何基于身份的生成都有帮助,这里也一样。正面、光线均匀、没有遮挡的面孔,让模型需要猜测的东西最少。半边脸被重阴影笼罩、戴墨镜、运动模糊和极端角度,都会降低这个人在各个场景中保持一致的程度,所以在花费一次生成去验证之前,花一分钟挑选图片是值得的。
为你自己的音乐视频选角
儿童表演:真正会说话的老师
儿童表演现在可以围绕一个教学角色来构建教育内容,这个角色只在说自己的台词时嘴巴才会动,而且只对自己的台词动。
儿童教育视频有一个通用视频生成往往忽略的要求。年幼的观众会盯着脸看。当角色看着他们并开口说话时,注意力就能保持;而当声音在对它毫无回应的插图上旁白时,注意力就会流失。这与这个年龄段注意力的运作方式很接近,也是为什么任何平台上几乎所有成功的儿童节目形式,都围绕着一个主持人、一个木偶或一个直接对观众说话的角色来构建。
过去会出问题的,是第二个角色同框时的情形。场景中每一张嘴在每一句台词上都会动,于是老师和学生都在对着老师的句子动嘴,视频不再像一堂课,反而像出了错。现在说话有了归属。老师说台词,学生保持不动认真听,观众能分辨是谁在说话,而这正是双角色课程的全部基础。
让这些形式成立的是这种归属,而不仅仅是口型同步。概念讲解之所以有效,是因为角色可以说“看看我这样做会发生什么”,然后真的去做。自然拼读和字母发音之所以有效,是因为口型本身就是教学的一部分,而不是附带的。数数和数字序列之所以有效,是因为节奏来自一个人在说话,而不是字幕计时器。分步骤的科学实验之所以有效,是因为主持人可以带着观众走完一个流程,这是配在静态图上的旁白做不到的。问答形式现在能做到过去根本做不到的效果,因为学生可以提问、老师可以回答,而不会让两人看起来在说同一句话。
对儿童频道运营者来说,这把制作问题从如何更快地做出旁白幻灯片,变成了如何制作有角色阵容的课程。对教师或教育科技团队来说,这意味着课堂材料可以有一位固定的主持人,以及一个提出课堂上会有的问题的第二角色,而无需拍摄任何人。
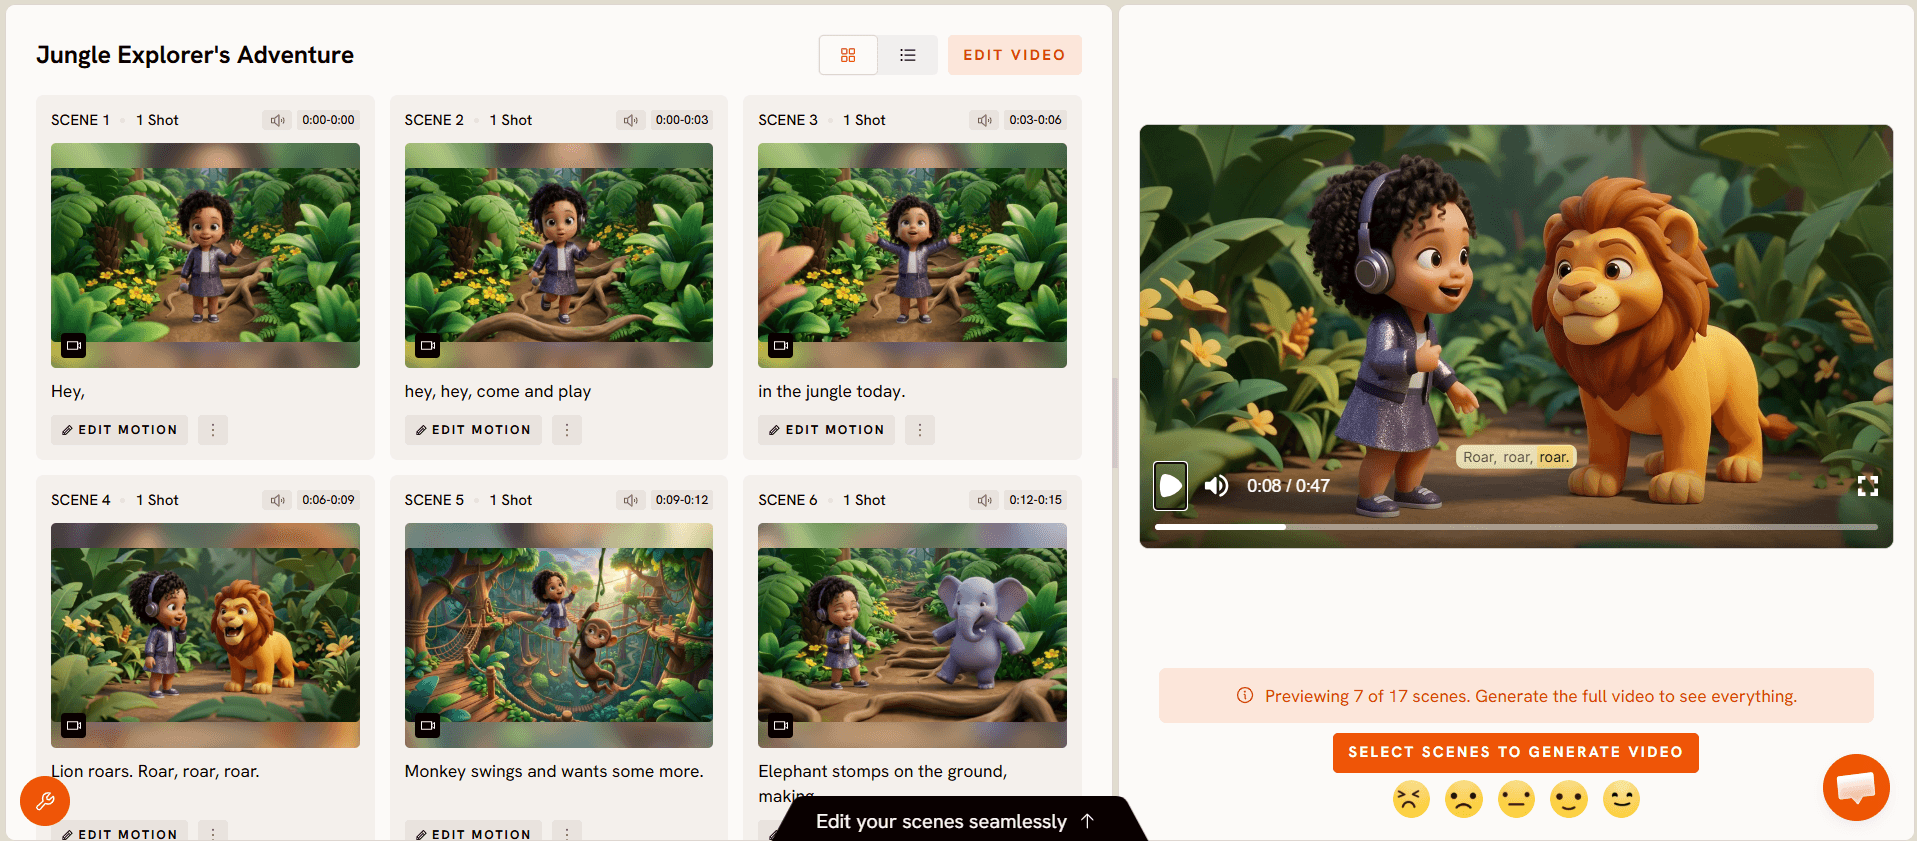
为这类受众写脚本,要懂得克制。每个节拍一个想法,句子要短,关键短语要有意重复。让口型同步的角色念密集的成人句子,做出来的视频技术上可行,却什么也教不了,因为表达的速度超过了听众的接受能力。
多角色口型同步
口型同步现在可以跨多个角色工作,而不再只是一个。
单角色口型同步涵盖了“说话的头像”,而说话的头像只覆盖了人们想制作内容中很窄的一部分。一切对话类内容都在它之外。两个角色你来我往。老师与学生。一次采访。产品讲解中的客户与客服。故事中的家长与孩子。副歌中的一问一答段落。在所有这些场景里,回应与台词同样重要。
用单角色口型同步来制作这些内容,意味着要分别生成每位说话者,再在他们之间来回剪辑。这很慢,更重要的是,它看起来就是这样做出来的。两半画面始终不像在同一个房间里,视线对不上,光线漂移,而对话的时机必须在剪辑中人为制造,而不是由表演而来。任何试过用这种方式伪造两人对话的人都知道,结果读起来就像两段独白并排放在一起。
在同一次生成中处理多位说话者,让对话成为原生输出。对话发生在同一个空间里,同一套光线下,时机属于场景本身,而不是属于你的时间线。
这也是其他三项更新背后的基础能力。一支有非演唱第二主角的选角音乐视频,一旦那个角色需要开口说话,就不再令人信服。一堂有教学角色的课,当第二个角色可以提出课程所要解答的问题时,会好得多。多角色口型同步,正是让这些形式站得住脚的东西。
如何充分利用这些更新
1. 在动笔之前先确定你的角色阵容。 现在谁唱歌、谁出镜、谁说话是三个不同的问题,提前回答它们会改变你的写法。有第二主角的歌曲,需要为这位主角安排可以出现的场景。
2. 认真准备源图片。 正面、光线均匀、每张图只有一张清晰的面孔。在这里多花一分钟,好过事后再去诊断身份漂移。
3. 先用默认模式生成。 场景构图的改进在这里生效,所以你的第一次运行是对这个流程的公平检验,而不是一次配置练习。看过基线效果之后再去调整。
4. 把对话写成交流,而不是两段演讲。 既然现在不止一个角色可以说话,简短交替的台词胜过长篇大论。让第二个角色打断、提问或做出反应。
5. 儿童内容,按节拍写脚本,而不是按页面写。 每个节拍一个想法,重复关键短语,并为角色留出被观看、而不只是被聆听的空间。
示例提示词
1. 完整乐队表演。 一支独立四人乐队在黄昏时分的改造仓库里演出,头顶是串灯,空气中飘着灰尘。在话筒前的主唱、在贝斯指板上移动的双手、后方半明半暗的鼓手,以及带着剪影般小群观众的全场广角镜头之间切换。温暖的实景光线,浅景深,广角镜头带有手持质感。 在 Atlabs 音乐表演中试试这条
2. 浪漫的双主角处理。 蓝调时刻的屋顶,城市的薄雾捕捉着最后的光线。艺人在天际线前演唱,而一个从不唱歌的第二角色穿梭于歌词所描绘的场景之中,坐在护墙上,走过楼梯间,在门口注视着。柔和偏冷的调色,温暖的肤色,全程缓慢运镜。 在 Atlabs 音乐表演中试试这条
3. 独奏乐器特写。 一位演奏者在空旷排练室中的立式钢琴前,晨光透过高窗洒入。在房间全景、手部特写、平视侧面,以及最后一句时缓缓推向面部之间切换。低饱和色调,仅使用自然光。 在 Atlabs 音乐表演中试试这条
4. 教学角色讲解。 一位友善的动画老师在明亮的教室里直接对着镜头讲解冰为什么会浮起来。她举起一杯水,放入一块冰,并在冰块浮起时指向它。句子简短,一次只讲一个想法,结尾重复关键短语。暖色调,背景简洁,没有任何东西与她的脸争夺注意力。 在 Atlabs 儿童表演中试试这条
5. 双角色课程。 一个教学角色和一个好奇的学生,置身于花园之中。学生问树叶为什么会变色,老师用三个简短的步骤作答,学生再把答案复述一遍。两个角色都对着镜头说话,光线和视线保持一致。明亮、柔和的绘本色调。 在 Atlabs 儿童表演中试试这条
在 Atlabs 中运行这些提示词
常见问题
我现在可以在音乐视频中使用自己的脸吗? 可以。音乐表演在流程开始时接受你自己的图片,演唱角色和非演唱角色都可以。
非演唱角色是做什么用的? 任何出现在画面中、但不演唱人声的角色。浪漫主角、故事角色、致敬对象,或者任何其存在对创意重要、而不是对表演重要的人。
改进后的场景构图需要特殊设置吗? 不需要。更丰富的构图、取景和场景类型在默认模式下就适用,所以第一次未经配置的生成就能体现出来。
音乐表演现在能生成哪些类型的镜头? 除了对着镜头演唱,它还能在同一个视频中组合多种场景类型,包括乐器场景和舞台表演。
多角色口型同步有什么用? 任何有不止一个人说话的视频。对话、师生交流、采访,以及一问一答的片段,都可以在一次生成中完成。
用会口型同步的教学角色可以做什么? 概念讲解、自然拼读和字母发音、数数序列、分步骤科学实验、语言学习,以及基于故事的课程。任何由主持人来讲比由旁白来讲效果更好的内容。
这些更新可以配合使用吗? 可以,而这正是大部分价值所在。选角加上多角色口型同步,才能让双主角音乐视频或双角色课程作为一个完整场景站得住脚。
总结
这四项更新的共同主线是:过去在生成之后才做的工作,现在在生成过程中就完成了。镜头多样性曾经是剪辑问题。第二个角色曾经是第二次生成。对话曾经是两个片段剪在一起。选角则根本不存在。
对音乐创作者来说,这意味着一支看起来是剪辑出来而不是生成出来的视频,里面是真正的艺人和歌曲所讲述的真实的人。对教育创作者来说,这意味着一堂有主持人的课,而不是配了旁白的幻灯片。对两者而言,这都意味着需要协调的单独生成更少,接缝暴露的地方也更少。








