Veo 3.1 是目前你能用到的最强大的 AI 视频模型。Reddit 上的创作者和 AI 视频社区一致认为,它在电影级画面、原生音频同步和真实物理表现方面是首选。但每个帖子里都在反复出现同一件事:懂得写提示词的人,得到的结果看起来像专业制作的素材;其他人得到的则看起来像 AI 生成的。
本指南为你提供确切的公式、行之有效的技巧,以及 15 个以上可直接复制使用的提示词。本指南中的每个提示词都经过测试,或来自经过验证的创作者社区。该框架直接源自 Google 官方的 Veo 3.1 提示词文档,以及来自 r/aivideo、r/PromptEngineering 和 X 的社区实测方法。
Veo 3.1 已上线 Atlabs.ai。你不需要 Google Cloud 账号,也不需要 API 访问权限。打开平台,选择模型,粘贴提示词,然后生成即可。本指南中的所有技巧在 Atlabs 中的使用效果与描述完全一致。
在 Atlabs 试用 Veo 3.1: 在 Atlabs 免费试用 Veo 3.1
什么是 Google Veo 3.1,为什么它如此出众
Veo 3.1 是 Google DeepMind 最先进的视频生成模型。 它在 Veo 3 的基础上进一步提升了提示词遵循度、图片生成视频质量,以及更丰富的视听输出。Pocket Entertainment 借助它将用户留存率提升了 30% 到 40%。WPP 认为其首尾帧功能对各类制作的叙事控制具有变革意义。QuickFrame 围绕它构建了整套电视级广告工作流。
它与其他所有视频模型真正的不同之处:
原生音频生成:Veo 3.1 能根据同一个提示词生成同步的语音、环境音、音效和音乐。你描述所听到的内容,它会与画面一同渲染。无需后期音频同步。
物理准确的运动:模型理解物体之间以及物体与环境之间如何相互作用。水遵循重力倾倒,织物随风飘动,双手与物体的互动自然流畅。
超写实叙事:Reddit 上的创作者指出,Veo 3.1 是第一个真正跨越人脸与表演“恐怖谷”的模型。口型同步、微表情和眼神动作都显得真实。
素材生成视频:上传角色、物体、场景或风格的参考图,Veo 3.1 就能在多个镜头之间保持视觉一致性。无需训练自定义模型即可实现角色一致性。
首尾帧控制:提供一张起始图和一张结束图,Veo 3.1 会生成两者之间的过渡,并附带音频。这是目前所有 AI 视频模型中叙事控制能力最强的工具。
支持 16:9 或 9:16 的 1080p 输出,片段时长 4、6 或 8 秒,全部带有同步音频
2026 年 3 月 r/aivideo 的 Reddit 共识:专业组合是用 Nano Banana Pro 制作素材,Veo 3.1 制作主打视频,Runway 处理特定运镜。对于任何需要照片级真实人物表演并带音频的场景,Veo 3.1 都是默认选择。
官方 Veo 3.1 提示词公式(来自 Google 自己的文档)
Google 发布了一个由五部分组成的公式,用来构建 Veo 3.1 提示词。这是整份指南中最重要的内容。其他所有技巧都建立在这个基础之上。
[摄影] + [主体] + [动作] + [环境] + [风格与氛围]
要素 1:摄影(大多数人在这里失手)
这是你首先要写的内容。在其他一切之前,先定义镜头语言。Veo 3.1 会按字面理解结构,也就是说,你最先提到的内容权重最高。
镜头类型:特写、中景、远景、POV 主观视角、双人镜头、过肩镜头
运镜方式:推轨推进、跟拍镜头、手持漂移、摇臂镜头、环绕、固定三脚架、推进
镜头质感:f/1.4 浅景深、超广角 18mm、85mm 人像镜头、变形宽银幕镜头
社区技巧(r/PromptEngineering): 把“camera moves”换成“slow dolly push”或“handheld shoulder cam drift”,画质会立刻不同。泛泛的运动动词没有给模型任何可用的信息。
要素 2:主体
用能锁定身份的具体细节来描述主体:年龄、服装、显著特征、表情、发型。描述越具体,输出越一致。
好的写法:一位 30 岁出头的女性,深色卷发向后扎起,穿着一件磨旧的皮夹克,神情专注
差的写法:一位长发女性
要素 3:动作
不要描述静止的瞬间,而是把动作拆解为递进过程:开始、中间、结束。使用具体的动词。如果有对白,请直接写进提示词中,并标明说话人。
要素 4:环境
设定场景环境:地点、时间、天气、道具、背景元素。要具体。模型会利用环境来推断光线,因此写出真实的光源,效果远好于“戏剧化”这类形容词。
要素 5:风格与氛围
锁定视觉处理方式:胶片类型、调色、情绪、美学参考。Veo 3.1 能理解具体的技术参考,比如 35mm 胶片颗粒、变形宽银幕光晕和低饱和青蓝调色。
完整公式的实际应用(来自 Google Cloud 文档):
中景,一位疲惫的公司职员,在深夜杂乱的办公室里,坐在一台笨重的 1980 年代电脑前,疲惫地揉着太阳穴。暖琥珀色台灯是唯一光源。黑色电影美学,深邃的阴影和清晰可见的胶片颗粒。音频:老式电脑风扇的低沉嗡鸣、远处的打字声、楼下街道传来的模糊车流声。
音频提示:Veo 3.1 最大的竞争优势
没有其他 AI 视频模型能像 Veo 3.1 一样出色地生成同步音频。这是将成品内容与零散片段区分开的功能。大多数用户要么完全跳过音频,要么在结尾随便加一句含糊的说明。下面是真正用好它的方法。
音频层 1:对白
直接把对白写进提示词。清楚标明说话人。包含声音语气、情绪、节奏和语言。不要只写台词,还要写它是怎么被说出来的。
一位中年水手,浓密的灰色胡须,穿着磨旧的海军蓝外套,指向翻涌的灰色大海,用沙哑饱经风霜的嗓音说道:“这片海洋,她是一股力量。狂野而难以驯服。每一次破浪的光芒,都让你心生敬畏。”说话时镜头停留在他饱经风霜的脸上,浅景深将他身后的索具虚化。
专业提示: 加入“沙哑”“带气声”“干脆利落”或“温暖从容”这类声音质感描述,生成的语音明显优于只写台词。
音频层 2:环境音
用描述视觉环境的方式来描述声音环境。环境音会告诉模型这个场景存在于怎样的物理空间。
室内咖啡馆:角落音箱里传来轻柔的爵士乐、咖啡机嘶嘶作响、低语般的交谈声、雨打窗户
城市街道:远处的车流、两个街区外的施工声、一辆正在倒车的送货卡车、鞋踏在湿漉漉的路面上
黎明的森林:鸟鸣由远及近层层叠加、风穿过树叶、附近某处有溪流
空荡的体育场:大空间中空旷的回响、远处空调的嗡嗡声、金属座椅的吱嘎声
音频层 3:音效与音乐
明确描述具体的声音和音乐情绪。Veo 3.1 对精确的提示和更宽泛的情绪描述都有良好响应。
“音效:文件夹砰地合上,一声清脆的响声回荡在空荡的会议室里。”
“克制的钢琴声,几乎听不见,随着门关上渐渐归于寂静。”
“不断攀升的电影感弦乐,在最后 3 秒中不断累积张力。”
“音频:8 位芯片音乐,随屏幕上计时器的节奏跳动。”
来自 Veo 3.1 官方指南:明确定义你想听到的声音,使音频与画面相匹配。尝试把不同的音频创意与画面提示词搭配,创造多感官体验。你可以把音频提示整合进提示词,也可以放在单独的部分。
弱提示词与强提示词:并排对比
普通输出和专业输出之间的差别不在模型,而在提示词。下面是具体的差异。
弱提示词 | 强提示词 |
|
|
弱提示词 | 强提示词 |
|
|
弱提示词 | 强提示词 |
|
|
社区实测过的 9 个提示技巧
技巧 1:写出真实光源,而不是形容词
不要写“戏剧化灯光”,要写出实际的光源。Veo 3.1 会利用具名光源来模拟物理准确的光线表现。
地下停车场里闪烁的荧光灯管
一盏钨丝灯泡的实用台灯,其他灯全部关闭
黄金时刻的光线穿过两栋建筑之间的缝隙,从左侧照在主体上
在一间原本漆黑的房间里,多块显示器屏幕从正面以冷蓝色照亮一张脸
霓虹招牌透过雨痕斑驳的窗户,在天花板上投下流动的色彩
技巧 2:用微动作增强真实感
一个常见的错误是只描述主要动作,而让其他一切保持静止。真实的画面里,次要运动无时无刻不在发生。加入微动作是让输出看起来真实的最快方法。
前景杯中升起热气,而主要动作发生在其后
背景中窗户微微开着,窗帘轻轻晃动
主体眨了一下眼,一个几乎难以察觉的吞咽动作
灰尘颗粒落在投影仪的光束里
树的倒影缓缓划过池塘水面
社区最爱(r/aivideo): 把微动作单独写在提示词末尾:“次要运动:玻璃表面慢慢凝结水汽,烛火在画外某处吹来的气流中微微弯曲。”
技巧 3:胶片类型与美学参考
Veo 3.1 理解具体的摄影术语并能准确应用。使用恰当的参考,会改变整个输出的视觉处理方式。
16mm 胶片拍摄,带有明显颗粒,高光偏暖过曝,阴影略微偏向琥珀色。七十年代中期美国公路电影的美学。
数字电影美学。变形宽银幕镜头,带有标志性的水平镜头光晕。低饱和青蓝调色,黑位略微压暗,高光干净。
VHS 摄像机素材。浓重的色度噪点,水平线上的跟踪伪影,实用光源下略微过曝的白色。
技巧 4:首帧与尾帧控制
这是 Veo 3.1 中最被低估的功能,也是最强大的功能之一。上传一张起始图和一张结束图,Veo 3.1 就会生成过渡,包括音频。WPP 称这项功能对叙事控制具有变革意义。
最佳应用场景:
首帧中一个人在房间的一侧,尾帧中在另一侧。Veo 会生成行走过程以及两者之间发生的一切。
首帧中产品还在包装盒里,尾帧中已开箱并在使用。Veo 会生成揭晓的过程。
首帧是空旷的风景,尾帧是同一处风景在不同季节的样子。Veo 会生成这一转变。
Reddit 高阶用户技巧: 在 Atlabs 上使用 Nano Banana Pro,基于同一个角色参考生成首帧和尾帧,然后将两者一同送入 Veo 3.1。这样一个工作流就能同时获得角色一致性和叙事控制。
技巧 5:用素材生成视频保持角色一致性
Veo 3.1 接受参考图,以在多个镜头之间保持角色、物体或视觉风格的一致性。这相当于无需模型训练的角色选角。
在提示词旁上传你的角色参考图
用与图片中相同的具体细节,用文字描述该角色
生成多个镜头,每个镜头都使用同一张参考图
模型会保留身份、服装、显著特征和艺术风格
技巧 6:POV 与沉浸式镜头
Veo 3.1 处理第一人称 POV 镜头时的真实感,是大多数模型难以复现的。这项技巧在创作者社区中尤其受欢迎,常用于极限运动、探险和产品体验类内容。
第一人称 POV,一位山地自行车手骑行在建于高耸悬崖边缘的狭窄玻璃栈道上,距离地面数千英尺。透明地板下是垂直的深渊。戴着手套的双手紧握车把。镜头随着每一次踩踏微微晃动,以稳定而紧张的速度向前推进。周围的群山和山谷沐浴在金色光线中。音频:呼啸的风声、自行车链条声、轮胎碾过玻璃的声音、混音中隐约可闻的缓慢心跳声。
来源: 社区提示词库(iMyFone/r/aivideo),是最广为分享的、用于沉浸式真实感的 Veo 3 提示词之一。
技巧 7:时间流动,让镜头有开头、中段和结尾
只描述一个瞬间的提示词,得到的是一个凝固的瞬间。描述镜头如何随时间演变的提示词,才能得到连贯的运动。把这 8 秒当作一部短片,而不是一张照片。
远景。黎明时分空荡的屋顶露台。一位 30 多岁的女性推开玻璃门走出来,手里拿着咖啡,还没完全睡醒。她走到栏杆边,望向雾气笼罩的城市。她呼出一口气,肩膀放松下来。雾气微微移动。音频:她的脚步声、身后关门的声音、远处城市苏醒的低沉声响、镜头结尾处开始响起的鸟鸣。
技巧 8:用 JSON 方式处理复杂场景
对于需要精确控制每个组成部分的多元素场景,Artlist 和专业电影制作社区建议将提示词构建为带标签的分段,而不是行云流水的散文。Veo 3.1 会按字面理解带标签的结构。
场景:夜晚的高端钟表精品店,空无一人,仅由展示柜灯光照亮。主体:玻璃柜中旋转天鹅绒垫上的一块 Submariner 风格潜水表。动作:缓慢旋转,8 秒内转 360 度。镜头:固定镜头,从特写到中景,与手表视线齐平,在第 4 秒从表圈轻微转焦至表盘。灯光:展示柜底部的 LED 在表壳边缘投下轮廓光,没有顶部照明。音频:近乎寂静。微弱的机械滴答声。几乎听不见的空调嗡嗡声。风格:商业腕表摄影美学。变形宽银幕镜头压缩感。深邃的黑色。
技巧 9:负向指令
虽然 Veo 3.1 并非在所有实现中都有正式的负向提示词字段,但在提示词文本中加入负向指令能持续改善结果。告诉模型要避免什么。
不要镜头抖动。全程保持平滑、可控的运动。
帧与帧之间主体的服装不要发生变形。
画面中不要出现文字伪影或水印。
除非风格中指定,否则不要过多颗粒。
避免镜头畸变。保持建筑线条干净。
按使用场景分类的 15 个可直接复制的提示词
这些提示词可直接在 Atlabs 的 Veo 3.1 中使用。请根据你的项目调整具体细节(角色细节、产品、地点)。
电影感与叙事
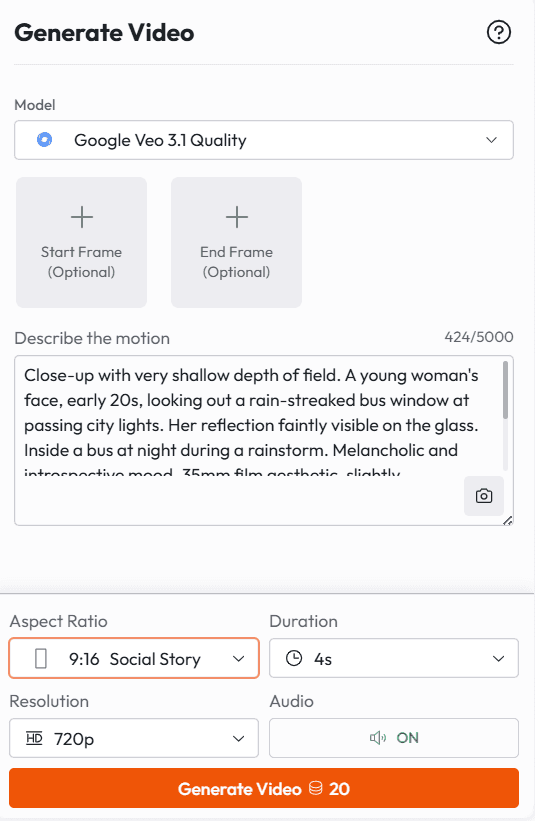
提示词 1:雨景(2026 年 3 月 X 上分享最多)
极浅景深的特写。一位 20 岁出头的年轻女性的脸,望着雨痕斑驳的公交车窗外掠过的城市灯光。她的倒影隐约映在玻璃上。暴雨之夜的公交车内。忧郁而内省的氛围。35mm 胶片美学,略微欠曝。音频:雨打公交车窗、引擎的低沉轰鸣、模糊的城市声响、公交车转弯时轻微的吱嘎声。
提示词 2:清晨的厨房(Reddit r/aivideo)
中远景,固定三脚架。早上 7 点的小公寓厨房,温暖的晨光透过窗户照进来。一位 40 多岁穿 T 恤的男人背对镜头站在台面前倒咖啡。他呼出一口气,肩膀放松。杯中升起热气。没有对白。音频:咖啡倒入的声音、滴滤咖啡机煮完时的咕噜声、窗外的鸟鸣、冰箱的嗡嗡声。
提示词 3:双人对话,紧张
室内,小会议室,下午。荧光灯照明。过肩镜头在桌子两侧的两个人之间交替。[角色 A,克制的声音]:“我审阅了这些数字。全部。”停顿。[角色 B,小心翼翼]:“然后呢?”角色 A 把一个文件夹滑过桌面。[角色 A,轻声]:“然后我们需要谈谈这些数字是从哪里来的。”音频:文件夹滑过桌面的声音、荧光灯微弱的嗡嗡声、背景中的空调声。
提示词 4:孤独与尺度
大范围航拍镜头,极广角。一个身穿红色外套的孤独身影站在广阔的冰冻湖面上,纹丝不动,四周空无一物。阴沉的灰色天空。初冬,还没有下雪,冰刚刚开始在边缘形成。8 秒内缓慢拉远,直到身影几乎看不见。音频:风掠过冰面、远处某处冰层轻微的开裂声、近乎寂静。
产品与商业
提示词 5:奢华产品揭晓(电商社区最爱)
极特写。白色大理石台面上的一瓶奢华护肤精华,晨光从左侧射入。缓慢旋转 360 度。玻璃上的水珠捕捉着光线。在第 5 秒从标签转焦至表面的反光。音频:近乎寂静、瓶子旋转时微弱的声音、房间环境底噪。
提示词 6:带对白的产品广告
中景,专业摄影棚灯光,窗户方向有暖色补光。一位身穿海军蓝西装外套的女性,直视镜头,自然从容。[说话人,温暖而自信的声音]:“这就是我每天早上都在用的那一款。而且我什么都试过。”说完这句话时,她举起产品。淡淡的微笑。音频:房间环境底噪、结尾处产品被放在桌上的声音。
提示词 7:球鞋发售
一位身穿灰色连帽衫的男人走进灯光明亮的球鞋店,播放着轻快的 lo-fi 嘻哈。镜头从背后跟着他走向一个展示台。他拿起一只鞋,缓缓翻转过来。特写他的表情:专注、认可。切至远景。文字:“Drop Coming Soon”以干净的白色无衬线字体在画面底部淡入。音频:店内环境声、背景中的 lo-fi 音乐、他的脚步声。
社交媒体与爆款内容
提示词 8:爆款理财钩子
特写一位饱经风霜的 50 多岁男人,夜晚坐在雨痕斑驳的窗边。窗外柔和而忧郁的光线投下深深的阴影。他直视镜头,开口前刻意停顿。[说话人,缓慢沙哑的声音]:“我创造过一些东西,也眼看着它们崩塌。但有一件事永远不会失败?在对的时间做对的事。”窗外细雨轻柔。浅景深。音频:雨打玻璃、远处低沉的雷声、除了他的声音,房间里一片寂静。
提示词 9:家庭喜剧时刻(分享最多的喜剧格式,社区来源)
远景,自然的居家光线。客厅,周末早晨。一位婴儿潮一代的爸爸正试图在智能手机上打字,一指禅式地戳着屏幕,眉头紧皱。他成年的女儿坐在沙发上看着。[女儿,耐心却忍俊不禁]:“爸,发短信的时候你不用把‘句号’念出声来。”他抬起头。[爸爸,真心困惑]:“可它怎么知道呢?”音频:背景中低声播放的早间电视、他敲击键盘的声音。
提示词 10:体育热血
低角度镜头,手持并带有轻微摇晃。美式橄榄球球员通道,光线昏暗,远处观众声逐渐增强。全副装备的球员们朝着通道出口的光亮移动。慢动作从第 4 秒开始。镜头在脚踝高度跟拍,随着球队加速而升起。[队长,有力的声音,在观众噪音下几乎听不清]:“就是现在。”当他们冲入光亮的那一刻,观众沸腾。音频:不断升级的观众吼声、沉重的脚步声、装备碰撞声、他们现身瞬间涌起的管弦乐。
抽象与艺术
提示词 11:晶体景观(来自 Google DeepMind 官方示例)
暮色天空下,一片覆盖着积雪的虹彩月尘平原。三十英尺高的晶体花朵绽放,将光线折射成缓缓移动的彩虹。一个身披毛皮斗篷的身影在这些巨大的花朵之间行走,在未被触碰的尘埃上留下唯一的脚印。镜头:缓慢向前推进,低角度,仰望天空映衬下的花朵。音频:风穿过晶体结构,发出和谐的音调,脚步的嘎吱声,其下是广阔的寂静。
提示词 12:糖果键盘
特写一个由各种糖果制成按键的键盘:软糖按键、冰糖、糖片空格键。一根手指按下一个小熊软糖按键。按键微微下陷。极致微距拍摄,浅景深。音频:每次按键发出酥脆、甜腻的声音,画外某处传来一声愉快的咯咯笑。
商务与专业
提示词 13:公司演示
平视中景,专业风格。一位 30 多岁、身着商务休闲装的女性站在现代开放式办公室的站立式办公桌前。她看向镜头,清晰地说话。[说话人,温暖专业的语气]:“本季度收入增长了。并不是因为某一件事。而是因为
我们六个月前做出的所有改变。”她身后是虚化的玻璃墙办公室和自然的窗光。音频:低沉的办公室环境声,前景中她清晰的声音。
提示词 14:讲解视觉
房屋的剖面图,展示热量如何通过窗户、墙壁和屋顶流失。带有热成像效果和按颜色编码的温度区域:深蓝色代表室外寒冷,橙色和红色代表温暖的室内,黄绿色代表边界处。动画箭头指示每个表面的热量流失模式。镜头从左到右缓慢而有条不紊地移动,依次讲解每个区域。教育纪录片美学。音频:可使用平静的旁白语气但不写具体台词,纪录片式的环境配乐。
提示词 15:会议室揭晓
远景然后推进至中景。一间玻璃墙会议室,高管团队就座,主位上有一个空座。门打开了。走进来的人没有被描述。他们坐下。房间里一片寂静。[在座的高管,沉稳的声音]:“我们一直在等你。”推进镜头继续缓缓朝主位推近。新来的人双手平放在桌面上。[新来者,安静而笃定]:“我知道。”音频:开门声、脚步声、拉开椅子的声音、台词之间一片死寂。
如何在 Atlabs 上使用 Veo 3.1
Veo 3.1 在 Atlabs 的 Pro 套餐及以上可用。Pro 套餐每月 29 美元,可使用平台上全部 100 多个模型,包括 Veo 3.1、Kling 2.1 Master、Sora 2、Runway、Hailou 2.3、Flux Kontext 等。具体工作流如下:
登录你在 atlabs.ai 的 Atlabs 账号
新建项目,或进入视频生成工作区
在模型选择面板中选择 Google Veo 3.1
使用本指南中的公式和技巧输入你的提示词
设置输出格式:YouTube 和标准视频用 16:9,TikTok 和 Instagram Reels 用 9:16
设置片段时长:4、6 或 8 秒
生成你的第一个片段,然后进行优化。每次只修改一个要素。
使用“素材生成视频”功能,在提示词旁上传参考图以保持角色一致性
Atlabs 相比单独使用 Veo 的优势: 你可以在完整的制作工作流中使用 Veo 3.1。也就是说,你可以从图片生成(Nano Banana Pro)到视频生成(Veo 3.1),再到口型同步(Sync 2.0、Omnihuman),最后到成品导出,全部在同一个平台内完成。无需 API 密钥,无需额外订阅,无需把各个环节拼凑在一起。
在 Atlabs 上使用 Veo 3.1: 在 Atlabs 免费试用 Veo 3.1
常见错误及解决方法
错误 | 为什么会失败 | 解决方法 |
“一个人走在街上” | 没有镜头、没有环境、没有音频、没有风格。模型只能随机填充。 | 添加镜头类型、运动方式、光源、音频和美学参考。 |
写了对白却没有声音指导 | 音频会合成缺乏个性的通用语气。 | 为每一句台词添加“沙哑而疲惫”“干脆利落而专业”或“温暖从容”等描述。 |
在一个镜头里堆叠过多主要动作 | 8 秒容纳不下 3 个完整动作,输出会变得混乱。 | 只选一个主要动作,用微动作增添生气,把其他动作留给单独的片段。 |
只用形容词描述灯光 | 模型没有任何可供物理模拟的依据。 | 写出真实光源:“舞台左侧的单个 LED 灯板”,而不是“戏剧化灯光”。 |
完全忽略音频 | 输出没有音频,或是随机生成的声音。 | 始终至少加入一条音频说明,哪怕只是环境音。Veo 3.1 的音频是一项竞争优势。 |
主体描述含糊 | 角色在每次生成中长得都不一样。 | 描述 5 个以上具体的外貌细节。配合参考图使用“素材生成视频”。 |
期望 8 秒内持续不断地运动 | 迫使模型用没有动机的运动来填满时间。 | 在镜头设计中留出静止。带有微动作的静态瞬间,往往比持续运动更显专业。 |








