
GPT Image 2.5 并不是单一模型,而是两个模型。OpenAI 于 2026 年 9 月 8 日发布了它,作为 GPT Image 2 的后续版本,但他们没有只发布一个更新版本,而是把它拆分成了一个小型的、速度优化的模型 Flare,以及一个更大的、质量优化的模型 Sunburst。两者都可以通过 ChatGPT、ChatGPT Work、Codex 使用,也可以直接通过 API 调用,模型名称分别为 gpt-image-2.5-flare 和 gpt-image-2.5-sunburst.
之所以拆分,是因为速度和成品精致度往往朝着不同方向拉扯,而 OpenAI 决定让用户自己选择,而不是在两者之间折中。Flare 的渲染速度足以让快速迭代变得可行,在过去用 GPT Image 2 生成一张图的时间里,可以针对一份需求测试五六个方向。Sunburst 耗时更长,但在细节、质感和多次编辑间的一致性上做得更到位,其输出经得起近距离检查或大幅裁切。两者都不是通常意义上的精简版或高级版。它们是对两个不同问题的两种回答,一个问的是能多快探索多少个方向,另一个问的是选定的单个方向能被打磨到多好。
ChatGPT 和 Codex 默认到底运行哪一个,OpenAI 并没有明确说明,不过测试表明两者背后用的都是 Flare。到了 API 这里,选择才变得明确,因为开发者按名称调用某个模型,就清楚地知道是哪一个在生成结果,而且在这一选择之上还有一个独立的质量设置,用于控制单次生成所花费的时间和细节。
快速对比:在哪里运行 GPT Image 2.5
平台 | 最适合 | 核心优势 | 权衡取舍 |
Atlabs | 在运行 GPT Image Gen 的同时使用 50 多个其他模型,然后直接进入视频制作 | 一个账号即可涵盖图像生成、编辑,以及直通 Atlabs 视频项目的路径 | 模型版本和质量档位由平台设定,而不是按每次调用自行选择 |
ChatGPT | 在现有对话中随手生成 | 无需设置,已内置图像生成,另有草图和模板工具 | 运行的是 OpenAI 默认的版本和质量,无法手动覆盖 |
直接调用 API | 需要明确控制的开发者 |
| 需要自行集成并设置计费 |
按此顺序选择模型
决策其实比每次都从头测试两个模型要简单。如果现有的 GPT Image 2 工作流已经能产出可接受的结果,就在 Flare 上使用相同的提示词、相同的尺寸和相同的质量设置开始,并把质量设置明确指定,而不是留在自动。如果通过,延迟的改善就是白赚的,其他什么都不用改。如果 GPT Image 2 本来就无法满足这项工作的要求,那就改为从 Sunburst 开始,先在那里把输出调到可接受的程度,然后用相同的输入在 Flare 上运行,只有当它依然站得住脚时才切换过去。
公平对比有两点很重要。第一,永远不要在自动质量下做对比,因为“high”在两个模型上的校准方式并不相同,在评判任何东西之前先手动设定。第二,一次只调整一个变量:先尝试更高一档的质量,再去改写提示词本身,只有当较低档位确实未能满足这项具体工作中重要的某项要求时,才去用 high 或 max,而不要把它当作默认起点。
按模型和质量档位划分的生成时间
来自一轮测试的真实数据,相同提示词,宽度 1024 像素:
模型 | 编辑轮次(medium 质量) | 文字生成图像(high 质量) |
GPT Image 2 | 37 至 55 秒 | 177 秒 |
GPT Image 2.5 Flare | 19 至 27 秒 | 22 秒 |
GPT Image 2.5 Sunburst | 17 至 41 秒 | 48 秒 |
在同一轮测试中,Sunburst 在 max 质量下生成一张竖版图像耗时 115 秒,这一点值得在每次生成都习惯性选用最高质量档位之前留意。
有效图像尺寸
GPT Image 2.5 接受从 1024 正方形到长边 3840 的尺寸,两条边都必须是 16 的倍数,宽高比不得宽于 3 比 1。总像素数需介于 655,360 和 8,294,400 之间,任何高于 2560x1440 的尺寸都被标记为实验性,而非完全支持。可稳定使用的常见尺寸包括 1024x1024、1536x1024、1024x1536、2048x2048、2048x1152、3840x2160 和 2160x3840。
同一提示词下的 Flare 与 Sunburst:两轮示例
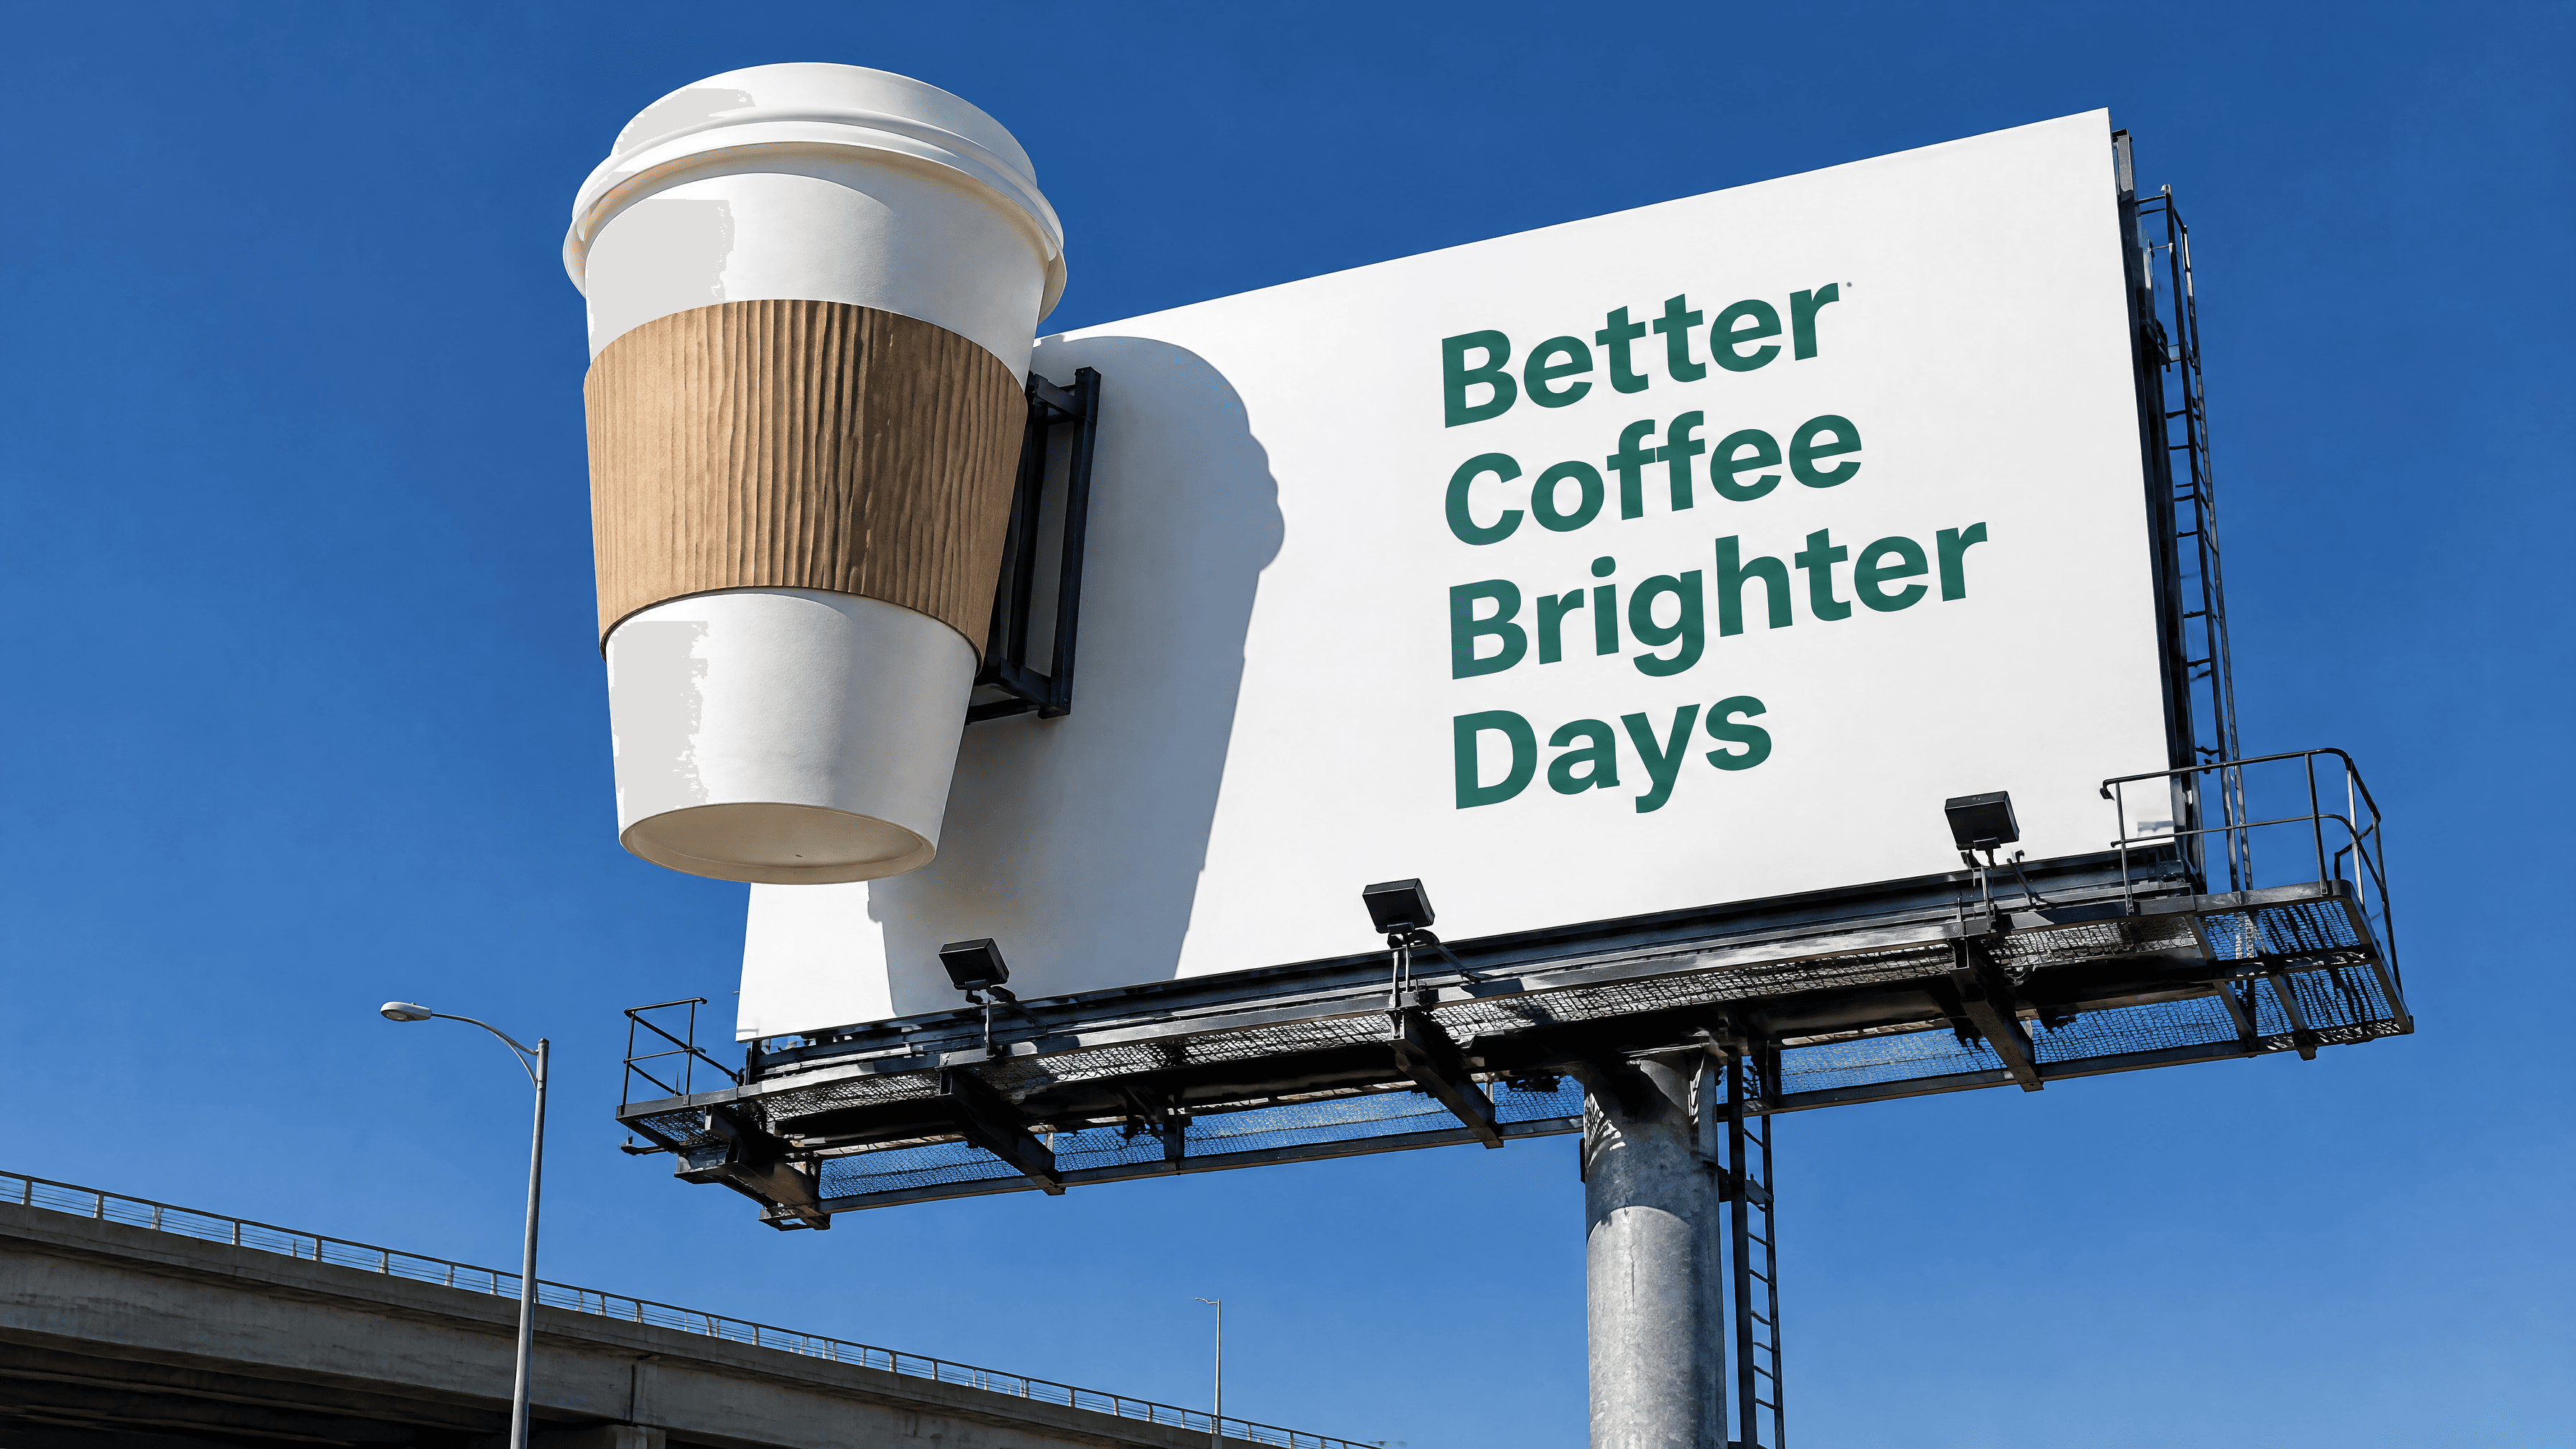
这里的优化方法很简单:生成一次,检查结果,把它传回去并且只做一处改动,然后每一轮都重复所有重要的约束条件,而不是假定它们会自动延续。这个示例改编自 OpenAI 在 GPT Image 2.5 提示指南中公布的广告牌样机方法,在 Flare 和 Sunburst 上并排运行,用一罐饮料代替了他们原本的产品照片。
写实风格的低角度镜头,拍摄一块立在路边的大型广告牌,背景是晴朗的深蓝色天空,从地面向上仰拍。一个巨大的纯白外带咖啡杯,纸面光滑空白,哑光质感,白色圆顶杯盖,配一个没有任何标志、印刷或标记的纯牛皮纸棕色波纹杯套,作为超大的 3D 延伸造型从广告牌左边缘探出,由一个黑色钢支架悬臂支撑,向前伸出画面之外。广告牌面板为白色,右侧印有醒目的深绿色无衬线字体文案。底部沿着一条带护栏和梯子的钢制检修走道,聚光灯朝上照向牌面,由一根镀锌钢柱支撑整个结构。远处低处是混凝土立交桥和一盏路灯。正午明亮的阳光,硬质方向光把杯子的影子投在广告牌面上,阴影清晰,画面通透,商业户外广告样机摄影,24mm 广角,全画幅单反拍摄,高细节,4K。
Flare:
Sunburst:
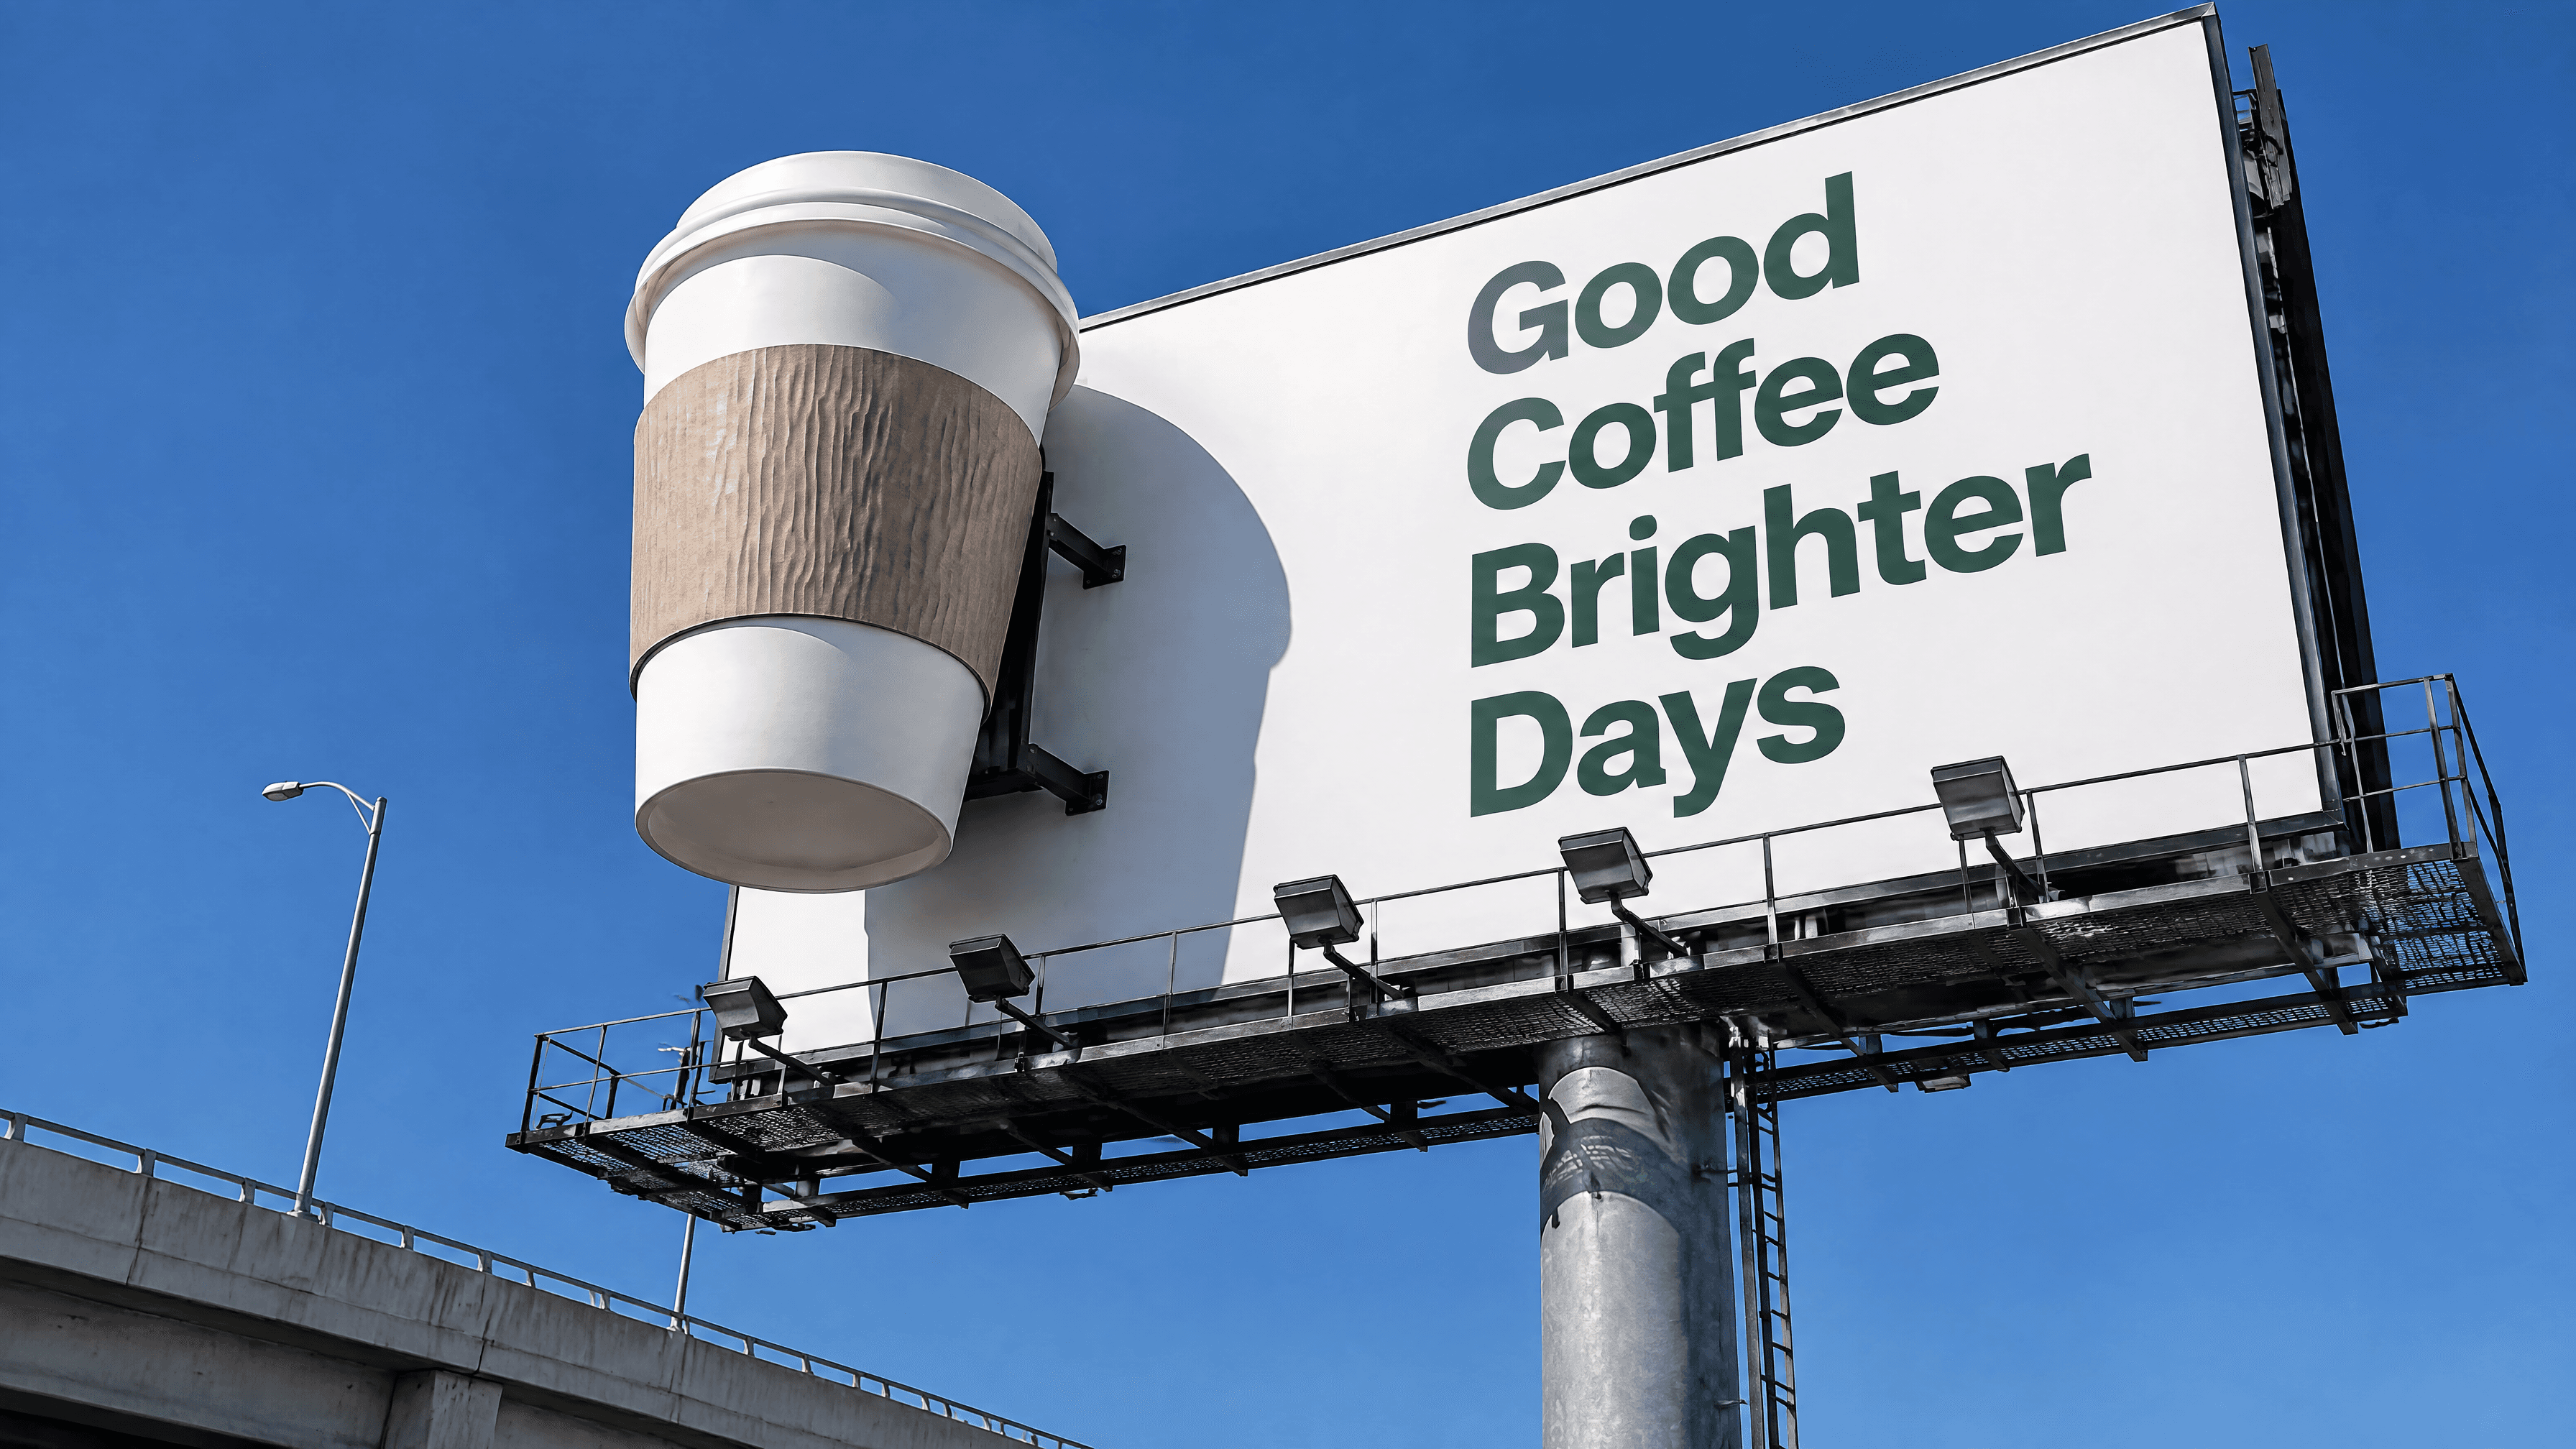
在你自己的产品照片上运行这一对提示词,是直接看到 Flare 与 Sunburst 差距的最快方式,而不是凭空相信耗时数据。换上手边的任何产品照片,保持两轮结构,并比较两个模型如何处理完全相同的广告牌文案和同样的天气变化。
从水果内部拍摄:极端第一人称视角机位
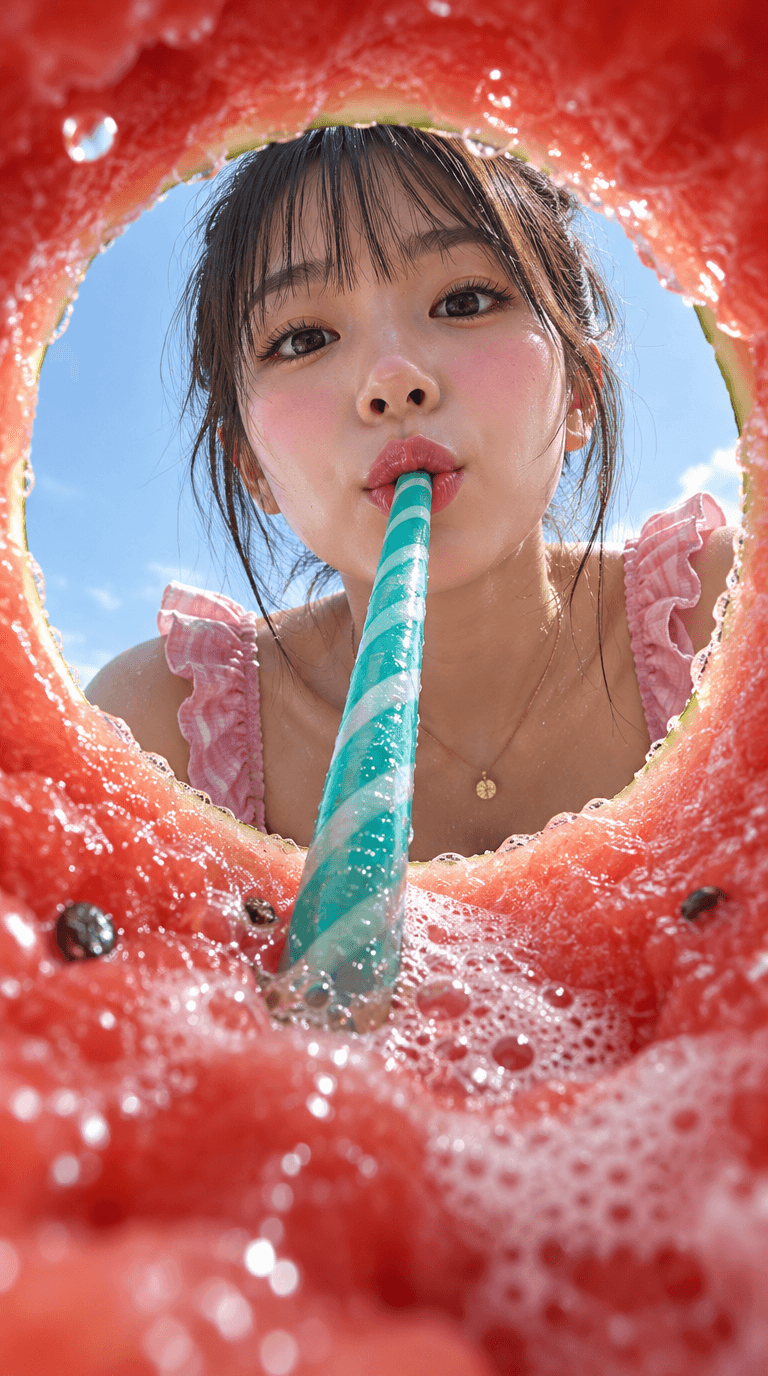
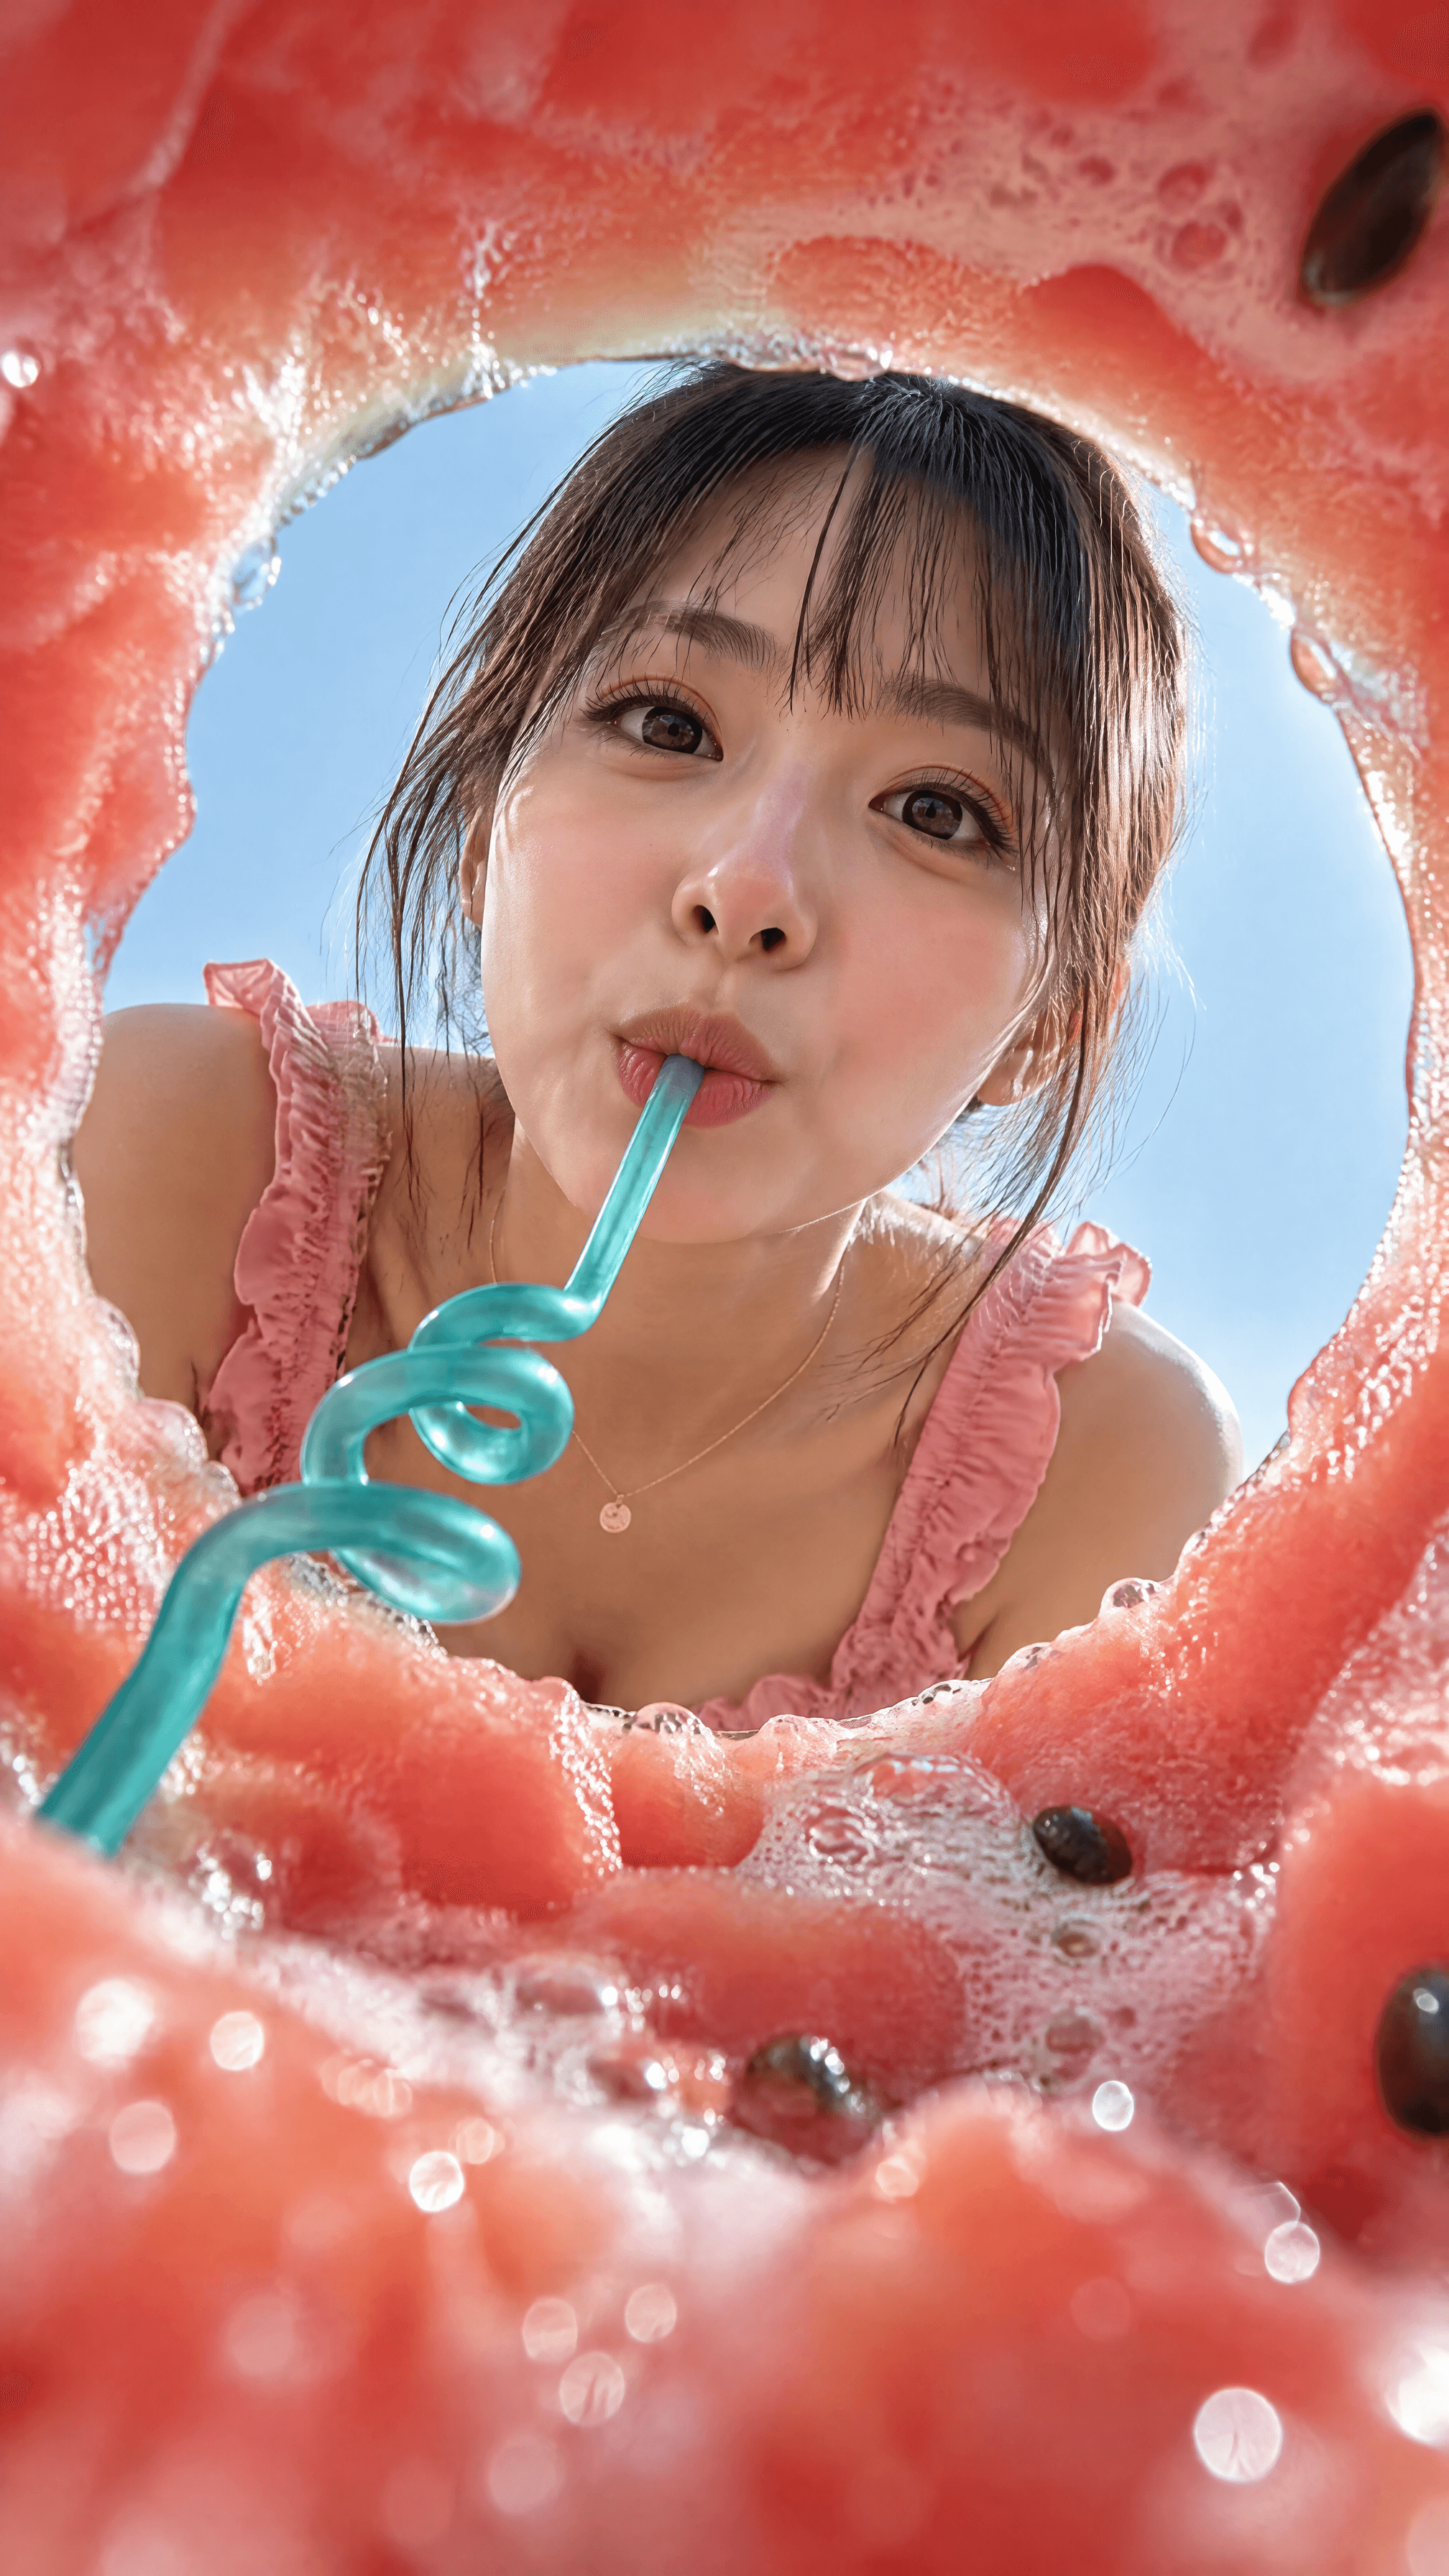
大多数提示词会把相机放在人自然站立的位置。当你把它放到相机本不该出现的地方,比如挖空的西瓜里、玻璃杯下、被吃的东西后面时,有趣的结果才开始出现。主体几乎没变,变的是前景成了画框,尺度被颠倒,一张普通的夏日肖像变成了需要看两眼的画面。下面是围绕同一个想法的两次尝试,测试仅靠镜头位置能承载多少画面效果。
挖空西瓜内部的鱼眼第一人称视角,透过一个圆形孔洞向上看,一位留着刘海的年轻东亚女性低头凝视,正啜饮插在水果里的青绿色螺旋吸管。湿润的粉色西瓜果肉和白色泡沫气泡沿着画面边缘弯曲环绕,前景虚化。透过孔洞可以看到她身后淡蓝色的天空。她穿着粉色荷叶边上衣,戴着细金项链,柔和的自然阳光,光泽高光,对焦清晰落在她的脸上。竖版 9:16,超写实微距美食摄影,饱和的珊瑚粉与青绿色调,浅景深,8k 细节。
flare:
sunburn:
跨场景保持同一个角色:提灯狐狸 Juniper
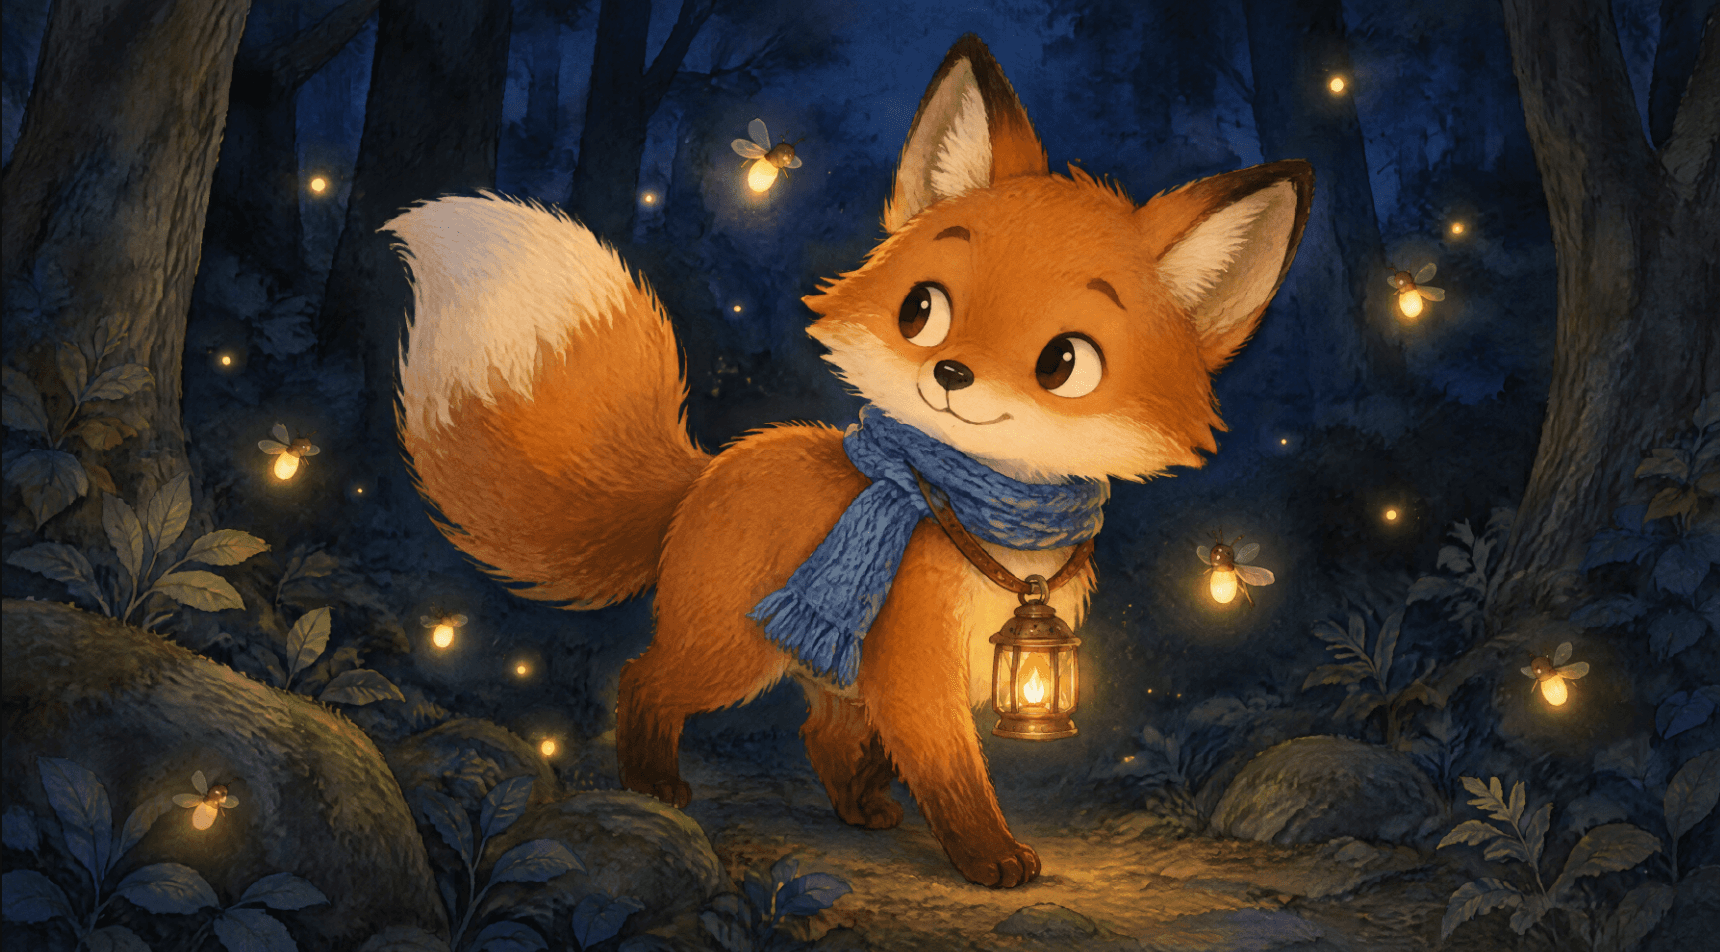
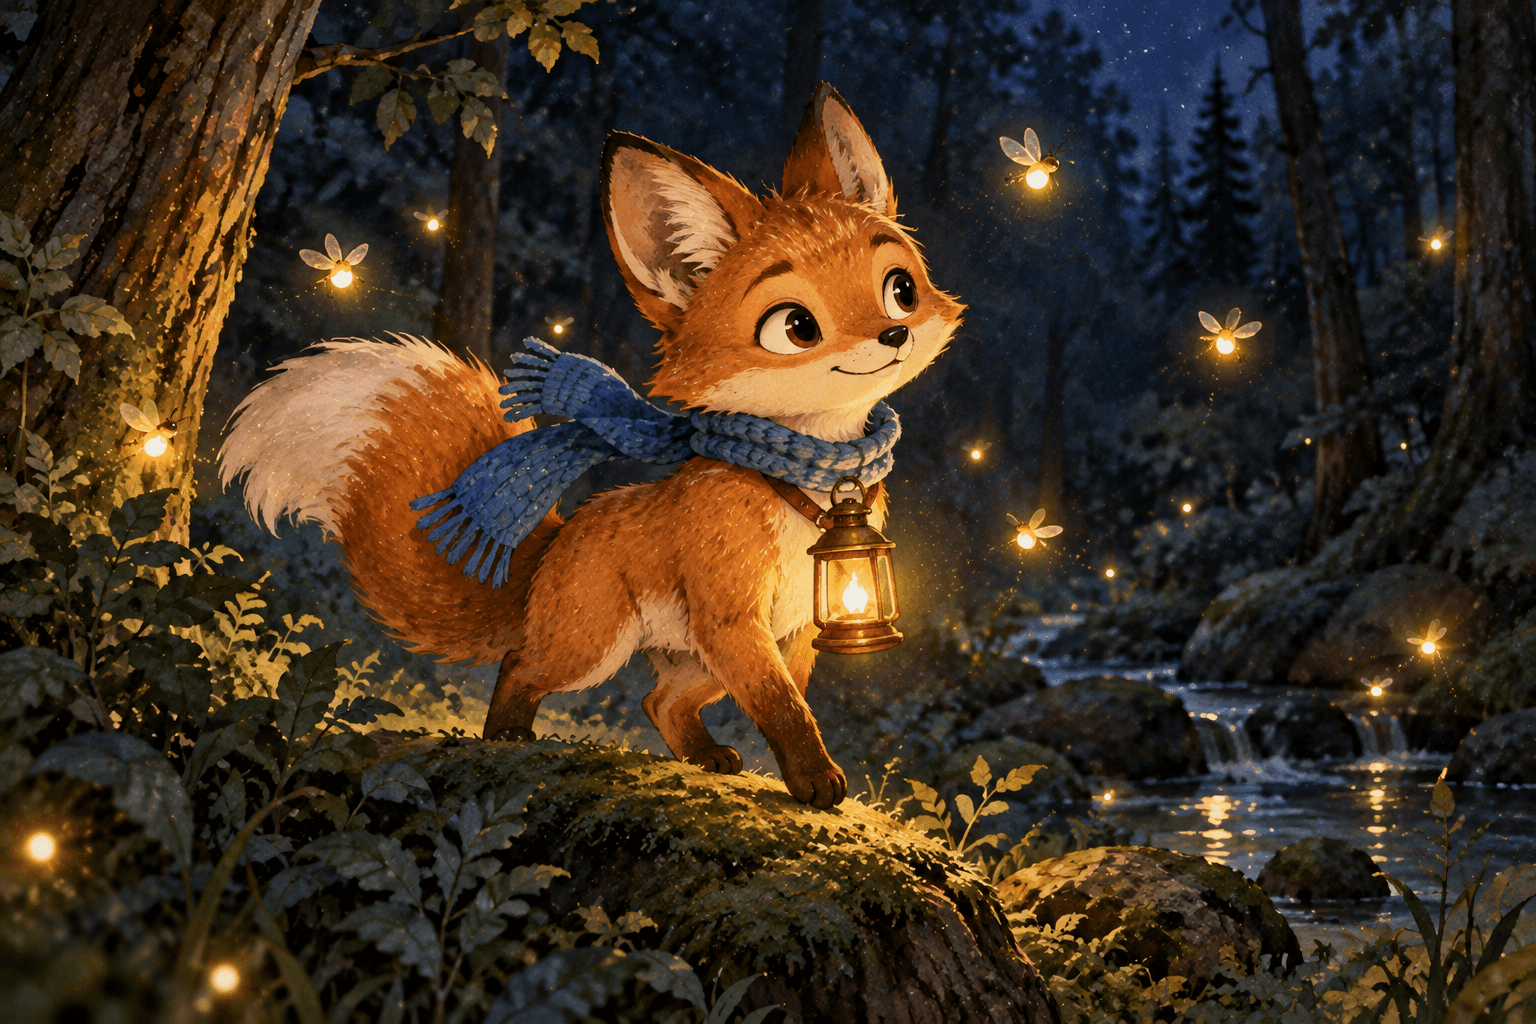
角色一致性始于一次完整指定的生成,而不是在不同提示词中重复的松散描述。然后,这张单独的图像会在之后的每个场景中被传回去,并且每次都重新写明它的标志性细节。这里把同样的“先生成再延续”方法应用到一个原创角色上,而不是借用的示例。
确立角色。 生成模式,1024x1536,medium 质量。
创作一幅儿童绘本插画,介绍一位主角。角色:Juniper,一只小小的提灯狐狸,有着铜橙色的毛发和蓬松的白尖尾巴,脖子上用皮带挂着一盏小小的黄铜提灯,围着一条针织蓝围巾。她有一双圆圆的好奇眼睛,笑容温柔而调皮。主题:Juniper 在夜晚的森林里游荡,引导迷路的萤火虫安全回到它们发光的草地。风格:儿童绘本插画,手绘水彩质感,柔和的轮廓线,温暖的夜间色调,深蓝与提灯金色,奇幻而温馨,比例适合绘本。约束:原创角色,不含受版权保护的角色,无文字,无水印,背景为夜晚的纯暗森林,以清晰突出角色。
Flare:
Sunburst:
电影感肖像,沉郁而强烈
类型: 写实肖像。 氛围: 戏剧性的电影剧照。 情绪: 紧张、阴郁。
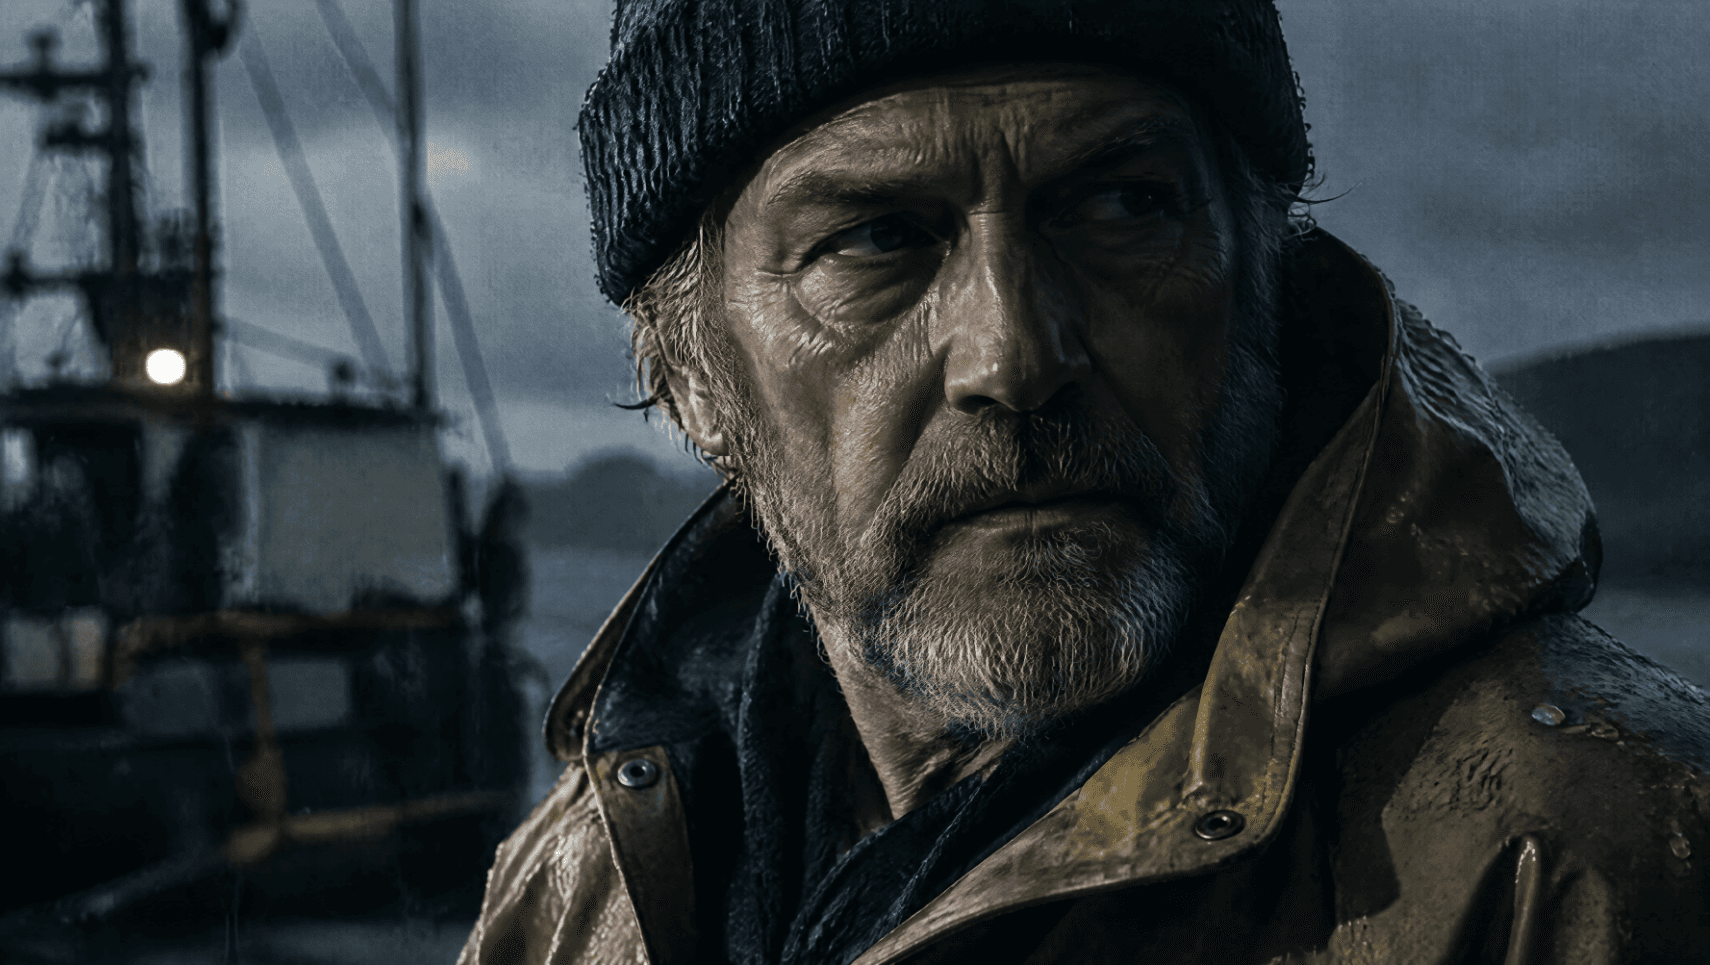
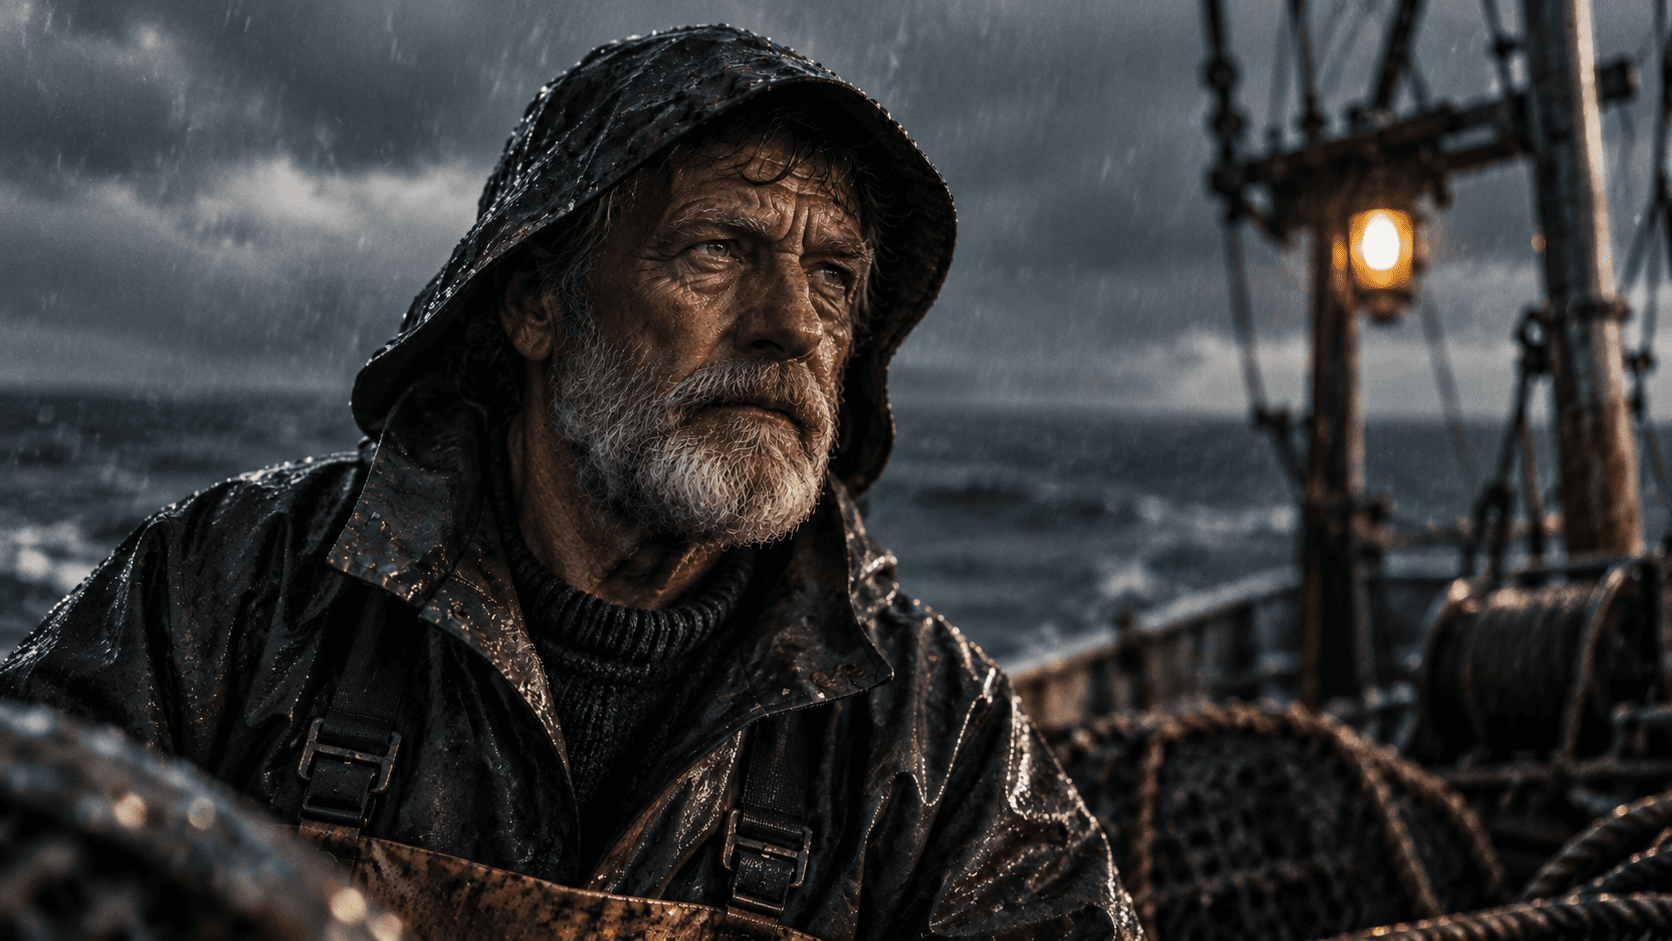
一幅写实风格的特写肖像,主角是一位六十多岁饱经风霜的渔夫,深陷的眼睛凝视着镜头之外,穿着被雨水浸透的油布夹克,单一的硬质侧光在他脸上刻出深深的阴影,灰色与藏青色的低饱和调色,看起来像用 35mm 胶片拍摄,带有可见的颗粒,浅景深,电影感而沉郁。
Flare:
Sunburst:
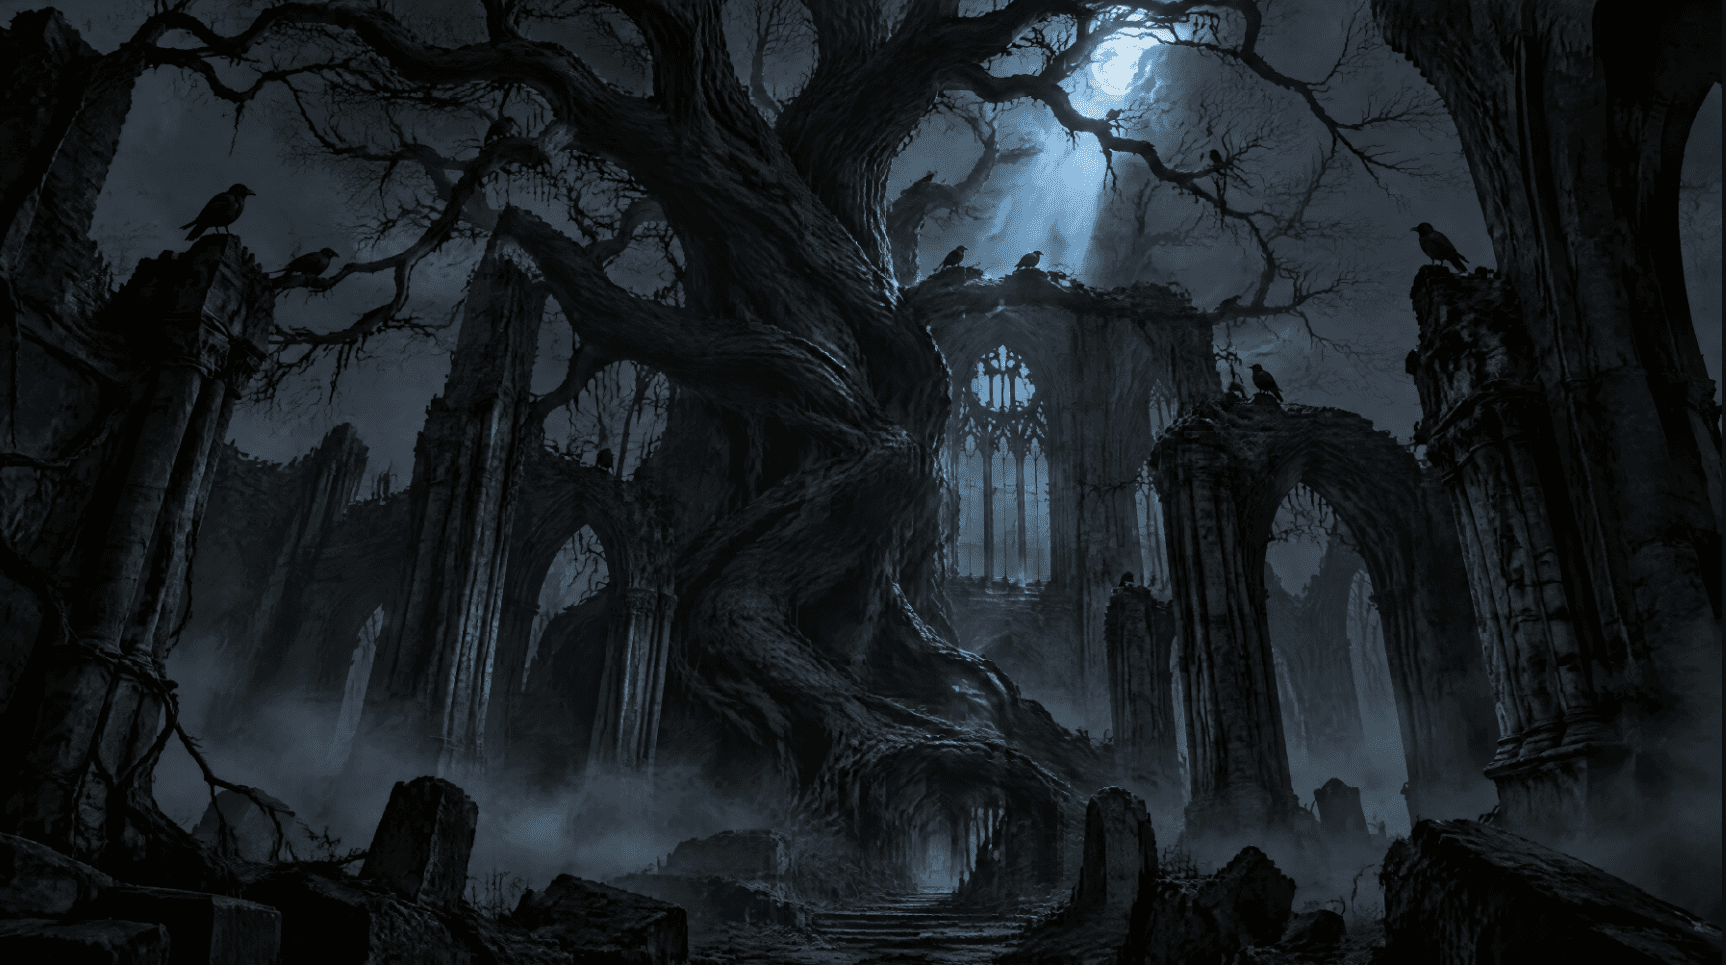
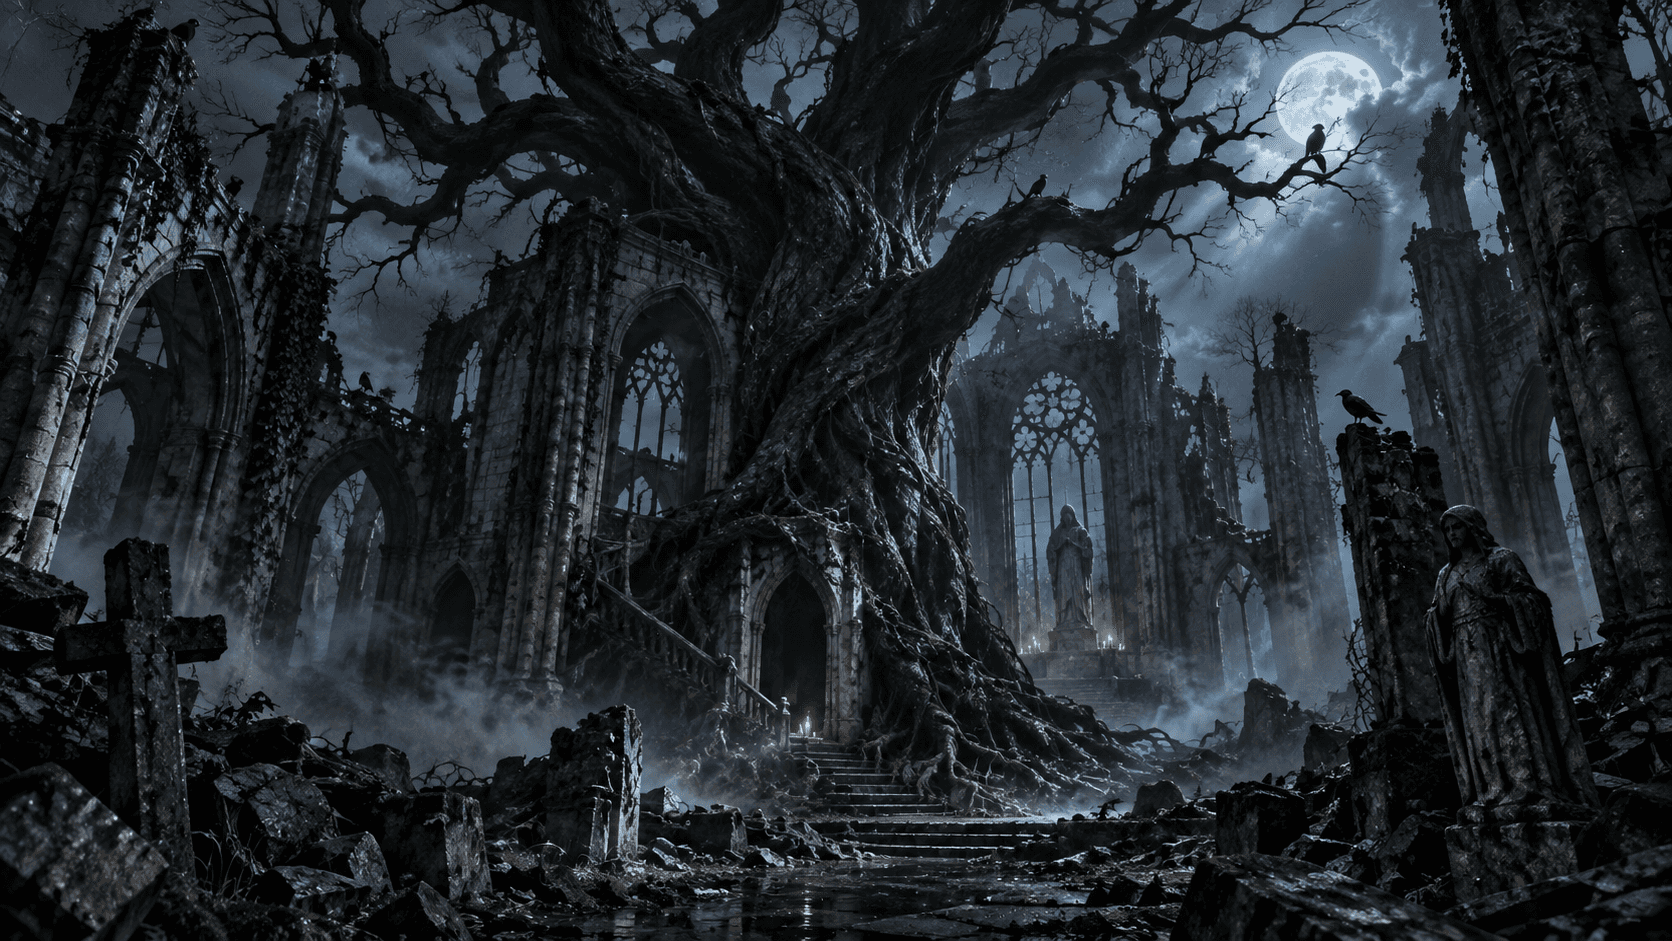
黑暗奇幻概念艺术,诡异而不祥
类型:奇幻概念艺术。氛围:哥特、令人不安。情绪:不祥、神秘。
概念艺术:一棵巨大扭曲的黑色树木从废弃大教堂的废墟中生长出来,薄雾缭绕在断裂的石柱周围,一缕冷蓝色的月光穿过上方的树冠,乌鸦静静栖息在骨架般的枝条上,除月光外整体为低饱和度的暗淡色调,高细节数字绘画,诡异而不祥的氛围。
Flare:
Sunburst:
复古旅行海报,温暖而怀旧
类型:复古插画海报。氛围:二十世纪中叶旅游广告。情绪:惆怅、温暖。
一幅 1960 年代风格的复古旅行海报插画,描绘黄金时刻的海岸悬崖小镇,下方平静的海湾里点缀着帆船,温暖的赭石色和赤陶色屋顶,构图上带有手绘字体的感觉,但没有可读文字,墨迹略带褪色的质感,大胆的平涂色块,是二十世纪中叶旅游广告的典型风格,温暖而怀旧的情绪。
Flare:
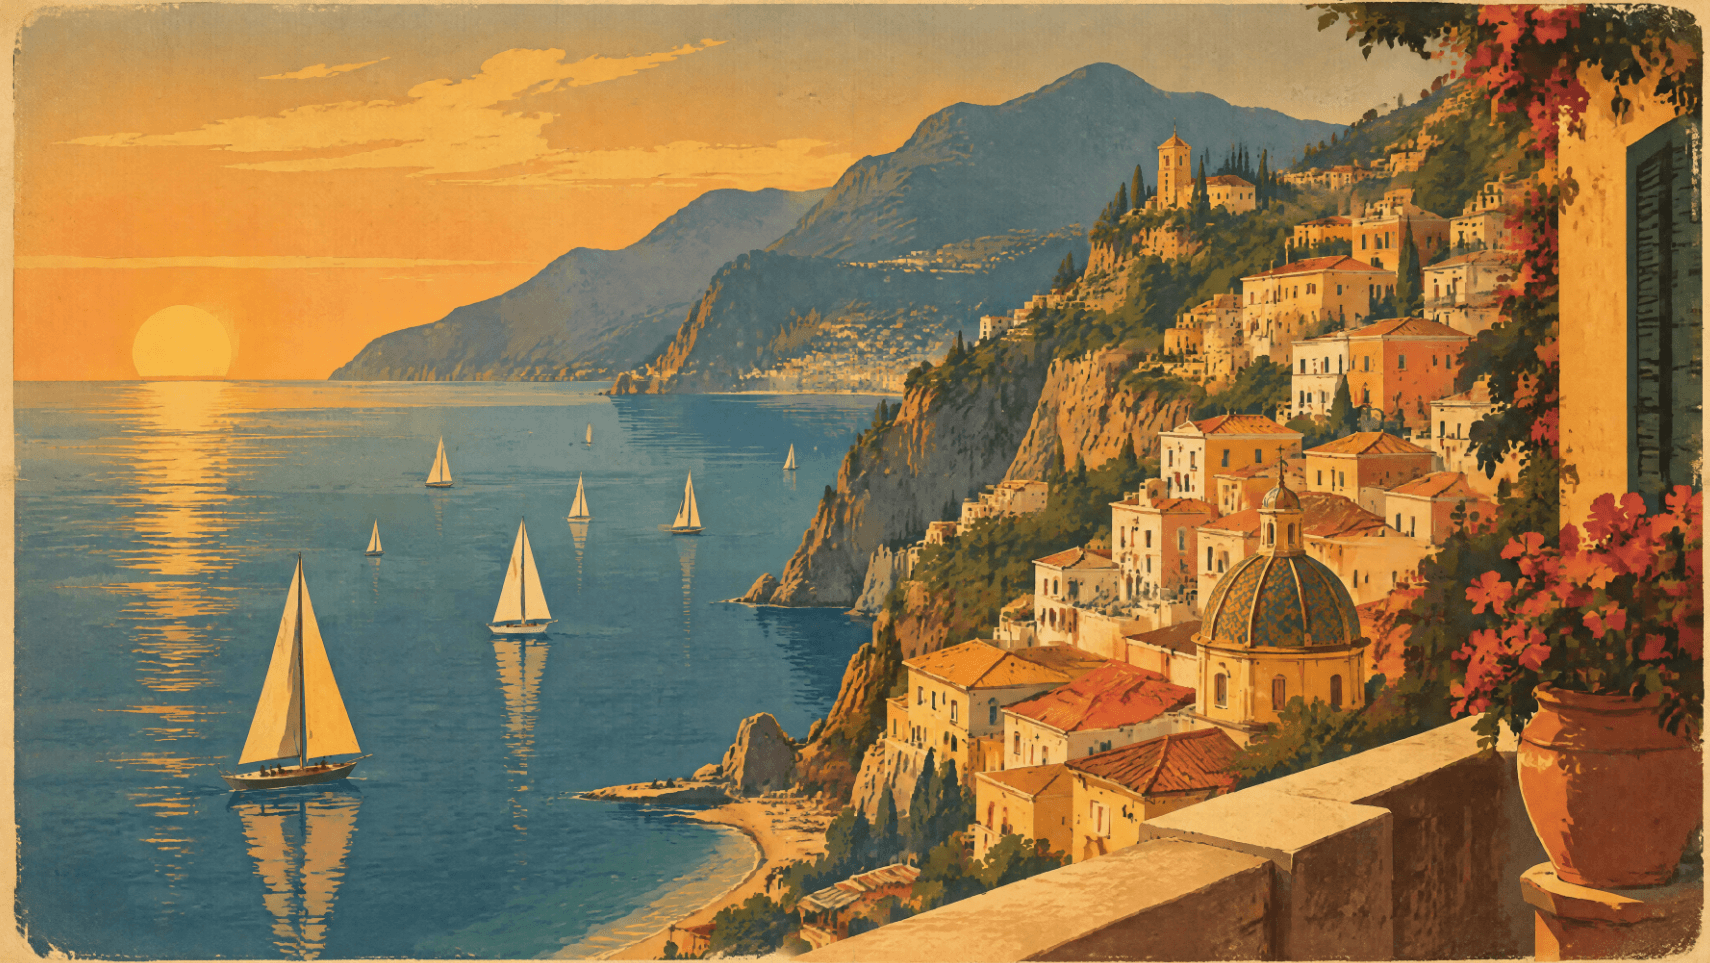
Sunburst:
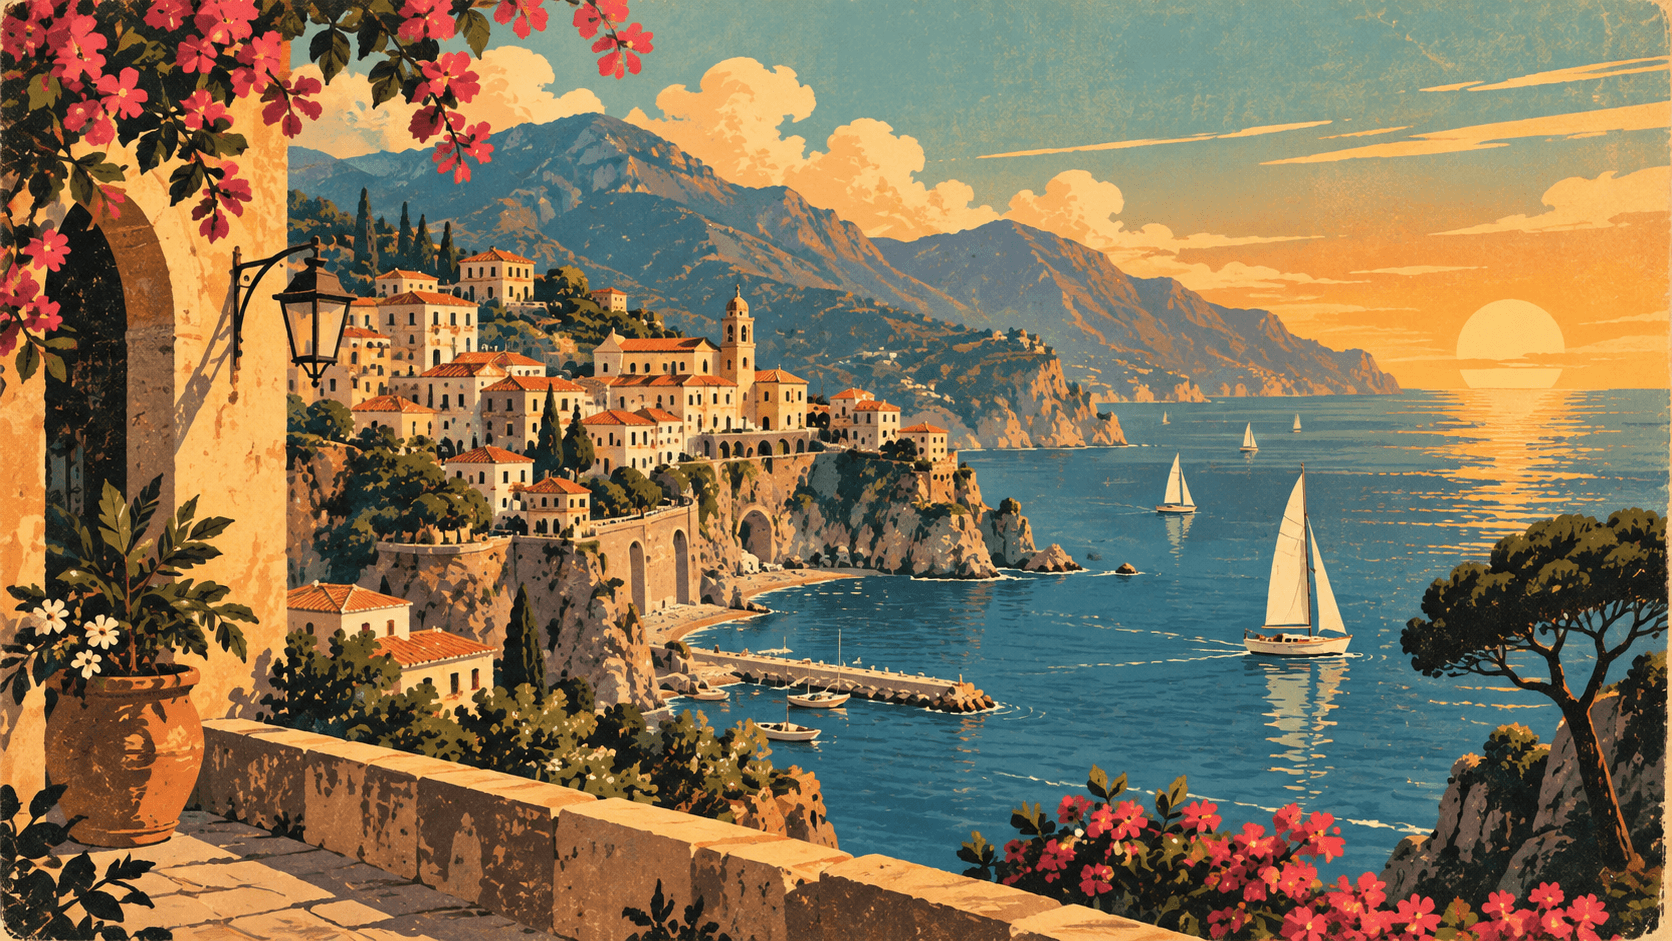
更进一步:16 格参考图表
这种方法有一个已有记录的延伸做法,完全跳过单张肖像参考图。取而代之的是,先生成一个 4 乘 4 的网格,共十六个格子,展示同一个原创角色的正面、背面和侧面视图、四种表情、四种姿势以及四张特写细节裁切,全部置于纯白背景之上。这张图表随后成为之后附加到每个场景提示词上的唯一参考图,同时附上一行重复标志性细节的文字,写明需要匹配的确切夹克颜色、靴子颜色、面部和发型。在那一轮测试中,在 GPT Image 2 和 Sunburst 上生成的六个不同场景,每次返回的脸、夹克和靴子都保持一致,无需重新抽卡。
有一个细节值得原样保留:让参考图表自身的背景保持纯白。图表上带有风格或光照的背景,往往会把它自己的光线渗透到之后据此生成的每个场景中,破坏这张图表原本要锁定的一致性。
为什么 GPT Image 2.5 处理指令的方式与 Midjourney 不同
在决定它是否适合某项工作之前,值得先了解:GPT Image 2.5 会对提示词中的字面指令进行推理,而不是纯粹依赖在图像数据集上训练的扩散模型。让它把酒杯倒满到杯口,它就会倒满到杯口。让它画一个显示特定时间的时钟,它就会精确渲染那个时间。像 Midjourney 这样的扩散工具往往默认生成看起来在美学上更典型的结果。这使得当具体而字面的细节对需求很重要时,GPT Image 2.5 是更好的选择;而当更传统的精致外观比精确遵循指令更重要时,扩散工具是更好的选择。
GPT Image 2.5 提示词工程技巧
每当对比真正重要时,都要手动设置质量,因为留在自动模式会让两个模型版本之间的任何耗时或输出对比都失去意义。留意被放置在背景前的主体是否出现略显合成或贴上去的观感,这是从 GPT Image 2 延续下来的已知问题,在 2.5 中有所减轻但并未消除,通常可以通过在同一提示词中明确要求主体与背景之间的光线和阴影保持一致来解决。在多轮优化时,一次只改一处,而不是把多个请求堆叠在一次编辑中,因为隔离每一处改动,会让你更容易发现无关内容发生变化的那一刻。
常见问题
ChatGPT 默认使用哪个版本?
OpenAI 尚未正式确认,但测试表明 ChatGPT 和 Codex 中默认的是 Flare,而 Sunburst 则保留给直接调用 API 的场景。
Flare 到底快多少?
在一轮 high 质量的测试中,Flare 在 22 秒内返回了文字生成图像的结果,而 GPT Image 2 需要 177 秒,并在 19 至 27 秒内完成了一轮编辑。Sunburst 比 Flare 慢,但在大多数相同测试中仍比 GPT Image 2 快。
GPT Image 2.5 支持哪些图像尺寸?
从 1024 正方形到长边 3840 均可,两条边都须是 16 的倍数,宽高比不得宽于 3 比 1,总像素在 655,360 到 8,294,400 之间。高于 2560x1440 的尺寸被标记为实验性。
能保证每次生成都保持角色一致吗?
没有任何单一的图像模型能保证每次都完美一致,但在有记录的测试中,使用一张单独的参考图、在每个提示词中重复标志性细节,并让所用参考图表保持纯白背景,产生了无需重新抽卡的一致结果。
我可以在 Atlabs 中选择 Flare 还是 Sunburst 吗?
Atlabs 中的模型选择取决于 GPT Image Gen 集成当前运行的版本。如果想要对 Flare 与 Sunburst 以及手动质量档位进行明确控制,直接调用 API 目前是更精确的途径。
在 Atlabs 上可以免费使用吗?
可以。新账号会获得可覆盖一定数量生成的免费积分,付费套餐则解锁更多生成次数和更高分辨率的导出。
最终结论
贯穿整个系列的实用技巧可以归结为一个简短的决策,并持续地重复:让起始模型与你当前的质量标准相匹配,在比较任何东西之前先手动固定质量设置,并且一次只改变一个变量。上面的五个情绪提示词直接说明了这一点:Sunburst 在纹理丰富的写实作品上物有所值,比如肖像、概念艺术和产品图,而 Flare 在更平面的图形风格上表现不俗,比如矢量插画和复古海报,因为这些风格本来就没有太多额外渲染可以发挥的空间。对于角色创作,一张构建良好的单一参考图,最好是纯白背景上的完整十六格图表,对一致性的帮助远胜过更长更复杂的提示词。三部分指南到此结束。其中没有任何内容需要单独的工具或账号来测试,这正是为什么通过 Atlabs 运行它位居本文开头那份对比榜单之首的实际原因。








