如何用一首歌制作3D动画儿童音乐视频?
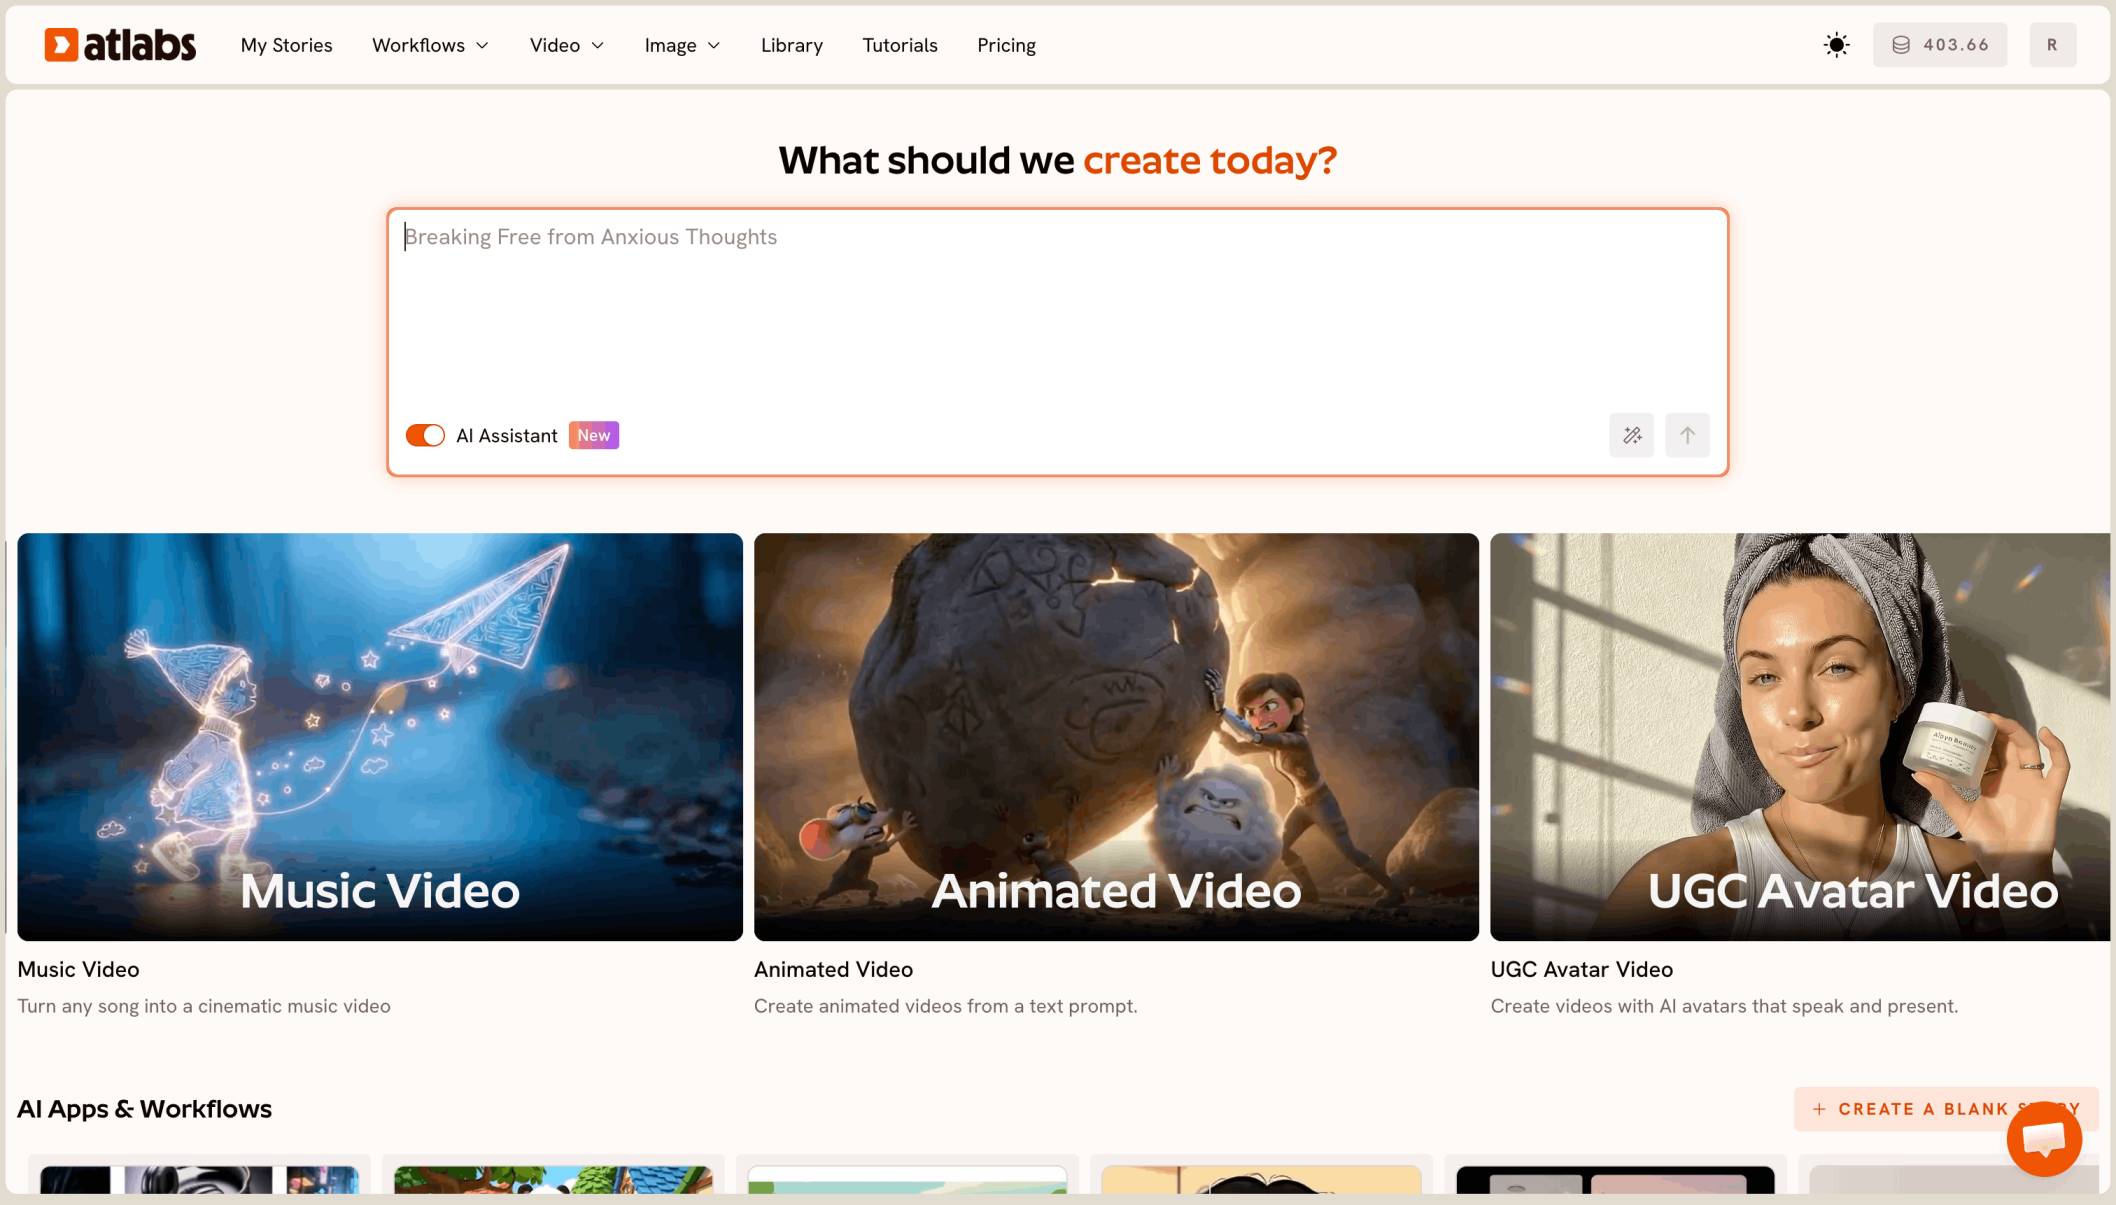
将歌曲上传到 Atlabs 儿童音乐视频工作流,选择3D风格,写下逐拍讲述故事的概念,并将你的角色保存为角色阵容。Atlabs 会按节拍将歌曲拆分为场景。然后用简短的提示词为每个起始帧添加动态:镜头中有谁、他们做什么,以及一个运镜。

《Supergirl!》是一支36秒的动画儿童音乐视频,在 Atlabs 中制作。一个披着红色斗篷的小女孩度过了神奇的一天:牵着妈妈的手,和爸爸跳舞,在天空中画彩虹,吓跑一个滑稽的反派,爬上最高的树,最后在月亮上睡着。本教程展示设置过程、四个角色,然后按顺序展示全部15个场景,包括歌词、起始帧和实际运行的提示词。Atlabs 还出现在 MarketersMEDIA 联合发布的AI儿童音乐视频生成器盘点中。
你需要准备什么
你需要一首人声清晰的完整儿童歌曲,因为歌词会成为你的场景脚本。心中要有一个从第一帧到最后一帧的简单故事,并决定谁会出现在其中。这个项目用到的是一首上传的曲目、小女孩生活中的超级英雄一天,以及四个角色:女孩、她的爸爸、妈妈和一个滑稽的反派。
分步设置
第1步:在“音乐”中上传歌曲
打开 儿童音乐视频工作流 ,并在 音乐 步骤中上传。这支视频的脚本来源设置为“上传音频故事”,语言设置为英语,因此场景脚本直接来自演唱的歌词。

第2步:在“设置风格”中选择外观
在 设置风格,选择图像风格、宽高比和输出。这个项目使用了3D风格、16:9画幅,输出模式为视频。

第3步:在“创意”中写下概念
在 创意,写下完整的故事,让每个场景都有方向。《Supergirl!》的概念讲述一个三岁女孩醒来发现世界灰暗而安静,于是决定要过一个神奇的日子。有父母在身边,每一次咯咯笑和跺脚都让色彩回归:她把人行道画成彩虹丝带,把云朵变成棉花糖的形状,并与父母一起在公园和街道上跳舞,仿佛整座小镇就是一个巨大的游戏室。
一个滑稽的卡通反派试图用古怪的小装置把色彩偷回去。她咧嘴笑着面对他,释放出一阵金色闪粉,把他裹满亮片,让威胁变成了笑话。随后她爬上最高的魔法树,斗篷被树枝挂住,又笑着挣脱。最后她飞升到云层之上,身后留下如小彗星般的闪光轨迹,视频结束在她蜷缩在发光的弯月上睡着的画面,怀里抱着一只星星毛绒玩具,下方是她刚刚拯救的世界。

第4步:在“定稿”中保存你的角色
在 定稿中,设置角色阵容。每个角色都有名字、可在提示词中使用的标签(如 @PennyChen),以及 Atlabs 用作该角色参考的角色设定图。这支视频使用了四个角色,将在下一节介绍。成片时长36秒,共15个场景,以1080p导出。

第5步:用动作提示词为每个场景添加动态
Atlabs 会将歌曲拆分为场景,并为每个场景提供对应的歌词行。歌词按节拍切分,所以一个词可能在一个场景开始,在下一个场景结束,比如场景2和3中的“h”和“and”。每个场景都有一个静态起始帧,你可以用动作提示词把它变成片段。
在这支视频中,每个起始帧都是在 Atlabs 之外制作并上传到对应场景的。你也可以在 Atlabs 内生成起始帧。无论哪种方式,下面的动作提示词都是 Atlabs 中为每个片段保存的提示词。
观看儿童音乐视频教程
认识角色阵容
四张角色设定图都是在 Atlabs 中制作的转面设定图:同一个角色在纯色背景上的多个角度。这为模型提供了角色面向每个方向的参考,有助于让角色在不同镜头间保持形象一致。制作这些设定图所用的提示词不会与角色一同保存,因此这里只描述他们的外观。
Penny Chen (@PennyChen),我们的 Supergirl

一个三岁的小女孩,深色头发扎成两个凌乱的丸子头,大大的棕色眼睛和红扑扑的脸颊,身穿印有黄色太阳和星星图案的蓝色连衣裙,披着红色斗篷,穿着条纹彩虹袜和白色运动鞋。
Kenji Chen (@KenjiChen),爸爸

一位三十多岁的和善男子,黑色短发,带着浅浅的胡茬和温暖的笑容,身穿蓝灰色毛衣、深色牛仔裤和灰色运动鞋。
Sarah Miller (@SarahMiller),妈妈

一位三十多岁的善良女子,深金色波浪长发扎成低马尾,身穿带有小红花图案的米色衬衫、黑色紧身裤和棕色平底鞋。
Barnaby Villain (@BarnabyVillain),滑稽的反派

一个又高又瘦、夸张戏剧化的反派,黑色头发向后梳得油亮,留着卷曲的八字胡,带着阴谋得逞般的笑容,身穿紫色西装、白色手套和黑色靴子。
这个故事没有保存任何地点。从星光点点的卧室到城市上空的弯月,每一处场景都来自概念和每个场景的起始帧。
逐场景详解:每句歌词、画面和提示词
场景1(0.9秒):前奏,无歌词

场景2(1.8秒):“I'll hold my mama's h”

场景3(3.3秒):“and and paint the world in gold. I”

场景4(2.1秒):“'m just a little girl, but I've”

场景5(3.7秒):“got a heart so bold. I'll play”

场景4和5在两个不同的起始帧上使用了完全相同的提示词,先是特写,然后是全身英雄姿势。复用有效的提示词,能让连续镜头之间的动作保持一致。
场景6(2.2秒):“with Daddy all”

场景7(4.1秒):“afternoon. We'll dance together under the big”

场景8(1.7秒):“bright moon. I'll draw a rainbow, pink,”

场景9(3.2秒):“blue, and green. I wanna be a super girl, super”

场景9就是场景8的提示词,在末尾多加了一行运镜。用上一条提示词加一处改动来构建下一个镜头,会让序列显得连贯。
场景10(2.7秒):器乐,无歌词

场景11(2.0秒):“girl. Yeah! Save the day and conque”

这里的起始帧是一幅带对话气泡的漫画分格。加上“Remove the text in animation”会告诉模型,在片段开始运动后去掉文字。
场景12(2.4秒):“r every curl. Jump so high, climb”

场景13(1.4秒):器乐,无歌词

场景14(2.7秒):“every tree. Nobody's braver, that's just”

提示词写的是“the woman”,但起始帧里是女孩在攀爬。如果你复用这条提示词,请写出你画面中实际出现的角色。
场景15(2.4秒):“me. Super girl.”

这些提示词为什么有效
保持简短朴素。 几乎每条提示词都说明镜头中有谁、他们做什么以及一个运镜。有了出色的起始帧,模型需要的就只有这些。
复用有效的做法。 场景4和5共用一条提示词,场景9是场景8加一行运镜。镜头之间的小幅改动能让动作保持稳定。
把角色保存为角色阵容。 四张转面设定图让女孩、她的父母和反派在全部15个场景中保持一致的外观。
在提示词中清理上传的画面。 一行“Remove the text in animation”就去掉了场景11中的漫画文字。
让画面与歌词相匹配。 “hold my mama's hand”时出现妈妈的手,“draw a rainbow”时出现彩虹,“climb every tree”时出现一棵树,帮助小朋友跟上歌曲。
常见问题
我可以用自己的歌曲制作儿童音乐视频吗?
可以。在 Atlabs 儿童音乐视频工作流的“音乐”步骤中上传曲目,在“设置风格”中选择风格,在“创意”中写下你的概念,并在“定稿”中保存你的角色。然后 Atlabs 会将歌曲拆分为与歌词对应的场景。
我可以使用在别处制作的起始图片吗?
可以。《Supergirl!》中的每个起始帧都是在 Atlabs 之外制作的,上传到对应场景,然后在 Atlabs 中用动作提示词添加动态。
如何让角色在每个场景中保持一致的外观?
将每个角色连同转面设定图保存为角色阵容,然后在提示词中写出名字或标签。《Supergirl!》的四个角色就是这样保持一致的。
每条动作提示词应该多长?
简短就好。这支视频中的大多数提示词都是一两句话:谁、他们做什么,以及一个运镜。
最终结论
《Supergirl!》表明,一支明快、以故事驱动的儿童音乐视频并不需要很长的提示词。Atlabs 中的四个设置步骤打好了基础:在“音乐”中上传歌曲,在“设置风格”中选择3D风格和16:9,在“创意”中写下逐拍的概念,并在“定稿”中将四个角色保存为角色阵容。之后,简短的提示词、每次只改一处的复用提示词,以及与歌词匹配的画面,把15行歌词变成了一个连贯的36秒故事。把这些提示词当作模板,换上你自己的角色和时刻,满意后以1080p导出。