Un joven está sentado en un sofá al lado de una mujer pelirroja. Algo se le pasa por la cabeza. Se levanta, grita "¡TÍA MAY!" y corre por el pasillo. Mientras corre, se vuelve más joven. No con un corte, no con un destello, sino de forma continua, zancada a zancada, hasta que la persona que abre la puerta al final del pasillo es un niño pequeño. Esperando detrás de esa puerta está la mujer que lo crió, y ella lo atrapa.
Si creciste con Spider-Man, ya sabes por qué eso funciona. El personaje siempre ha funcionado porque el héroe con los poderes también es el niño que nunca dejó de necesitar a su tía. Diez segundos, una toma, sin cortes, y toda la relación está en pantalla sin una sola línea de exposición.
Esta guía cubre exactamente cómo se hace ese clip. Los personajes aquí son diseños estilizados originales en lugar de copias del disfraz o la apariencia de alguien, que es lo que hace que un homenaje siga siendo un homenaje. La técnica en sí funciona para cualquier cortometraje animado emocional donde un personaje tiene que seguir siendo reconociblemente él mismo mientras todo a su alrededor cambia.
Por qué la transformación en una sola toma es la parte difícil
La mayoría de los videos de IA parecen videos de IA por lo que sucede entre tomas. Genera dos clips del mismo personaje y obtendrás dos personas ligeramente diferentes. La mandíbula es más estrecha, la raya del pelo está en el otro lado, la chaqueta es de un azul diferente. El público lo nota al instante incluso cuando no puede nombrar lo que está mal, y el latido emocional muere en el momento en que la cara deja de ser la misma cara.
Una secuencia de regresión de edad empeora ese problema, no lo mejora, porque se supone que el personaje debe cambiar. El modelo tiene que entender qué cambios son la historia, es decir, la altura, las proporciones, la suavidad facial, y qué cambios son errores, es decir, la identidad, el color del pelo, la lógica de la ropa, la forma específica de los ojos. Si te equivocas en ese límite, el público verá aparecer a una persona diferente a mitad del pasillo en lugar de ver a la misma persona rejuvenecer.
La solución no es un mejor prompt de movimiento. Es bloquear la identidad fuera del prompt de video por completo. Construyes los personajes como imágenes primero, luego entregas esas imágenes al modelo de video como referencias con nombre y le dices, en el prompt, exactamente qué referencia gobierna a qué personaje en qué segundo. El modelo deja de inventar caras y comienza a animar las que le diste.
Las dos herramientas sobre las que funciona esto
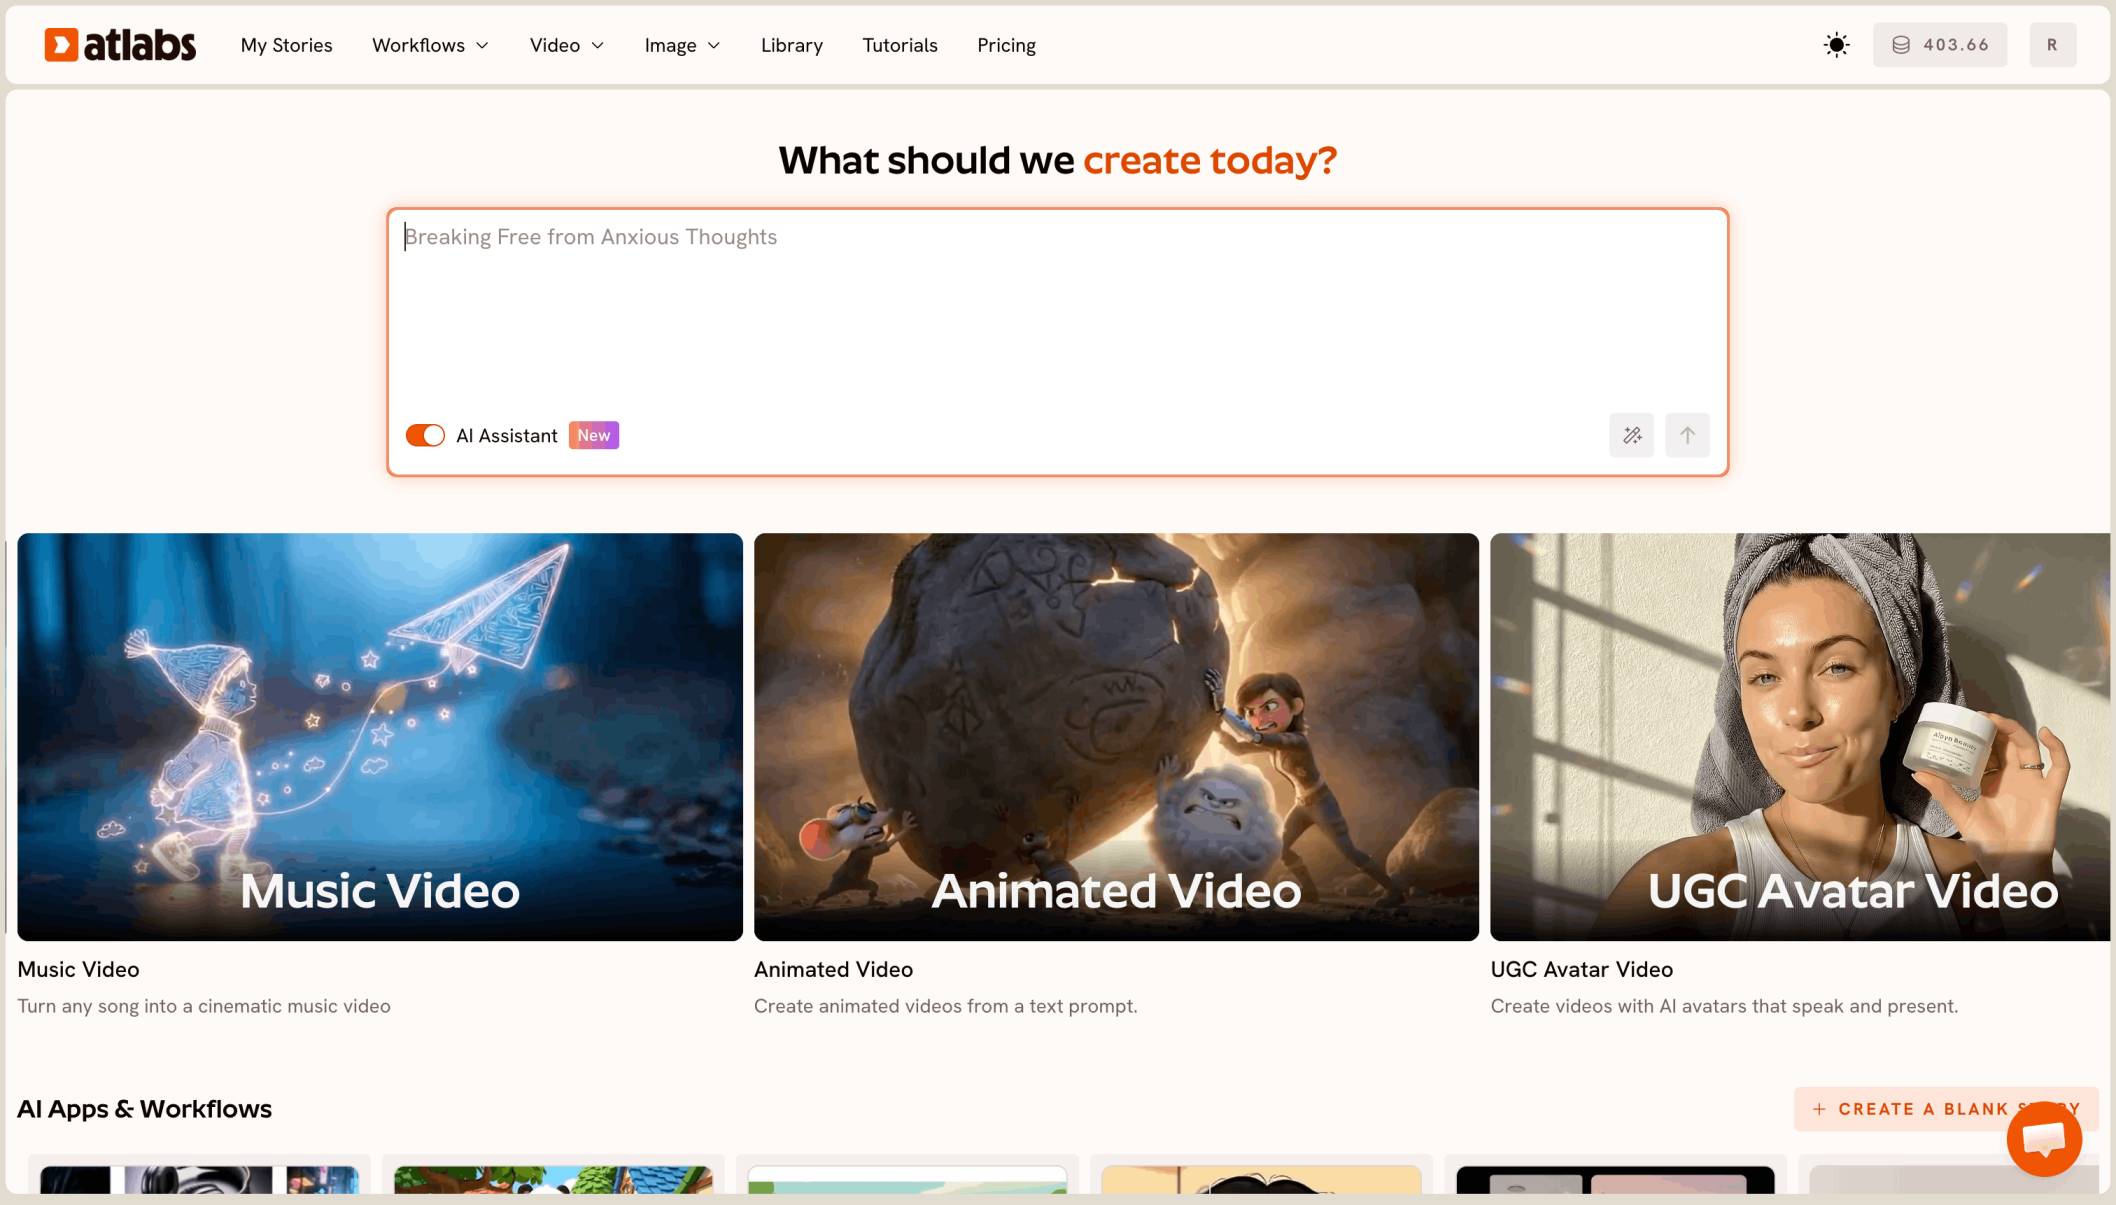
Ambos pasos viven dentro de Atlabs.
GPT Image 2 construye las referencias de personajes. Aquí es donde dedicas la mayor parte de tu esfuerzo, porque cada fotograma del video final hereda estas imágenes. No estás haciendo arte conceptual aquí. Estás haciendo una hoja de reparto que el modelo de video tiene que obedecer.
Seedance 2.0 Ref to Video genera el clip. Seedance 2.0 es el modelo adecuado para esto porque maneja el trabajo de personajes estilizados y la animación facial expresiva mejor que los modelos fotorrealistas, y el modo Ref to Video te permite pasar múltiples imágenes de referencia etiquetadas a las que puedes llamar por su nombre dentro del prompt. Ese etiquetado es lo que hace posible una toma de múltiples personajes y múltiples etapas en una sola generación.
Guía paso a paso
Parte 1: Construye tus referencias de personajes en GPT Image 2
1. Abre GPT Image 2 y genera tu primera referencia. Ve a GPT Image 2. Esta primera imagen establece la versión adulta de tu personaje y de cualquier persona que comparta la escena inicial con él. Escribe el prompt como una descripción de reparto en lugar de un tablero de ideas. Tono de piel, estilo y color de pelo, color de ojos, prendas exactas, postura, todo expresado claramente, porque cualquier cosa que dejes vaga es algo que el modelo de video decidirá por ti más tarde.
La referencia de la escena inicial utilizada para este cortometraje describe a un joven de pelo oscuro y a una mujer pelirroja en un sofá beige bajo una cálida luz dorada de interior, de frente, de cintura para arriba, en un estilo de película de animación 3D pulido a 16:9. Los pequeños detalles llevan el homenaje sin copiar nada: un sutil patrón geométrico similar a una telaraña en el cuello de su camisa trabaja más que un disfraz. El prompt completo está en la sección de prompts más abajo.

2. Genera tu segunda referencia: la versión más joven y la mujer mayor. Misma herramienta, nueva imagen. Esta lleva al niño en el que se convierte el hombre y a la mujer anciana que espera al final del pasillo. El detalle crítico aquí es que el niño debe parecer una versión joven plausible del adulto de tu primera imagen. Mismo color de pelo, mismo color de ojos, misma forma de la cara suavizada por la edad. Si las dos imágenes no coinciden en eso, la transformación parecerá un intercambio en lugar de una regresión.
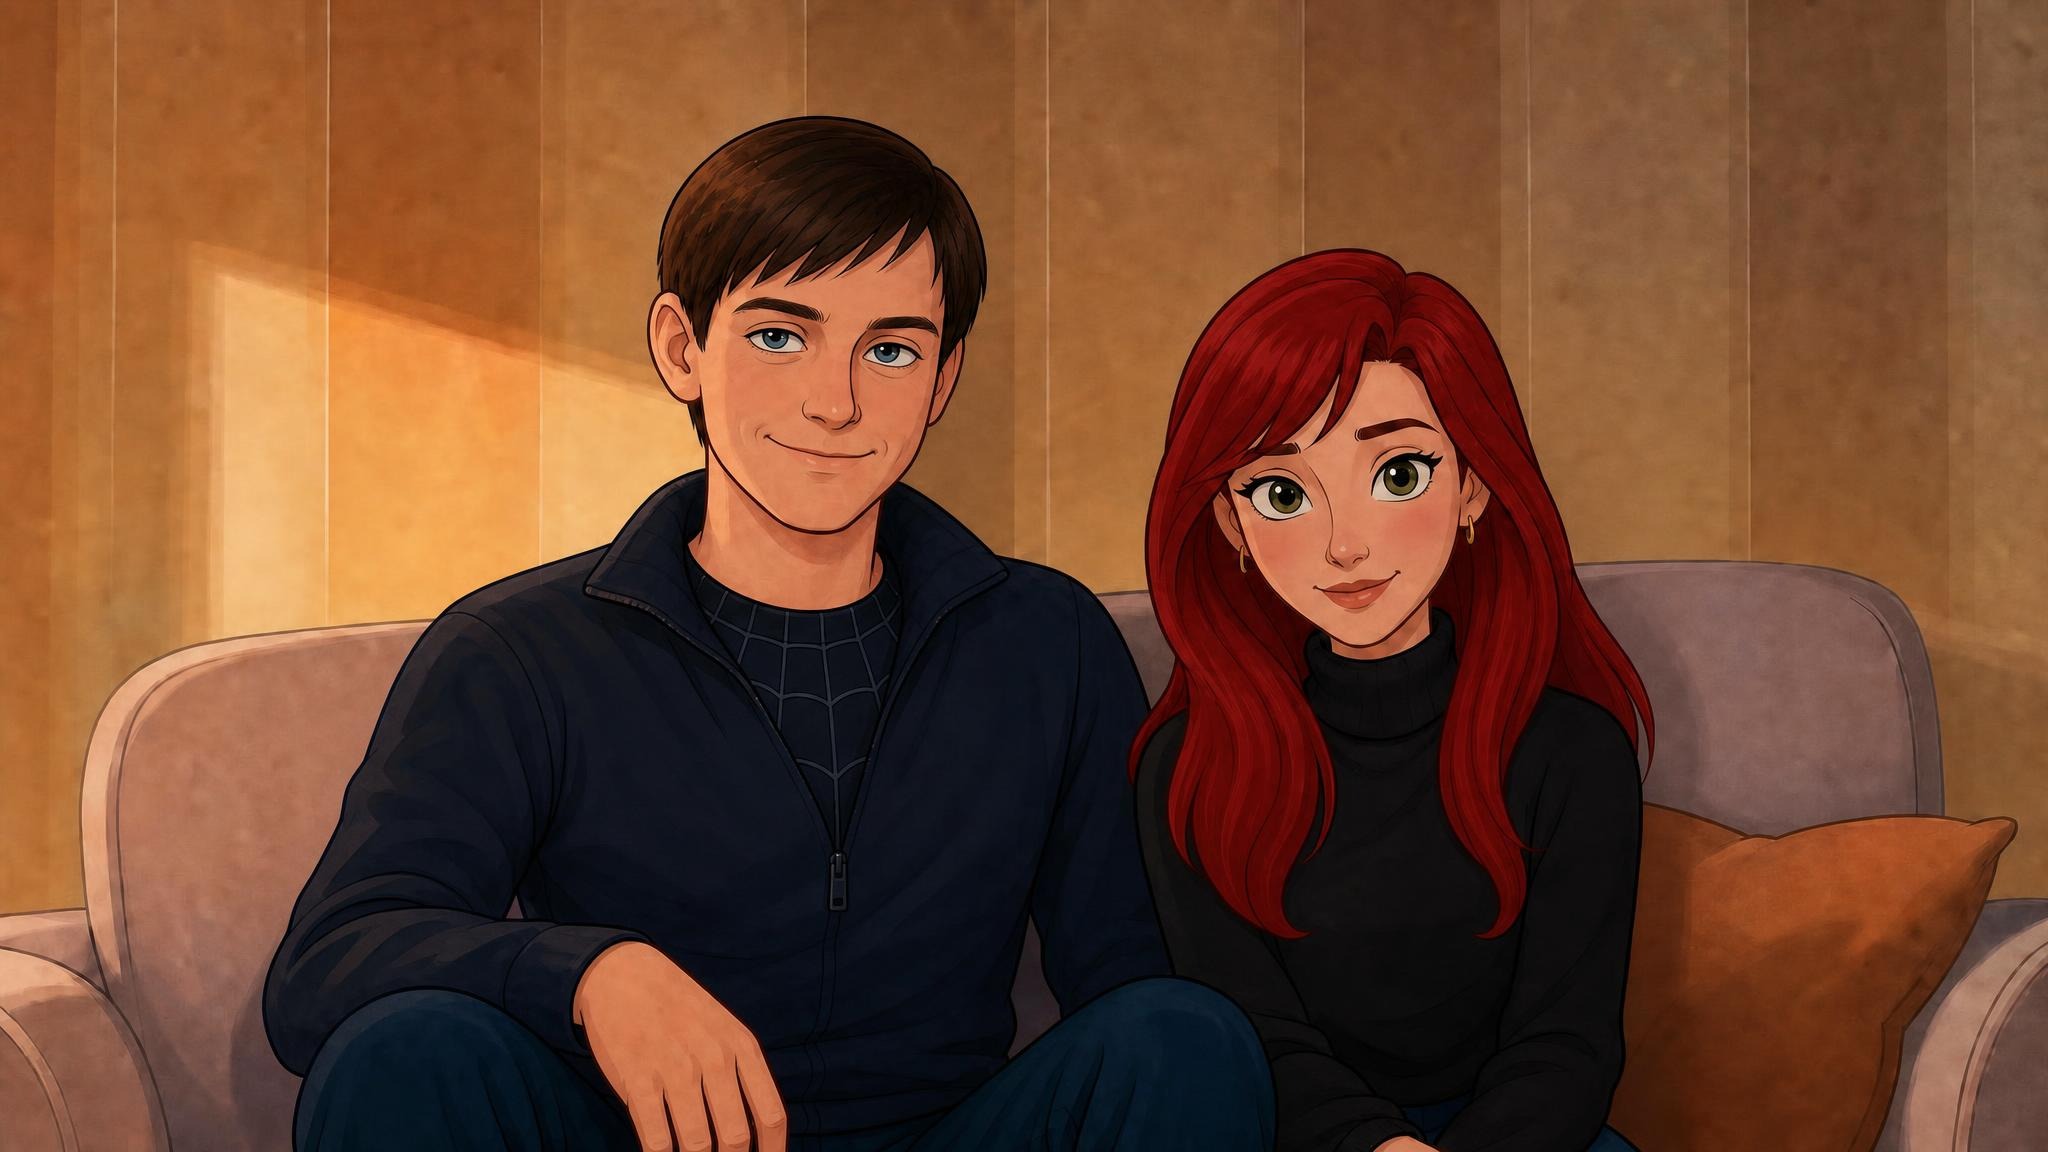
3. Compara ambas imágenes entre sí antes de continuar. Ponlas lado a lado. ¿Coincide el lenguaje de la iluminación, interior cálido y dorado en ambas? ¿Coincide el estilo de animación, mismo nivel de estilización, misma lógica de tamaño de ojos, misma representación de la piel? ¿Se mantiene la identidad a través de la brecha de edad? Corrige cualquier desajuste ahora, porque no podrás corregirlo más tarde en la etapa de video.
¿Listo para construir tus propias referencias? Comienza en GPT Image 2.
Parte 2: Genera la toma en Seedance 2.0 Ref to Video
4. Abre Seedance 2.0 Ref to Video y sube ambas referencias. Ve a Seedance 2.0 Ref to Video. Sube la imagen de la escena del sofá y la imagen del reencuentro. Se convierten en @img1 y @img2, y esas etiquetas son la forma en que te diriges a cada personaje dentro del prompt.
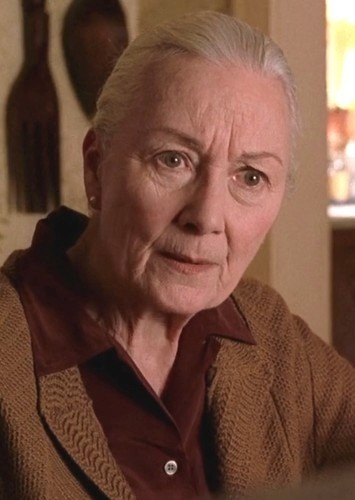
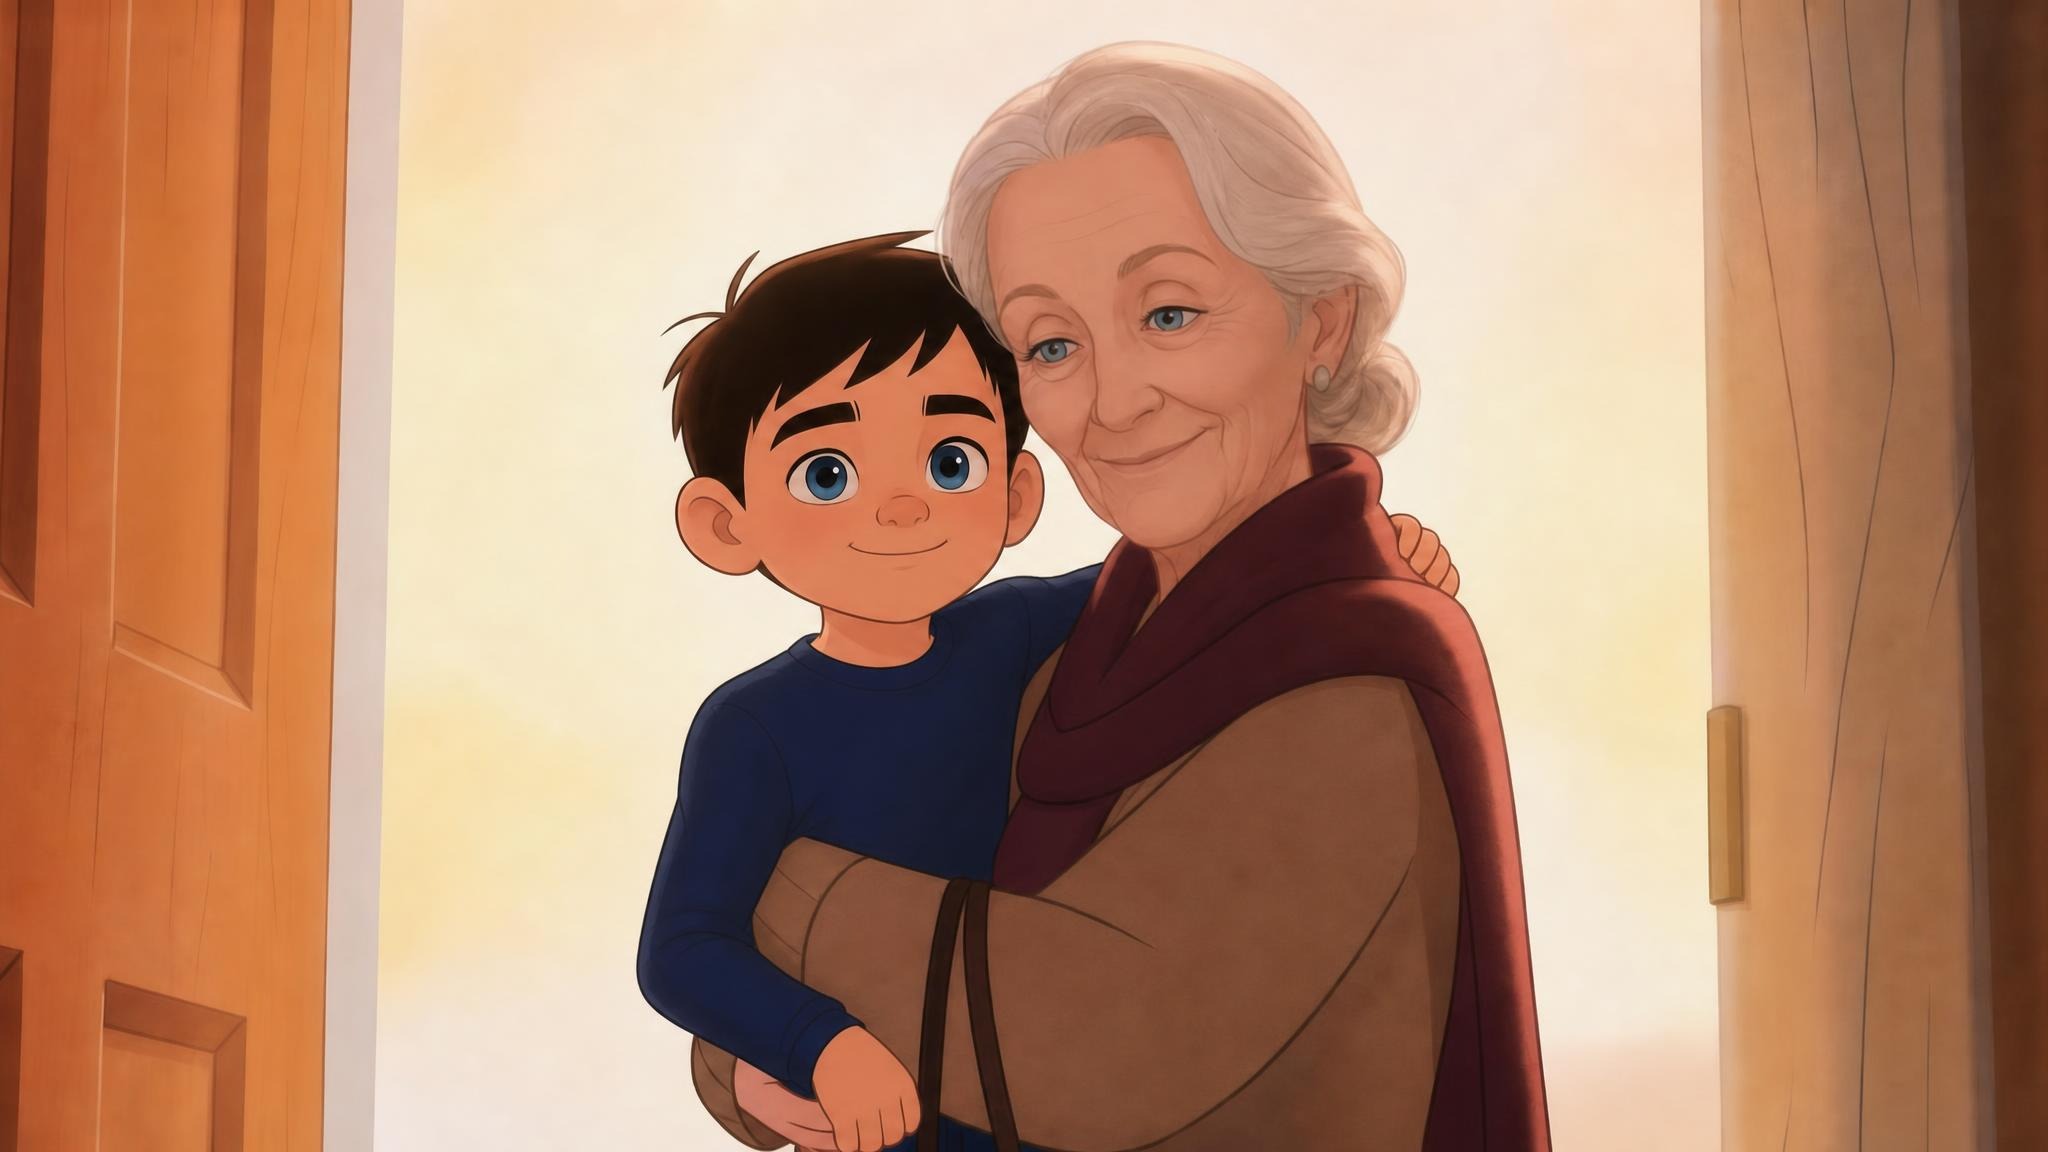
5. Escribe el prompt como una línea de tiempo, no como una descripción. Esta es la parte que separa un clip que funciona de uno que casi funciona. En lugar de describir la escena en su conjunto, divide los diez segundos en momentos etiquetados y detalla lo que sucede en cada uno:
Los dos primeros segundos son la revelación. El hombre se levanta, grita "¡TÍA MAY!" y comienza a moverse. Los segundos del dos al seis son la carrera y la transformación, y aquí es donde especificas que el envejecimiento ocurre continuamente mientras corre, pasando de adulto a adulto más joven, a adolescente, a niño pequeño, sin que la cámara corte nunca. Los segundos del seis al ocho son la puerta. Los segundos del ocho al diez son el reencuentro y el abrazo.
6. Añade el bloque de restricciones. Debajo de la línea de tiempo, indica lo que el modelo no debe hacer. Sin destellos, sin disolvencias, sin teletransportación, sin metamorfosis repentinas, sin cortes durante la transformación, sin personajes duplicados, sin texto ni marca de agua. Las restricciones negativas hacen mucho trabajo en una toma como esta, porque la forma más fácil para que un modelo resuelva una transformación difícil es ocultarla detrás de una edición, y tú estás eliminando explícitamente esa opción.
7. Especifica la cámara, la iluminación, la emoción y el audio por separado. Dale a cada uno su propio bloque. La cámara cubre el movimiento de plano medio a toma de seguimiento y a primer plano íntimo. La iluminación cubre la cálida luz interior que se vuelve más cálida al final del pasillo. La emoción establece la intención para que la animación facial tenga dirección. El audio cubre el crescendo de la orquesta, la línea gritada, los pasos y el tono de la habitación.
8. Genera, luego revisa contra tus referencias. Míralo una vez para la transformación y otra para la identidad. La transformación debe ser visible a medida que ocurre en lugar de resolverse fuera de pantalla. El niño en la puerta debe ser el niño de tu segunda referencia, y la mujer mayor debe coincidir exactamente con la suya. Si la identidad se desvía, ajusta el lenguaje de referencia en el prompt en lugar de volver a generar a ciegas.
Por qué este enfoque se mantiene firme
El bloqueo de referencias elimina las conjeturas. Debido a que @img1 y @img2 son imágenes reales en lugar de descripciones, el modelo está comparando píxeles, no interpretando adjetivos. Dos personas que leen "pelo corto de color marrón oscuro" imaginan dos cortes de pelo diferentes, y lo mismo hacen dos generaciones del mismo modelo. Una imagen elimina esa ambigüedad por completo.
Los momentos con marca de tiempo le dan al modelo una estructura que llenar en lugar de una historia que inventar. Un prompt de diez segundos escrito como prosa se comprime de forma impredecible, y el modelo decide cuánto dura cada momento. Escrito como de 0:00 a 0:02, de 0:02 to 0:06, de 0:06 a 0:08, de 0:08 a 0:10, el ritmo es tuyo. La carrera tiene cuatro segundos completos porque ahí es donde la transformación tiene que ser legible.
Seedance 2.0 fue diseñado para la actuación de personajes estilizados. Todo el cortometraje depende de que la cara transmita la emoción, y el modelo maneja las características animadas expresivas y la interacción física creíble mejor que los modelos optimizados para el fotorrealismo. Elegir el modelo adecuado para el trabajo importa más que la longitud del prompt.
La dirección de audio dentro del prompt ahorra un paso separado. El crescendo orquestal, el nombre gritado, los pasos y el tono de la habitación se especifican junto con los elementos visuales, de modo que el pico emocional de la música coincida con el abrazo en lugar de ser editado para encajar después.
Consejos profesionales
Dedica tu tiempo a las imágenes de referencia, no al prompt de video. Una referencia débil no se puede salvar con un prompt de video más largo, y una referencia sólida hace que un prompt de video corto funcione. Si te encuentras en la octava generación de video tratando de corregir una cara, el problema está al principio del proceso.
Escribe tus negativos de forma tan específica como tus positivos. "Sin cortes" es más débil que "sin destellos, sin disolvencias, sin teletransportación, sin metamorfosis repentinas, sin cortes durante la transformación". Estás cerrando cada atajo que el modelo podría intentar tomar, y cada uno que dejas abierto es uno que podría aprovechar.
Dale más tiempo al momento más difícil. La transformación recibe cuatro de los diez segundos porque necesita ser legible. Si la comprimes en dos, el modelo tiene que moverse demasiado rápido y resolverá el cambio de una manera que no pediste. Presupuesta el tiempo en pantalla por dificultad, no por importancia para la trama.
Mantén la iluminación continua en ambas imágenes de referencia. Interior cálido y dorado en la primera, interior cálido y dorado en la segunda. Cuando las dos referencias no coinciden en la dirección de la luz o la temperatura del color, el modelo de video tiene que reconciliarlas a mitad de la toma y se nota la costura.
Preguntas frecuentes
¿Cuántas imágenes de referencia puedo usar? Ref to Video está diseñado para pasar múltiples referencias etiquetadas y dirigirse a cada una por su nombre en el prompt. Este cortometraje utiliza dos, una por escena, con la segunda referencia llevando dos personajes. Agrupar personajes que aparecen juntos en una sola referencia mantiene su escala relativa e iluminación consistentes.
¿Por qué no generar la transformación como clips separados y editarlos juntos? Puedes hacerlo, y será más fácil, pero no se percibirá igual. El peso emocional de esta toma proviene de que el público ve el cambio ocurrir sin un corte detrás del cual esconderse. En el momento en que editas, se convierte en un montaje en lugar de una transformación.
¿Puedo construir esto alrededor de un personaje existente como Spider-Man? Construye tu propio diseño de personaje en lugar de reproducir un disfraz, logotipo o apariencia de actor existentes. El latido emocional es aquello a lo que la gente responde, y un personaje original estilizado lo transmite igual de bien. Los pequeños detalles sugerentes, como una textura de telaraña en el cuello en lugar de un traje completo, mantienen el homenaje legible sin copiar nada.
¿Puedo hacer esto con una persona real en lugar de un personaje animado? El flujo de trabajo es idéntico. Construye tus referencias primero, luego pásalas a Ref to Video. El 3D estilizado se utiliza aquí porque Seedance 2.0 maneja caras animadas expresivas de manera particularmente buena, pero el método de bloqueo de referencia se aplica sea cual sea el estilo.
¿Qué pasa si la identidad del personaje se desvía a mitad del proceso? Ajusta el lenguaje de referencia en el prompt antes de volver a generar. Volver a declarar que una referencia específica gobierna a un personaje específico, y nombrar lo que debe preservarse, generalmente lo soluciona. Si persiste, probablemente las dos imágenes de referencia no coincidan en la identidad en primer lugar.
¿Qué longitud puede tener el clip? Este está escrito para diez segundos, lo cual es suficiente para una estructura de cuatro momentos con un arco emocional claro. Las tomas más largas dejan más espacio para la desviación, por lo que construir una pieza más larga a partir de varias tomas estrechamente controladas suele funcionar mejor que pedir una sola generación larga.
Veredicto final
La razón por la que la mayoría de las animaciones de IA se sienten vacías es que parecen ensambladas en lugar de interpretadas. Las caras cambian entre tomas, las transformaciones se ocultan detrás de las ediciones, y el latido emocional nunca llega porque el público está tratando de descifrar discretamente si está viendo a la misma persona.
Bloquear tus personajes como imágenes en GPT Image 2 y luego dirigirlos momento a momento en Seedance 2.0 Ref to Video resuelve ambos problemas en un solo paso. Apruebas el reparto antes de que se mueva un solo fotograma, luego escribes la toma como un director en lugar de como un ingeniero de prompts. Construye tus propios personajes en lugar de copiar los existentes y el homenaje seguirá siendo tuyo.