أربعة تغييرات، اتجاه واحد
لمعظم مخرجات فيديو الذكاء الاصطناعي علامة تفضحها، وهي ليست الدقة. إنها أن كل شيء يحدث لشخص واحد، في مكان واحد، بنوع واحد من اللقطات. يتحول الفيديو الموسيقي إلى مغنٍّ أمام خلفية لتسعين ثانية. ويتحول الدرس إلى سرد صوتي فوق صور. ويصبح المشهد الذي يضم شخصين توليدين منفصلين تقصّهما معًا وتأمل ألا يدقق أحد النظر.
التغييرات الأربعة التي وصلت مؤخرًا تدفع كلها ضد الجدار نفسه. فأداء الموسيقى (Music Performance) يؤلّف الآن مشاهد متنوعة بشكل افتراضي، تشمل الآلات والأداء على المسرح بدلًا من لقطات الغناء المتكررة. كما يقبل مدخلاتك الخاصة في البداية ويختار الشخصيات المغنية وغير المغنية من الصور التي تقدمها. ويستطيع أداء الأطفال (Kids Performance) بناء درس حول شخصية معلّمة مع مزامنة الشفاه. وتتعامل مزامنة الشفاه الآن مع عدة شخصيات في الفيديو نفسه.
عند قراءتها منفردة تبدو أربعة تحسينات منفصلة. وعند قراءتها معًا تصف تحوّلًا واحدًا: الأجزاء التي كانت تتطلب منك تجميعها في الفيديو صارت تحدث داخل التوليد نفسه.
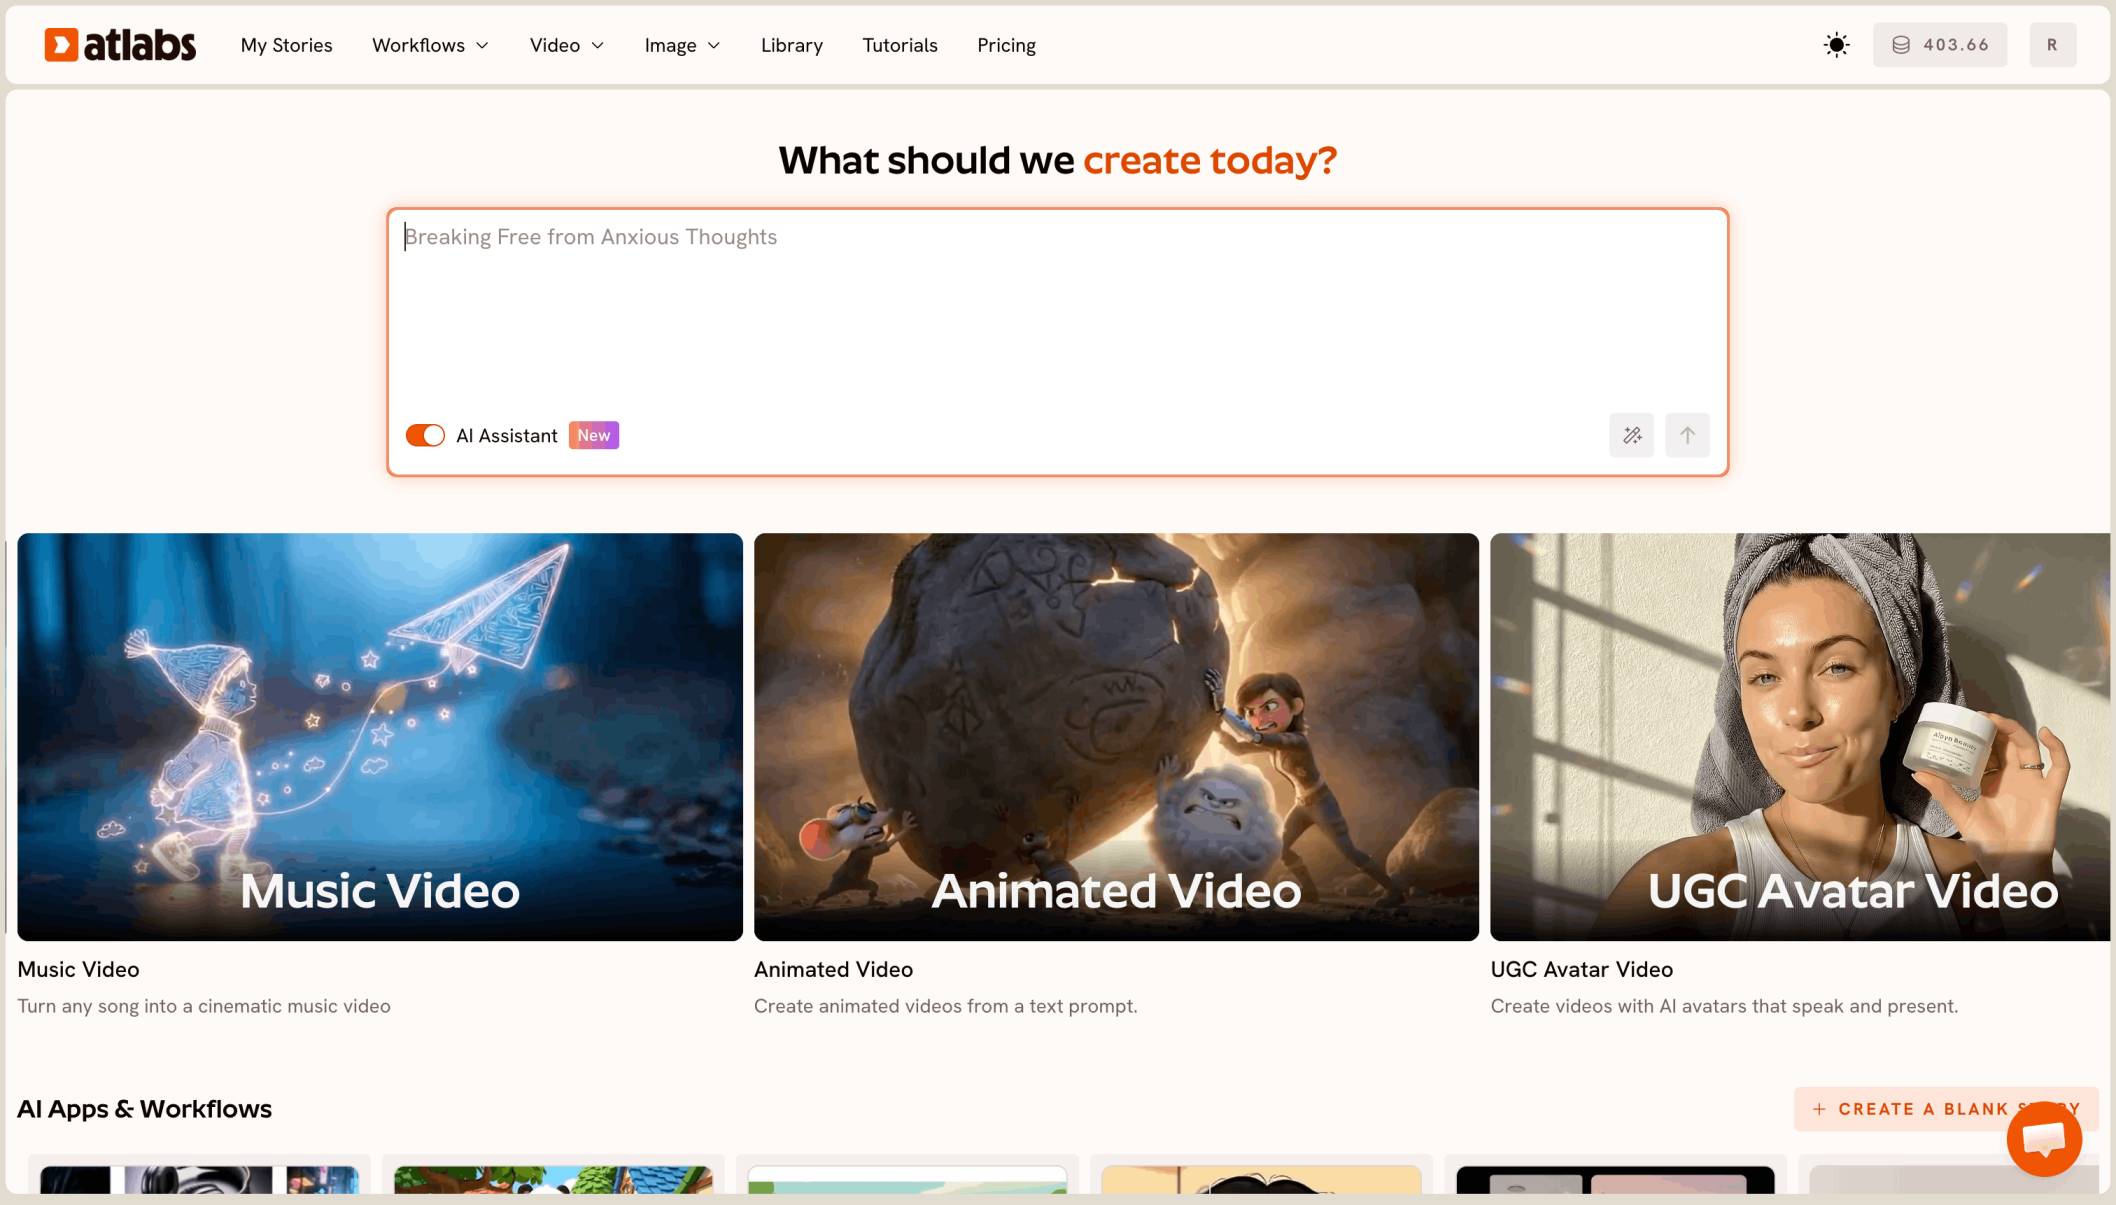
اكتشف الجديد على Atlabs
أداء الموسيقى: مشاهد أكثر من مغنٍّ واحد

يتمثل التغيير هنا في التكوين والتأطير. ينتج أداء الموسيقى الآن مجموعة أوسع من أنواع المشاهد داخل فيديو واحد، تشمل مشاهد الآلات والأداء على المسرح، بدلًا من تنويعات على شخص واحد يغني أمام الكاميرا.
لفهم أهمية ذلك، فكّر في كيفية مونتاج الفيديو الموسيقي الحقيقي. لا يكاد جزء من مدته يكون لقطة ثابتة لمغنٍّ. تشاهد المغني، ثم أصابعًا تتحرك على عنق الغيتار، ثم عازف طبول مضاءً جزئيًا في عمق الغرفة، ثم لقطة واسعة للمسرح والجمهور في هيئة ظلال، ثم عودة إلى المغني من زاوية مختلفة وعلى مسافة مختلفة. إيقاع هذه القطعات جزء كبير مما يجعل الفيديو يبدو فيديو موسيقيًا لا تسجيلًا لشخص يغني. والنموذج الذي ينتج نوع اللقطة الأول فقط يتركك مع مادة سليمة تقنيًا لكنها مسطّحة بنيويًا، وكان الحل سابقًا توليد كل نوع إضافي من اللقطات على حدة وقصّها بنفسك.
إنتاج أنواع اللقطات هذه داخل تدفق واحد يعني أن إيقاع القطع يصبح متاحًا دون مرحلة مونتاج منفصلة. يصلك الفيديو متنوعًا من البداية، وهذه نقطة انطلاق مختلفة عن فيديو يصل متجانسًا ويحتاج إلى تنويع.
التفصيل الجدير بالانتباه أن هذا ينطبق في الوضع الافتراضي. التحسينات التي لا تظهر إلا بعد ضبط الإعدادات المتقدمة هي تحسينات لا يصادفها معظم الناس، لأن أغلبهم يولّد مرة واحدة بالإعدادات الافتراضية ويحكم على الأداة بما يعود إليه. والمخرجات الأفضل في أول تشغيل دون أي ضبط هي النسخة من هذا التحسين التي تصل فعلًا إلى المستخدمين.
عمليًا، يوسّع هذا من يخدمه التدفق. فالفنان المستقل الذي يصدر أغنية منفردة يحصل على ما هو أقرب إلى فيديو أداء بدلًا من مرئيات كلمات. وصاحب الأغاني المعاد غناؤها يحصل على تغطية للآلات دون أن يمتلك كاميرا. وأي شخص ينتج محتوى موسيقيًا بلغة محلية، حيث نادرًا ما توجد ميزانية للتصوير لكن توقعات الجمهور لفيديو حقيقي قائمة، يحصل على تنوع اللقطات الذي بُنيت عليه تلك التوقعات.
اختر ممثلي فيديوك الموسيقي بنفسك
التغيير الثاني هو إعادة تصميم لطريقة بدء أداء الموسيقى. يمكنك إضافة مدخلاتك في بداية التدفق، ويقبل اختيار الممثلين صور المغنين وغير المغنين على حد سواء.
الجزء الثاني أثقل مما يبدو لأول وهلة. حتى الآن كان الأشخاص في الفيديو الموسيقي المولّد أشخاصًا يخترعهم النموذج، وهذا يحدّ مما يمكن استخدام المخرجات فيه. فيديو يظهر فيه شخص غريب هو مادة مزاجية. وفيديو يظهر فيه الفنان نفسه هو أصل صالح للإصدار. إضافة مغنيك بنفسك تعني أن الشخص الذي يؤدي على الشاشة هو الشخص الذي يؤدي الأغنية، وهذا التغيير وحده ينقل المخرجات من شيء تعرضه على الأصدقاء إلى شيء تضعه في إصدار رسمي.
تفتح خانة غير المغني فئة كانت مغلقة تمامًا من قبل. كثير من الأغاني ليس عن فعل الغناء بل عن شخص، ويحتاج هذا الشخص إلى الظهور على الشاشة دون أن يؤدي أي سطر. المواد الرومانسية هي الحالة الأوضح. أغنية الحب عمل ثنائي. يؤدي الفنان، ويحمل بطل ثانٍ النصف العاطفي من القصة، ويظهر في المشاهد التي تصفها الكلمات بدلًا من أن يحرك شفتيه بها. اختيار شريك أو صديق أو ممثل كشخصية غير مغنية يمنحك هذا البطل الثاني مباشرة.
البنية نفسها تغطي ما هو أبعد من الرومانسية بكثير عندما تبحث عنه. معالجة سردية يؤدي فيها الفنان وتمثّل شخصيات أخرى القصة. تحية يظهر فيها صاحبها طوال الوقت دون غناء. عمل عائلي أو مجتمعي يحضر فيه أشخاص حقيقيون بصفتهم أنفسهم. تعاون مع علامة تجارية يظهر فيه متحدث رسمي إلى جانب الفنان المؤدي. كلها بالشكل نفسه: صوت واحد ووجوه عدة.
ومع مزامنة الشفاه على أغنيتك المختارة، يصبح التدفق أداة لاختيار الممثلين لا مولّدًا تقبل ما يخرج منه. وهذا تحوّل مهم في الموقف. فأنت تقرر من في الفيديو قبل التوليد بدلًا من تقييم من ظهر فيه بعده.
اختيار صور مصدر جيدة يفيد هنا بالطريقة نفسها التي يفيد بها أي توليد قائم على الهوية. الوجوه الأمامية جيدة الإضاءة وغير المحجوبة تترك للنموذج أقل قدر من التخمين. أما الظل الكثيف على نصف الوجه والنظارات الشمسية والحركة المموّهة والزوايا المتطرفة فكلها تقلّل ثبات ظهور ذلك الشخص عبر المشاهد، وهذا يستحق دقيقة لاختيار الصور قبل أن تصرف توليدًا لاكتشافه.
اختر ممثلي فيديوك الموسيقي بنفسك
أداء الأطفال: معلّمة تتكلم فعلًا
يستطيع أداء الأطفال الآن بناء محتوى تعليمي حول شخصية معلّمة يتحرك فمها عند جملها هي فقط.
للفيديو التعليمي للأطفال شرط واحد يغفله التوليد العام للفيديو في الغالب. المشاهدون الصغار يتبعون الوجوه. ينتبهون عندما تنظر إليهم شخصية وتتكلم، ويشرد انتباههم عندما يسرد صوت فوق رسوم لا تستجيب له. هذا قريب من طريقة عمل الانتباه في تلك السن، ولهذا تُبنى تقريبًا كل صيغة ناجحة للأطفال على أي منصة حول مقدّم أو دمية أو شخصية تخاطب الجمهور مباشرة.
كان الجزء الذي ينهار سابقًا هو ما يحدث عندما تشارك شخصية ثانية في الكادر. كان كل فم في المشهد يتحرك مع كل جملة، فتحرك المعلمة والطالب شفاههما بجملة المعلمة، ويتوقف الفيديو عن أن يُقرأ كدرس ويبدأ بأن يُقرأ كخطأ. الآن صار الكلام منسوبًا لصاحبه. تقول المعلمة الجملة، ويبقى الطالب ساكنًا ويستمع، ويستطيع المشاهد أن يعرف من يتكلم، وهذا هو الأساس الكامل لدرس من شخصيتين.
هذه النسبة هي ما يجعل الصيغ تعمل لا مزامنة الشفاه وحدها. شرح المفاهيم يعمل لأن الشخصية تستطيع أن تقول "شاهدوا ما يحدث عندما أفعل هذا" ثم تفعله. والأصوات الصوتية وأصوات الحروف تعمل لأن شكل الفم جزء من التعليم لا عرَض فيه. والعدّ وتسلسل الأرقام يعملان لأن الإيقاع يأتي من شخص يتكلم لا من مؤقّت ترجمة نصية. والعلوم خطوة بخطوة تعمل لأن المقدّم يستطيع أن يقود المشاهد عبر تسلسل بطريقة لا يستطيعها السرد فوق الصور الثابتة. وصيغ السؤال والجواب تعمل الآن بطريقة لم تكن ممكنة من قبل، لأن الطالب يستطيع أن يسأل والمعلمة تجيب دون أن يبدو أن كليهما يقول الجملة نفسها.
بالنسبة لمشغّل قناة أطفال، يغيّر هذا سؤال الإنتاج من كيفية صنع عروض شرائح مروية بشكل أسرع إلى كيفية صنع دروس بطاقم ممثلين. وبالنسبة لمعلّم أو فريق تقنية تعليمية، يعني أن المواد الصفية يمكن أن تضم مقدّمًا ثابتًا وشخصية ثانية تطرح الأسئلة التي كان الصف سيطرحها، دون تصوير أي شخص.
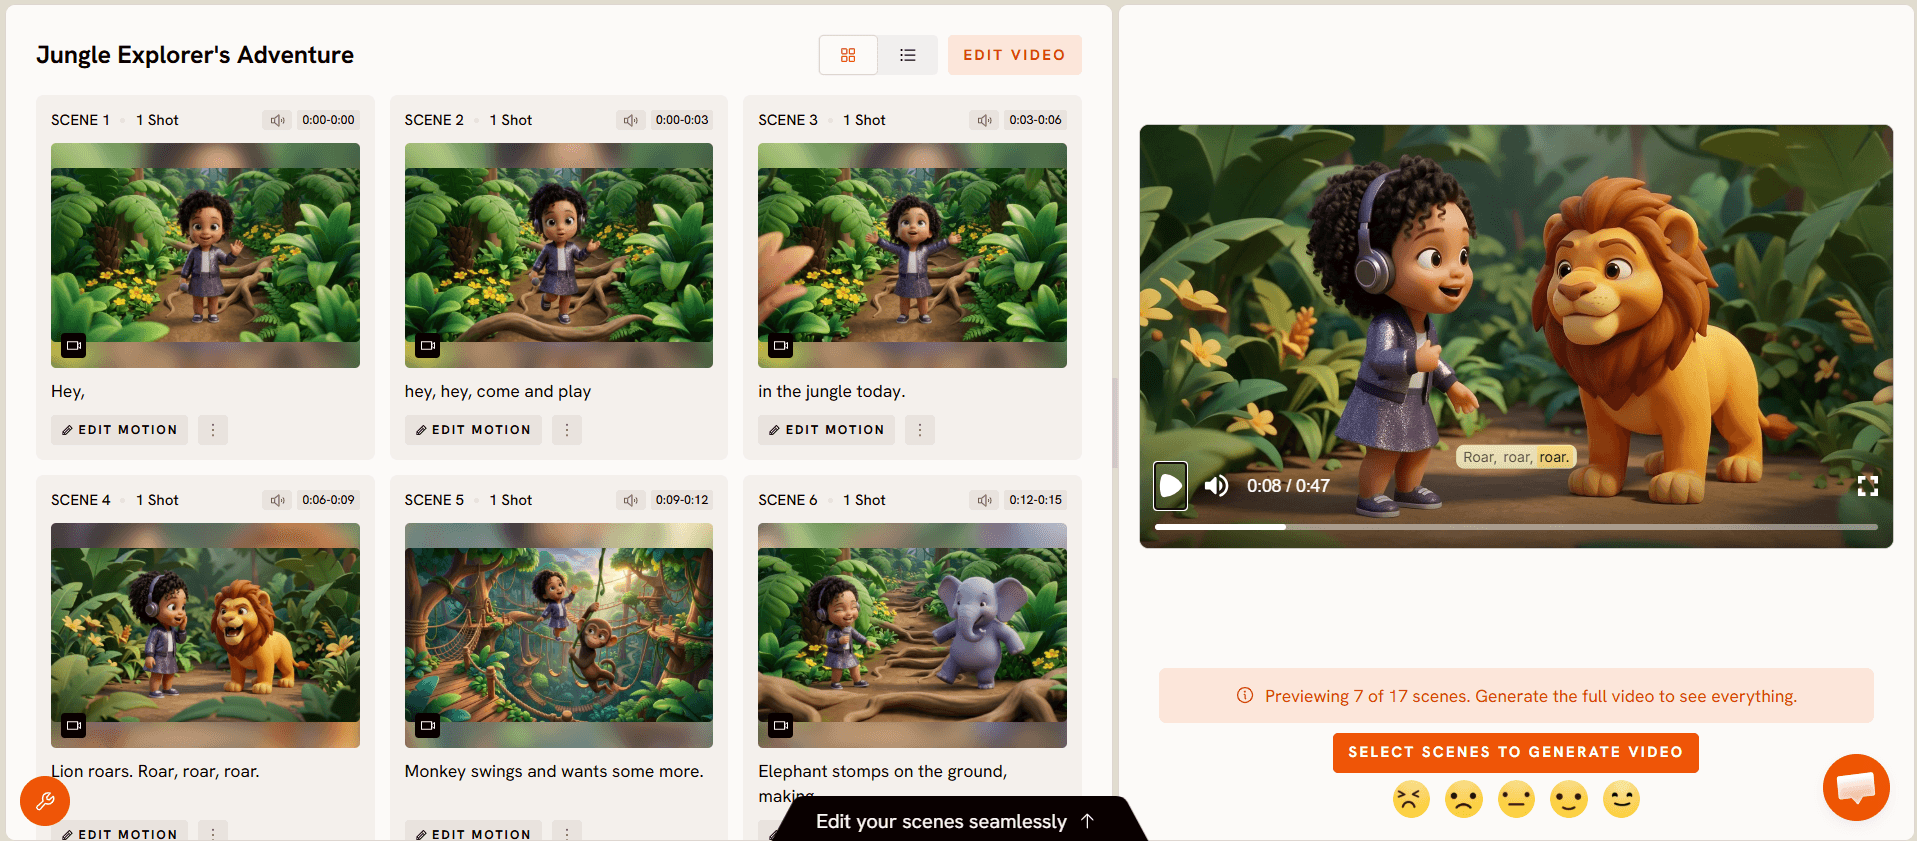
كتابة السيناريو لهذا الجمهور تكافئ الاقتصاد. فكرة واحدة لكل لحظة، وجمل قصيرة، وتكرار متعمّد للعبارة الأساسية. شخصية بمزامنة شفاه تقرأ جملًا كثيفة للكبار تنتج فيديو يعمل تقنيًا ولا يعلّم شيئًا، لأن الإلقاء يسبق المستمع.
مزامنة الشفاه لعدة شخصيات
تعمل مزامنة الشفاه الآن عبر عدة شخصيات بدلًا من شخصية واحدة.
تغطي مزامنة الشفاه لشخصية واحدة الرأس المتحدث، والرأس المتحدث يغطي نطاقًا ضيقًا بشكل مدهش مما يريد الناس صنعه. كل ما هو حواري يقع خارجه. شخصيتان تتبادلان الجمل. معلمة وطالب. مقابلة. عميل ووكيل دعم في فيديو توضيحي لمنتج. أب وطفل في قصة. مقطع نداء وجواب في كورال. في كل هذه الحالات، الرد مهم بقدر الجملة نفسها.
إنتاجها بمزامنة شفاه لشخصية واحدة كان يعني توليد كل متحدث على حدة والقطع بينهم. هذا بطيء، والأهم أنه يبدو كما هو. النصفان لا يتشاركان غرفة أبدًا، واتجاهات النظر لا تتفق، والإضاءة تنحرف، وتوقيت التبادل يجب أن يُصنع في المونتاج بدلًا من أن يُؤدّى. وكل من حاول تزييف محادثة بين شخصين بهذه الطريقة يعرف أن النتيجة تبدو كمونولوجين جالسين جنبًا إلى جنب.
التعامل مع أكثر من متحدث داخل التوليد نفسه يجعل الحوار مخرجًا أصيلًا. يحدث التبادل في مكان واحد، بإعداد إضاءة واحد، وبتوقيت ينتمي إلى المشهد لا إلى خطك الزمني.
هذه أيضًا القدرة الكامنة تحت معظم التغييرات الثلاثة الأخرى. فالفيديو الموسيقي بممثلين مختارين مع بطل ثانٍ غير مغنٍّ يفقد إقناعه لحظة أن تحتاج تلك الشخصية إلى قول شيء. والدرس بشخصية معلمة يتحسن كثيرًا عندما تستطيع شخصية ثانية طرح السؤال الذي يجيب عنه الدرس. مزامنة الشفاه لعدة شخصيات هي ما يجعل هذه الصيغ تتماسك.
كيف تحصل على أقصى استفادة من هذه التغييرات
1. حدّد ممثليك قبل أن تكتب أي شيء. من يغني ومن يظهر ومن يتكلم ثلاثة أسئلة مختلفة الآن، والإجابة عنها مسبقًا تغيّر ما تكتبه. الأغنية ذات البطل الثاني تحتاج إلى مشاهد يستطيع ذلك البطل أن يكون فيها.
2. اجمع صور المصدر بشكل صحيح. وجوه أمامية جيدة الإضاءة، ووجه واضح واحد في كل صورة. اصرف الدقيقة الإضافية هنا بدلًا من تشخيص انحراف الهوية لاحقًا.
3. ولّد في الوضع الافتراضي أولًا. تحسينات تكوين المشهد تنطبق هناك، فيكون تشغيلك الأول اختبارًا عادلًا للتدفق لا تمرين ضبط إعدادات. غيّر الأمور بعد أن ترى خط أساس.
4. اكتب الحوار كتبادل لا كخطابين. الآن وقد صار بإمكان أكثر من شخصية أن تتكلم، تتفوق الجمل القصيرة المتناوبة على الكتل الطويلة. دع الشخصية الثانية تقاطع أو تسأل أو تتفاعل.
5. في محتوى الأطفال، اكتب للإيقاع لا للصفحة. فكرة واحدة لكل لحظة، كرّر العبارة الأساسية، واترك مجالًا للشخصية لأن يُنظر إليها لا أن يُستمع إليها فقط.
أمثلة على الأوصاف
1. أداء فرقة كاملة. فرقة إندي من أربعة أفراد تؤدي في مستودع محوَّل عند الغسق، وأضواء خيطية في الأعلى وغبار في الهواء. قطع بين المغني عند الميكروفون، وأصابع تتحرك على عنق غيتار باص، وعازف الطبول مضاء جزئيًا في الخلف، ولقطة واسعة للغرفة مع جمهور صغير على هيئة ظلال. إضاءة عملية دافئة، وعمق ميدان ضحل، وإحساس الكاميرا المحمولة في اللقطات الواسعة. جرّب هذا في Atlabs Music Performance
2. معالجة رومانسية ببطلين. سطح مبنى في الساعة الزرقاء، وضباب المدينة يلتقط آخر الضوء. يؤدي الفنان أمام الأفق بينما تتحرك شخصية ثانية لا تغني أبدًا عبر المشاهد التي تصفها الكلمات، جالسة على الحافة، تنزل درج السلم، تراقب من عتبة الباب. تدرّج لوني ناعم بارد مع درجات بشرة دافئة، وحركات كاميرا بطيئة طوال الوقت. جرّب هذا في Atlabs Music Performance
3. التركيز على آلة منفردة. عازف واحد على بيانو عمودي في غرفة تدريب فارغة، وضوء الصباح يدخل من نوافذ عالية. تناوب بين لقطة واسعة للغرفة، ولقطة قريبة على اليدين، ولقطة جانبية بمستوى العين، ودفع بطيء نحو الوجه عند العبارة الأخيرة. لوحة ألوان خافتة، وضوء طبيعي فقط. جرّب هذا في Atlabs Music Performance
4. شرح بشخصية معلّمة. معلمة رسوم متحركة ودودة في صف مشرق تشرح لماذا يطفو الجليد، وتخاطب الكاميرا مباشرة. ترفع كأس ماء وتُسقط مكعب ثلج فيه وتشير إليه وهو يطفو. جمل قصيرة وفكرة واحدة في كل مرة، والعبارة الأساسية تتكرر في النهاية. ألوان دافئة وخلفية بسيطة، ولا شيء ينافس وجهها. جرّب هذا في Atlabs Kids Performance
5. درس بشخصيتين. شخصية معلّمة وطالب فضولي في حديقة. يسأل الطالب لماذا تغيّر الأوراق لونها، وتجيب المعلمة في ثلاث خطوات قصيرة، ويعيد الطالب الإجابة. تتكلم الشخصيتان أمام الكاميرا بإضاءة واتجاهات نظر متطابقة. لوحة ألوان مشرقة وناعمة بأسلوب كتب الحكايات. جرّب هذا في Atlabs Kids Performance
شغّلها في Atlabs
الأسئلة الشائعة
هل يمكنني استخدام وجهي في فيديو موسيقي الآن؟ نعم. يقبل أداء الموسيقى صورك الخاصة في بداية التدفق، للشخصيات المغنية وغير المغنية على حد سواء.
ما فائدة عضو الطاقم غير المغني؟ أي شخصية تظهر دون أن تؤدي الغناء. بطل رومانسي، أو شخصية في القصة، أو صاحب تحية، أو أي شخص يهم حضوره الفكرة لا الأداء.
هل يحتاج تحسين تكوين المشهد إلى إعدادات خاصة؟ لا. المجال الأوسع من التكوين والتأطير وأنواع المشاهد ينطبق في الوضع الافتراضي، فيعكسه أول توليد دون أي ضبط.
ما أنواع اللقطات التي ينتجها أداء الموسيقى الآن؟ إلى جانب الغناء أمام الكاميرا، يؤلّف مشاهد متنوعة تشمل مشاهد الآلات والأداء على المسرح داخل الفيديو نفسه.
فيمَ تفيد مزامنة الشفاه لعدة شخصيات؟ في أي فيديو يتكلم فيه أكثر من شخص. المحادثات وتبادلات المعلم والطالب والمقابلات ومقاطع النداء والجواب كلها تصبح ممكنة في توليد واحد.
ماذا يمكنني أن أصنع بشخصية معلّمة بمزامنة شفاه؟ شرح المفاهيم، والأصوات الصوتية وأصوات الحروف، وتسلسلات العدّ، والعلوم خطوة بخطوة، وتعلّم اللغات، والدروس القائمة على القصص. أي شيء يؤدّيه مقدّم بشكل أفضل من السرد الصوتي.
هل تعمل هذه التغييرات معًا؟ نعم، وهنا تكمن معظم القيمة. اختيار الممثلين مع مزامنة الشفاه لعدة شخصيات هو ما يجعل الفيديو الموسيقي ببطلين أو الدرس بشخصيتين يتماسك كمشهد واحد.
حصيلة هذا كله
الخيط المشترك بين التغييرات الأربعة هو أن العمل الذي كان يحدث بعد التوليد صار يحدث أثناءه. كان تنوع اللقطات مشكلة مونتاج. وكانت الشخصية الثانية توليدًا ثانيًا. وكان الحوار مقطعين مقصوصين معًا. أما اختيار الممثلين فلم يكن متاحًا فعليًا على الإطلاق.
بالنسبة لصنّاع الموسيقى، يعني هذا فيديو يبدو مقصوصًا لا مولّدًا، يضم الفنان الحقيقي والأشخاص الحقيقيين الذين تدور حولهم الأغنية. وبالنسبة لصنّاع المحتوى التعليمي، يعني درسًا بمقدّم بدلًا من عرض شرائح مروي. وللاثنين يعني توليدات منفصلة أقل للتوفيق بينها، ومواضع أقل تظهر فيها الدرزات.