Un jeune homme est assis sur un canapé à côté d'une femme rousse. Quelque chose lui traverse l'esprit. Il se lève, crie « TANTE MAY ! » et court dans le couloir. Pendant qu'il court, il rajeunit. Pas avec une coupe, pas avec un flash, mais de façon continue, foulée après foulée, jusqu'à ce que la personne qui ouvre la porte au bout du couloir soit un petit garçon. Derrière cette porte attend la femme qui l'a élevé, et elle le rattrape.
Si vous avez grandi avec Spider-Man, vous savez déjà pourquoi cela touche. Le personnage a toujours fonctionné parce que le héros aux pouvoirs est aussi le gamin qui n'a jamais cessé d'avoir besoin de sa tante. Dix secondes, un plan, aucune coupe, et toute la relation est à l'écran sans une ligne d'exposition.
Ce pas-à-pas explique exactement comment ce clip est réalisé. Les personnages sont ici des designs stylisés originaux plutôt que des copies du costume ou de l'apparence de quelqu'un, ce qui fait qu'un hommage reste un hommage. La technique elle-même fonctionne pour tout court métrage animé émouvant où un personnage doit rester reconnaissable alors que tout en lui change.
Pourquoi la transformation en plan unique est la partie difficile
La plupart des vidéos IA ressemblent à des vidéos IA à cause de ce qui se passe entre les plans. Générez deux clips du même personnage et vous obtenez deux personnes légèrement différentes. La mâchoire est plus étroite, la raie des cheveux est de l'autre côté, la veste est d'un autre bleu. Le public le remarque instantanément, même sans savoir nommer ce qui cloche, et le moment émotionnel meurt dès que le visage n'est plus le même.
Une séquence de régression d'âge aggrave ce problème au lieu de l'atténuer, car le personnage est justement censé changer. Le modèle doit comprendre quels changements font partie de l'histoire, c'est-à-dire la taille, les proportions, la douceur du visage, et lesquels sont des erreurs, c'est-à-dire l'identité, la couleur des cheveux, la logique vestimentaire, la forme précise des yeux. Si cette frontière est mal placée, le public voit une autre personne apparaître à mi-couloir plutôt que la même personne qui rajeunit.
La solution n'est pas un meilleur prompt de mouvement. C'est de verrouiller l'identité entièrement en dehors du prompt vidéo. Vous construisez d'abord les personnages sous forme d'images, puis vous donnez ces images au modèle vidéo comme références nommées et vous lui dites, dans le prompt, exactement quelle référence gouverne quel personnage à quelle seconde. Le modèle cesse d'inventer des visages et se met à animer ceux que vous lui avez donnés.
Les deux outils sur lesquels tout repose
Les deux étapes se déroulent dans Atlabs.
GPT Image 2 construit les références de personnages. C'est là que vous dépensez l'essentiel de vos efforts, car chaque image de la vidéo finale hérite de ces images. Vous ne faites pas de concept art ici. Vous faites une fiche de casting à laquelle le modèle vidéo doit obéir.
Seedance 2.0 Ref to Video génère le clip. Seedance 2.0 est le bon modèle pour cela, car il gère le travail de personnages stylisés et l'animation faciale expressive mieux que les modèles photoréalistes, et le mode Ref to Video permet de passer plusieurs images de référence étiquetées que vous pouvez appeler par leur nom dans le prompt. C'est cet étiquetage qui rend possible un plan multi-personnages et multi-étapes en une seule génération.
Pas à pas
Partie 1 : créer vos références de personnages dans GPT Image 2
1. Ouvrez GPT Image 2 et générez votre première référence. Rendez-vous sur GPT Image 2. Cette première image établit la version adulte de votre personnage et de toute personne qui partage avec lui la scène d'ouverture. Rédigez le prompt comme une description de casting plutôt que comme un moodboard. Teint, coiffure et couleur de cheveux, couleur des yeux, vêtements précis, posture, tout doit être énoncé clairement, car tout ce que vous laissez flou est quelque chose que le modèle vidéo décidera à votre place plus tard.
La référence de scène d'ouverture utilisée pour ce court décrit un jeune homme aux cheveux foncés et une femme rousse sur un canapé beige dans une lumière intérieure chaude et dorée, de face, plan taille, dans un style de film d'animation 3D soigné en 16:9. De petits détails portent l'hommage sans rien copier : un motif géométrique discret en forme de toile à l'encolure de sa chemise fait plus de travail qu'un costume. Le prompt complet se trouve dans la section des prompts ci-dessous.

2. Générez votre deuxième référence : la version plus jeune et la femme âgée. Même outil, nouvelle image. Celle-ci porte le garçon en lequel l'homme se transforme et la femme âgée qui attend au bout du couloir. Le détail essentiel ici est que le garçon doit apparaître comme une version plus jeune plausible de l'adulte de votre première image. Même couleur de cheveux, même couleur d'yeux, même forme de visage adoucie par l'âge. Si les deux images ne concordent pas sur ces points, la transformation ressemblera à un remplacement plutôt qu'à une régression.
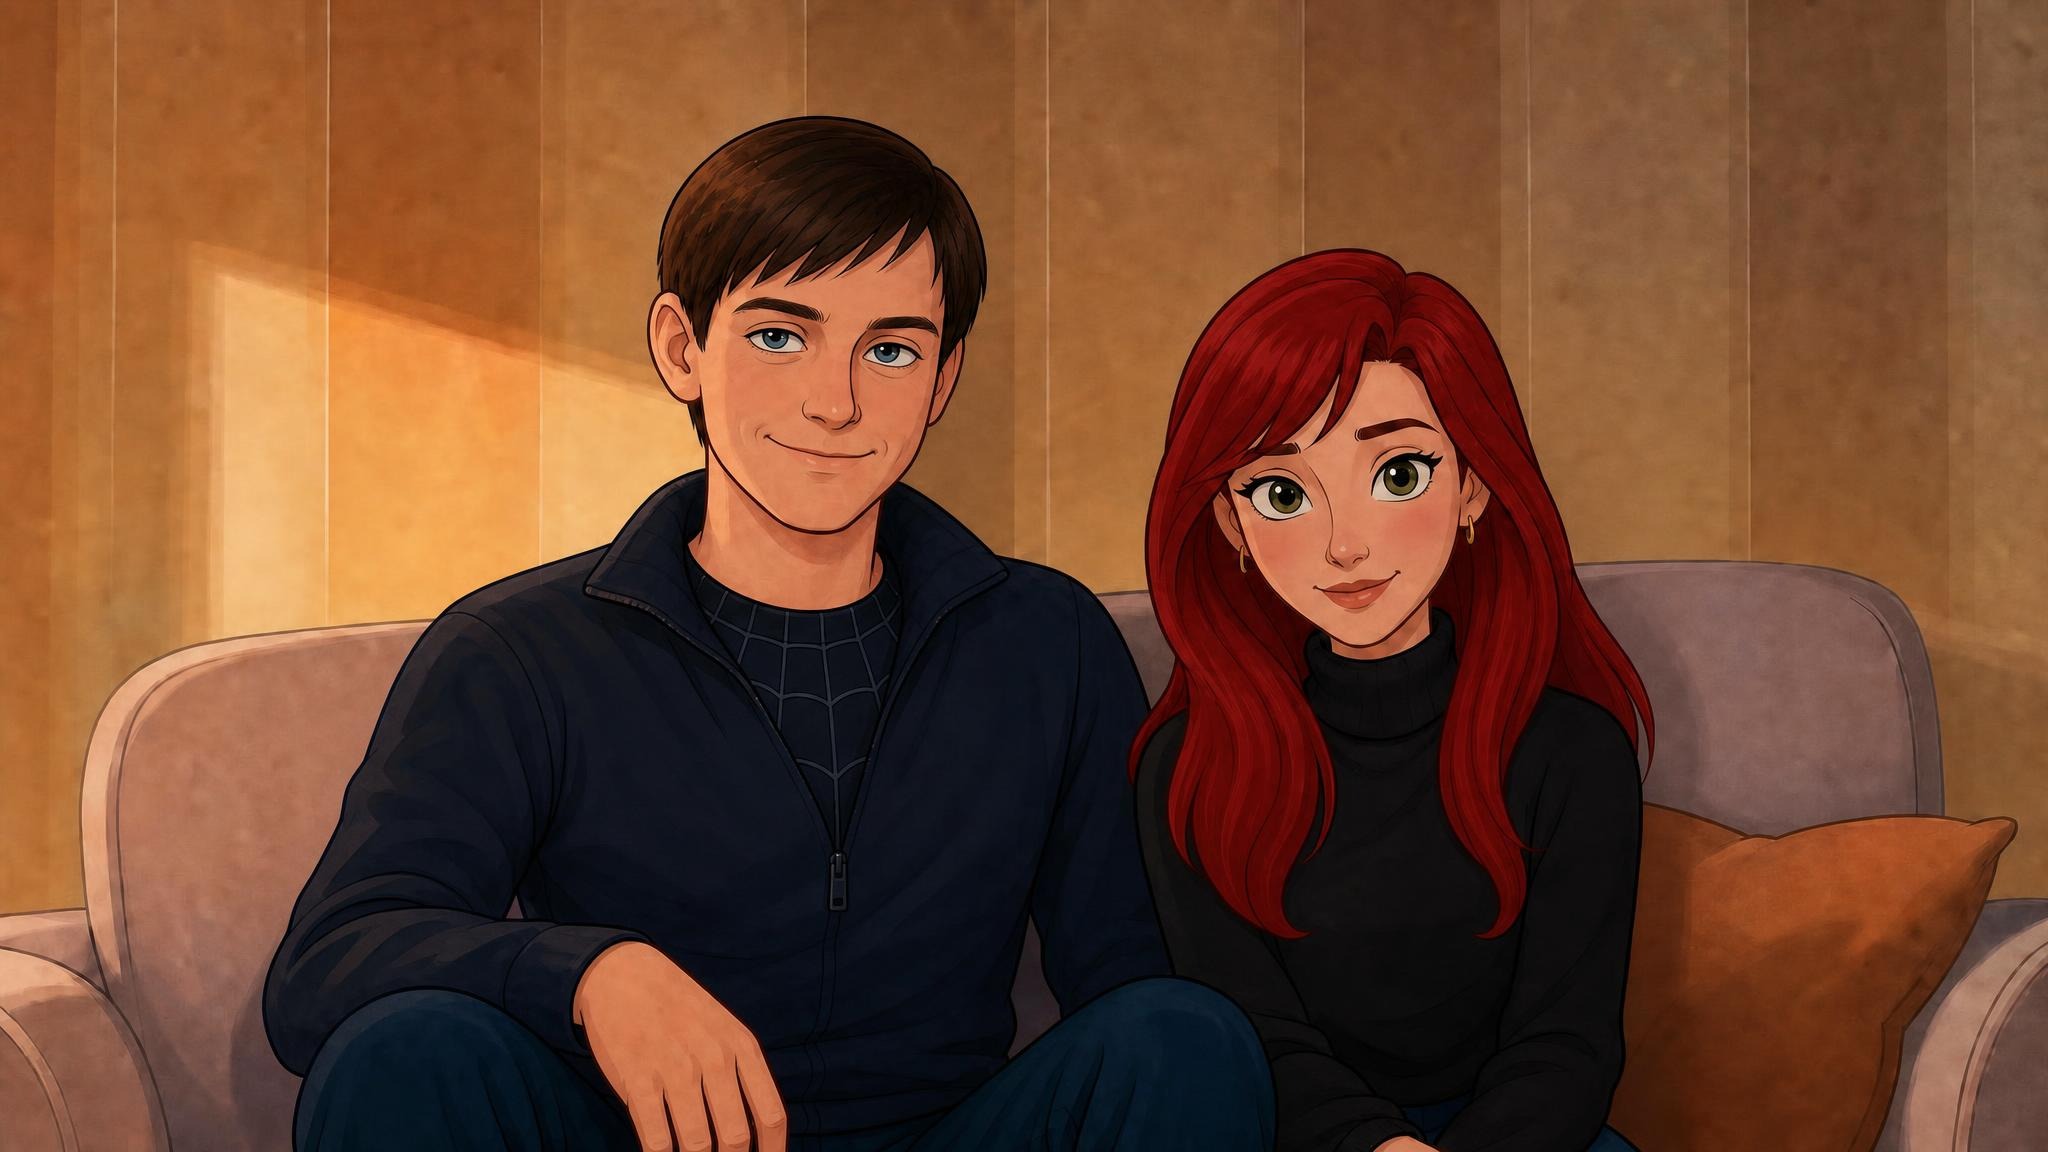
3. Comparez les deux images entre elles avant de continuer. Placez-les côte à côte. Le langage de l'éclairage correspond-il, intérieur chaud et doré dans les deux. Le style d'animation correspond-il, même niveau de stylisation, même logique de taille des yeux, même rendu de la peau. L'identité tient-elle malgré l'écart d'âge. Corrigez tout décalage maintenant, car vous ne pourrez pas le corriger plus tard à l'étape vidéo.
Prêt à créer vos propres références ? Commencer dans GPT Image 2.
Partie 2 : générer le plan dans Seedance 2.0 Ref to Video
4. Ouvrez Seedance 2.0 Ref to Video et importez les deux références. Rendez-vous sur Seedance 2.0 Ref to Video. Importez l'image de la scène du canapé et celle des retrouvailles. Elles deviennent @img1 et @img2, et ces étiquettes sont la façon dont vous vous adressez à chaque personnage dans le prompt.
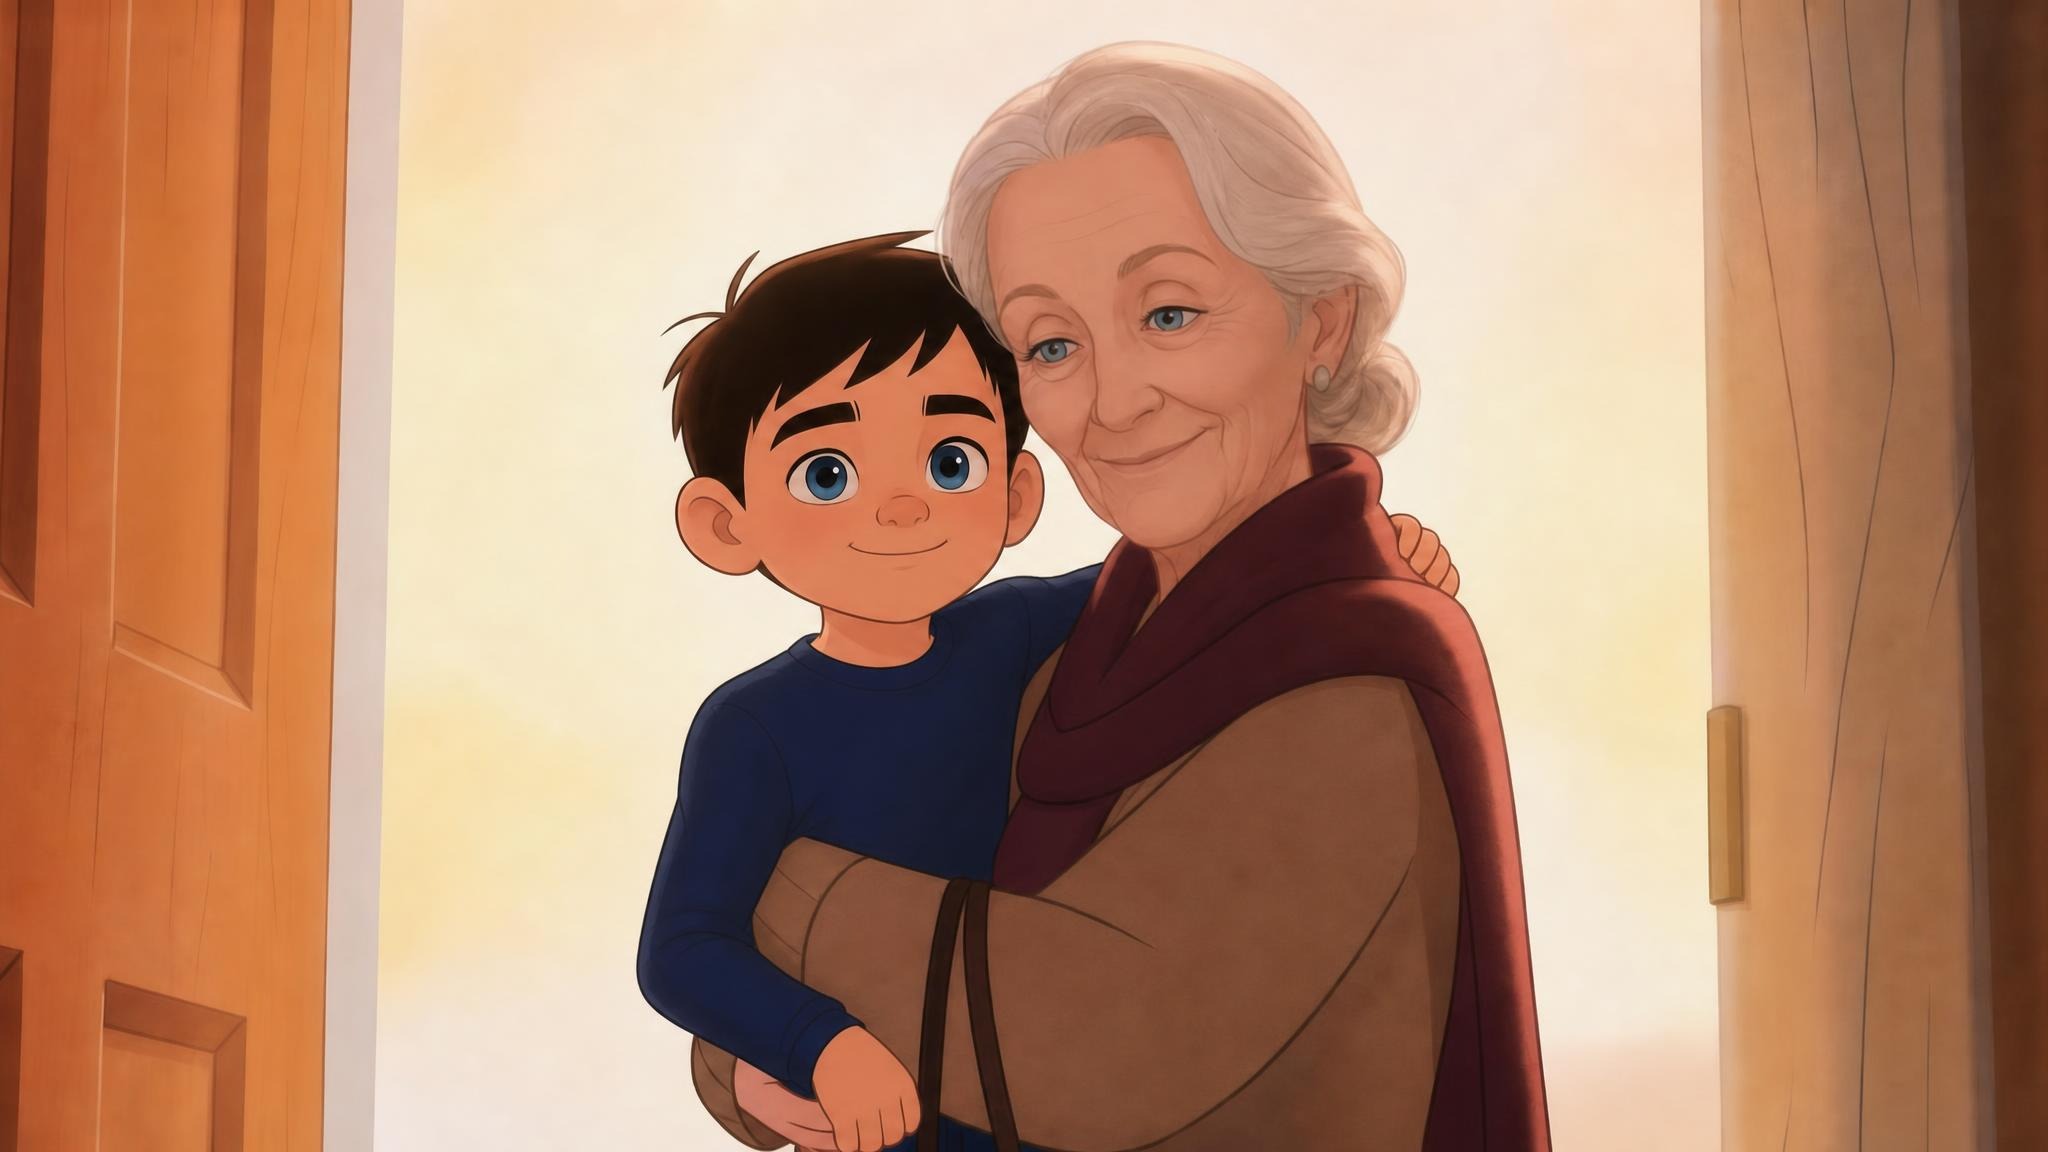
5. Rédigez le prompt comme une chronologie, pas comme une description. C'est ce qui sépare un clip qui fonctionne d'un clip qui fonctionne presque. Plutôt que de décrire la scène dans son ensemble, découpez les dix secondes en temps étiquetés et indiquez ce qui se passe dans chacun :
Les deux premières secondes sont la prise de conscience. L'homme se lève, crie « TANTE MAY ! » et se met en mouvement. Les secondes deux à six sont la course et la transformation, et c'est là que vous précisez que le vieillissement inversé se produit de façon continue pendant qu'il court, en passant d'adulte à jeune adulte, adolescent, puis jeune garçon, sans que la caméra ne coupe jamais. Les secondes six à huit sont la porte. Les secondes huit à dix sont les retrouvailles et l'étreinte.
6. Ajoutez le bloc de contraintes. Sous la chronologie, indiquez ce que le modèle ne doit pas faire. Pas de flash, pas de fondu, pas de téléportation, pas de morphing brutal, pas de coupes pendant la transformation, pas de personnages dupliqués, pas de texte ni de filigrane. Les contraintes négatives font beaucoup de travail dans un plan comme celui-ci, car le moyen le plus simple pour un modèle de résoudre une transformation difficile est de la cacher derrière un montage, et vous lui retirez explicitement cette option.
7. Précisez séparément la caméra, l'éclairage, l'émotion et l'audio. Donnez à chacun son propre bloc. La caméra couvre le passage du plan moyen au travelling puis au gros plan intime. L'éclairage couvre la lumière intérieure chaude qui devient encore plus chaude le long du couloir. L'émotion énonce l'intention pour que l'animation faciale ait une direction. L'audio couvre la montée orchestrale, la réplique criée, les pas et l'ambiance sonore de la pièce.
8. Générez, puis comparez avec vos références. Regardez-le une fois pour la transformation et une fois pour l'identité. La transformation doit être visible pendant qu'elle se produit plutôt que résolue hors champ. Le garçon à la porte doit être le garçon de votre deuxième référence, et la femme âgée doit correspondre exactement à la sienne. Si l'identité dérive, resserrez le langage de référence dans le prompt plutôt que de régénérer à l'aveugle.
Pourquoi cette approche tient
Verrouiller les références supprime les approximations. Comme @img1 et @img2 sont de vraies images plutôt que des descriptions, le modèle fait correspondre des pixels, il n'interprète pas des adjectifs. Deux personnes qui lisent « cheveux courts brun foncé » imaginent deux coupes différentes, et deux générations du même modèle aussi. Une image supprime complètement cette ambiguïté.
Les temps horodatés donnent au modèle une structure à remplir plutôt qu'une histoire à inventer. Un prompt de dix secondes rédigé en prose est compressé de façon imprévisible, et le modèle décide de la durée de chaque moment. Écrit en 0:00 à 0:02, 0:02 à 0:06, 0:06 à 0:08, 0:08 à 0:10, le rythme vous appartient. La course obtient quatre secondes pleines parce que c'est là que la transformation doit être lisible.
Seedance 2.0 a été conçu pour la performance de personnages stylisés. Tout le court repose sur le visage qui porte l'émotion, et le modèle gère les traits animés expressifs et l'interaction physique crédible mieux que les modèles réglés pour le photoréalisme. Nommer le bon modèle pour le travail compte plus que la longueur du prompt.
La direction audio dans le prompt évite une passe séparée. La montée orchestrale, le nom crié, les pas et l'ambiance sonore sont tous spécifiés avec les images, si bien que le sommet émotionnel de la musique tombe sur l'étreinte plutôt que d'être monté après coup pour s'y adapter.
Conseils de pro
Passez votre temps sur les images de référence, pas sur le prompt vidéo. Une référence faible ne peut pas être sauvée par un prompt vidéo plus long, et une référence solide fait fonctionner un prompt vidéo court. Si vous en êtes à la huitième génération vidéo pour corriger un visage, le problème se situe en amont.
Rédigez vos négatifs aussi précisément que vos positifs. « Pas de coupes » est plus faible que « pas de flash, pas de fondu, pas de téléportation, pas de morphing brutal, pas de coupe pendant la transformation ». Vous fermez tous les raccourcis que le modèle pourrait emprunter, et chacun que vous laissez ouvert est un raccourci qu'il pourrait prendre.
Donnez le temps le plus long au moment le plus difficile. La transformation obtient quatre des dix secondes parce qu'elle doit être lisible. Si vous la comprimez à deux, le modèle doit aller trop vite et résoudra le changement d'une façon que vous n'avez pas demandée. Répartissez le temps d'écran selon la difficulté, pas selon l'importance dans l'intrigue.
Gardez un éclairage continu entre les deux images de référence. Intérieur chaud et doré dans la première, intérieur chaud et doré dans la seconde. Quand les deux références se contredisent sur la direction de la lumière ou la température de couleur, le modèle vidéo doit les concilier en plein plan et la couture se voit.
FAQ
Combien d'images de référence puis-je utiliser ? Ref to Video est conçu autour du passage de plusieurs références étiquetées, chacune adressée par son nom dans le prompt. Ce court en utilise deux, une par scène, la seconde référence portant deux personnages. Regrouper dans une même référence les personnages qui apparaissent ensemble maintient leur échelle relative et leur éclairage cohérents.
Pourquoi ne pas générer la transformation en clips séparés puis les monter ensemble ? Vous le pouvez, et ce sera plus facile, mais cela ne produira pas le même effet. Le poids émotionnel de ce plan vient du fait que le public regarde le changement se produire sans coupe derrière laquelle se cacher. Dès que vous montez, cela devient un montage de scènes plutôt qu'une transformation.
Puis-je construire cela autour d'un personnage existant comme Spider-Man ? Créez votre propre design de personnage plutôt que de reproduire un costume, un logo ou la ressemblance d'un acteur existants. Ce à quoi les gens réagissent, c'est le moment émotionnel, et un personnage original stylisé le porte tout aussi bien. De petits détails suggestifs, une texture en forme de toile à l'encolure plutôt qu'une combinaison complète, gardent l'hommage lisible sans rien copier.
Puis-je faire cela avec une vraie personne plutôt qu'un personnage animé ? Le workflow est identique. Créez d'abord vos références, puis passez-les à Ref to Video. La 3D stylisée est utilisée ici parce que Seedance 2.0 gère particulièrement bien les visages animés expressifs, mais la méthode de verrouillage des références s'applique quel que soit le style.
Que faire si l'identité du personnage dérive en cours de route ? Resserrez le langage de référence dans le prompt avant de régénérer. Rappeler qu'une référence précise gouverne un personnage précis, et nommer ce qui doit être préservé, règle généralement le problème. S'il persiste, c'est probablement que les deux images de référence ne s'accordent pas sur l'identité dès le départ.
Quelle durée peut avoir le clip ? Celui-ci est écrit pour dix secondes, ce qui suffit pour une structure en quatre temps avec un arc émotionnel clair. Les plans plus longs laissent plus de place à la dérive, donc construire une pièce plus longue à partir de plusieurs plans étroitement contrôlés tient généralement mieux que de demander une seule longue génération.
Verdict final
La raison pour laquelle l'essentiel de l'animation IA sonne creux est qu'elle semble assemblée plutôt que jouée. Les visages changent d'un plan à l'autre, les transformations sont cachées derrière des montages, et le moment émotionnel ne passe jamais parce que le public se demande en silence s'il regarde bien la même personne.
Verrouiller vos personnages sous forme d'images dans GPT Image 2, puis les diriger temps par temps dans Seedance 2.0 Ref to Video résout les deux problèmes d'un seul coup. Vous validez la distribution avant qu'une seule image ne bouge, puis vous écrivez le plan comme un réalisateur plutôt que comme un ingénieur de prompts. Créez vos propres personnages plutôt que de copier ceux qui existent, et l'hommage reste le vôtre.