30초짜리 프롬프트가 12초만 건질 만한 결과물을 만들어내는 이유
길고 정성스러운 문단을 작성합니다. 한 여성이 코인빨래방으로 걸어가 세탁기에 빨래를 넣고, 전화를 받고, 상대방과 말다툼을 벌인 뒤, 혼자 자리에 앉습니다. 하지만 결과물로 나타난 클립에서는 여성이 문을 열고 들어가는 데만 20초를 소요하고, 전화 통화는 시작조차 하지 않습니다. 출력물 자체에 오류가 있는 것은 아닙니다. 모델에 구체적인 타임라인 설정이 없었기 때문에, 첫 문장에 모든 분량을 할당해 버린 것뿐입니다.
이것이 장편 비디오 생성의 가장 고질적인 문제이며, 모델의 한계라기보다는 작성의 문제입니다. Seedance 2.5는 동기화된 사운드와 함께 한 번에 약 30초의 연속적인 영상을 생성하므로, 이제 단 하나의 프롬프트 안에 전체 씬을 온전히 담아낼 수 있습니다. 다만, 이 씬의 템포를 어떻게 조절하고 싶은지까지 모델이 스스로 추측해 주지는 않습니다.
Seedance 2.5는 Atlabs에서 사용할 수 있으므로, 본 가이드에 소개된 모든 내용은 별도의 ByteDance 계정 없이 오늘 바로 실행해 볼 수 있습니다.
Atlabs에서 Seedance 2.5 사용해보기
30초 영상에서 프롬프트 구조가 더욱 중요한 이유
4초짜리 영상에서 프롬프트는 단순한 묘사입니다. 단 한 순간만 존재하므로, 모델은 그 순간을 렌더링하고 멈춥니다. 2024년과 2025년에 작성된 대부분의 프롬프트 가이드는 이 방식을 전제로 하고 있으며, 그렇기 때문에 마치 형용사 나열처럼 읽히는 것입니다.
반면 30초짜리 영상에서 프롬프트는 하나의 타임라인 일정표입니다. 더 이상 단일 이미지를 묘사하는 것이 아니라 여러 이벤트에 걸쳐 시간을 배분하는 작업이며, 구체적으로 설명하지 않은 모든 순간은 모델이 임의로 채워 넣게 됩니다. 이는 프레임 내의 다른 모든 요소에도 동일하게 적용됩니다. 4초 동안에는 캐릭터의 얼굴이 어색하게 변할 시간이 거의 없지만, 30초 동안에는 무언가로 고정해 두지 않는 한 정체성, 의상, 세트 소품 등이 모두 일관성을 잃고 흐트러질 수 있습니다.
이를 해결하기 위해 존재하는 것이 바로 레퍼런스(참조) 시스템입니다. Seedance 2.5는 이미지, 비디오, 오디오에 걸쳐 최대 50개의 입력을 수용하며, 모델은 사용자가 제공한 순서대로 가중치를 부여합니다. 즉, 먼저 제공된 레퍼런스가 더 큰 영향력을 가집니다. 태그를 지정하지 않은 레퍼런스도 사용되기는 하지만, 모델이 임의로 판단하여 사용하기 때문에 대다수의 일관성 관련 불만이 바로 여기서 발생하게 됩니다.
품질의 차이를 결정짓는 세 가지 핵심 습관이 있습니다. 클립을 시간대별 비트로 분할하고, 각 레퍼런스에 제어 대상을 구체적으로 태깅하며, 화면을 묘사하듯 오디오도 의도적으로 상세히 묘사하는 것입니다. 아래의 모든 내용은 이 세 가지 원칙을 바탕으로 구성되어 있습니다.
완벽한 프롬프트 공식
ByteDance의 자체 프롬프트 구조는 감독의 브리프 형태로 구성되며, 순서는 다음과 같습니다: 주체(인물/대상), 행동 또는 이벤트, 배경 및 환경, 시각적 스타일, 카메라 워크, 사운드.
템플릿 형태로 표현하면 다음과 같습니다: [주체]가 [배경]에서 [행동]을 한다. 이미지는 [시각적 스타일]이다. 카메라는 [카메라 워크]를 적용한다. 사운드에는 [오디오]가 포함된다.
실제 작동하는 구체적인 예시로 나누어 보겠습니다. 주체 및 행동: 도예가가 물레 위에서 연한 푸른색 잔을 완성한다. 배경: 새벽녘의 작은 공방, 그녀의 뒤로 굽지 않은 작품들이 선반에 놓여 있다. 시각적 스타일: 부드러운 아침 햇살, 젖은 점토의 윤기, 깔끔한 작업대. 카메라: 물레의 미디엄 샷, 질감을 향해 천천히 푸시인한 다음 전면 선반 뷰로 컷 전환. 사운드: 물레의 낮은 웅웅거림, 점토의 마찰음, 은은한 실내 앰비언스.
카메라 가이드라인에서 감성적인 표현 대신 구체적인 움직임을 지칭하고 있다는 점에 주목하세요. "영화 같은(Cinematic)"은 명확한 지시가 아닙니다. "천천히 푸시인(Slow push in)", "스테디캠 팔로우(steadicam follow)", "윕팬(whip pan)", "랙포커스(rack focus)" 등이 명확한 지시어입니다. 프레임이 물리적으로 어떻게 움직이는지를 정확히 묘사하기 때문입니다.
대략 10초 또는 12초가 넘어가는 영상의 경우, 이 공식에 시간 계획(스케줄)을 추가하세요. 비트를 할당해 보세요: 0초부터 8초까지, 8초부터 18초까지, 18초부터 30초까지 무슨 일이 일어나는지 정의합니다. 그리고 비트를 서술하기 전에, 각 레퍼런스가 어떤 자산을 제어하는지 모델에 명시하는 줄을 한 줄씩 작성해 줍니다. 예를 들어 이미지 1은 인물의 정체성과 의상, 비디오 1은 카메라 움직임과 템포 전용, 오디오 1은 대사와 리듬 전용으로 지정하는 식입니다. 이 두 가지 추가 요소(비트 및 역할 지정)는 무작정 서술을 늘리는 것보다 출력물의 오류를 훨씬 더 잘 해결해 줍니다.
Atlabs에서 씬 제작 시작하기
이를 위한 Atlabs의 워크플로우
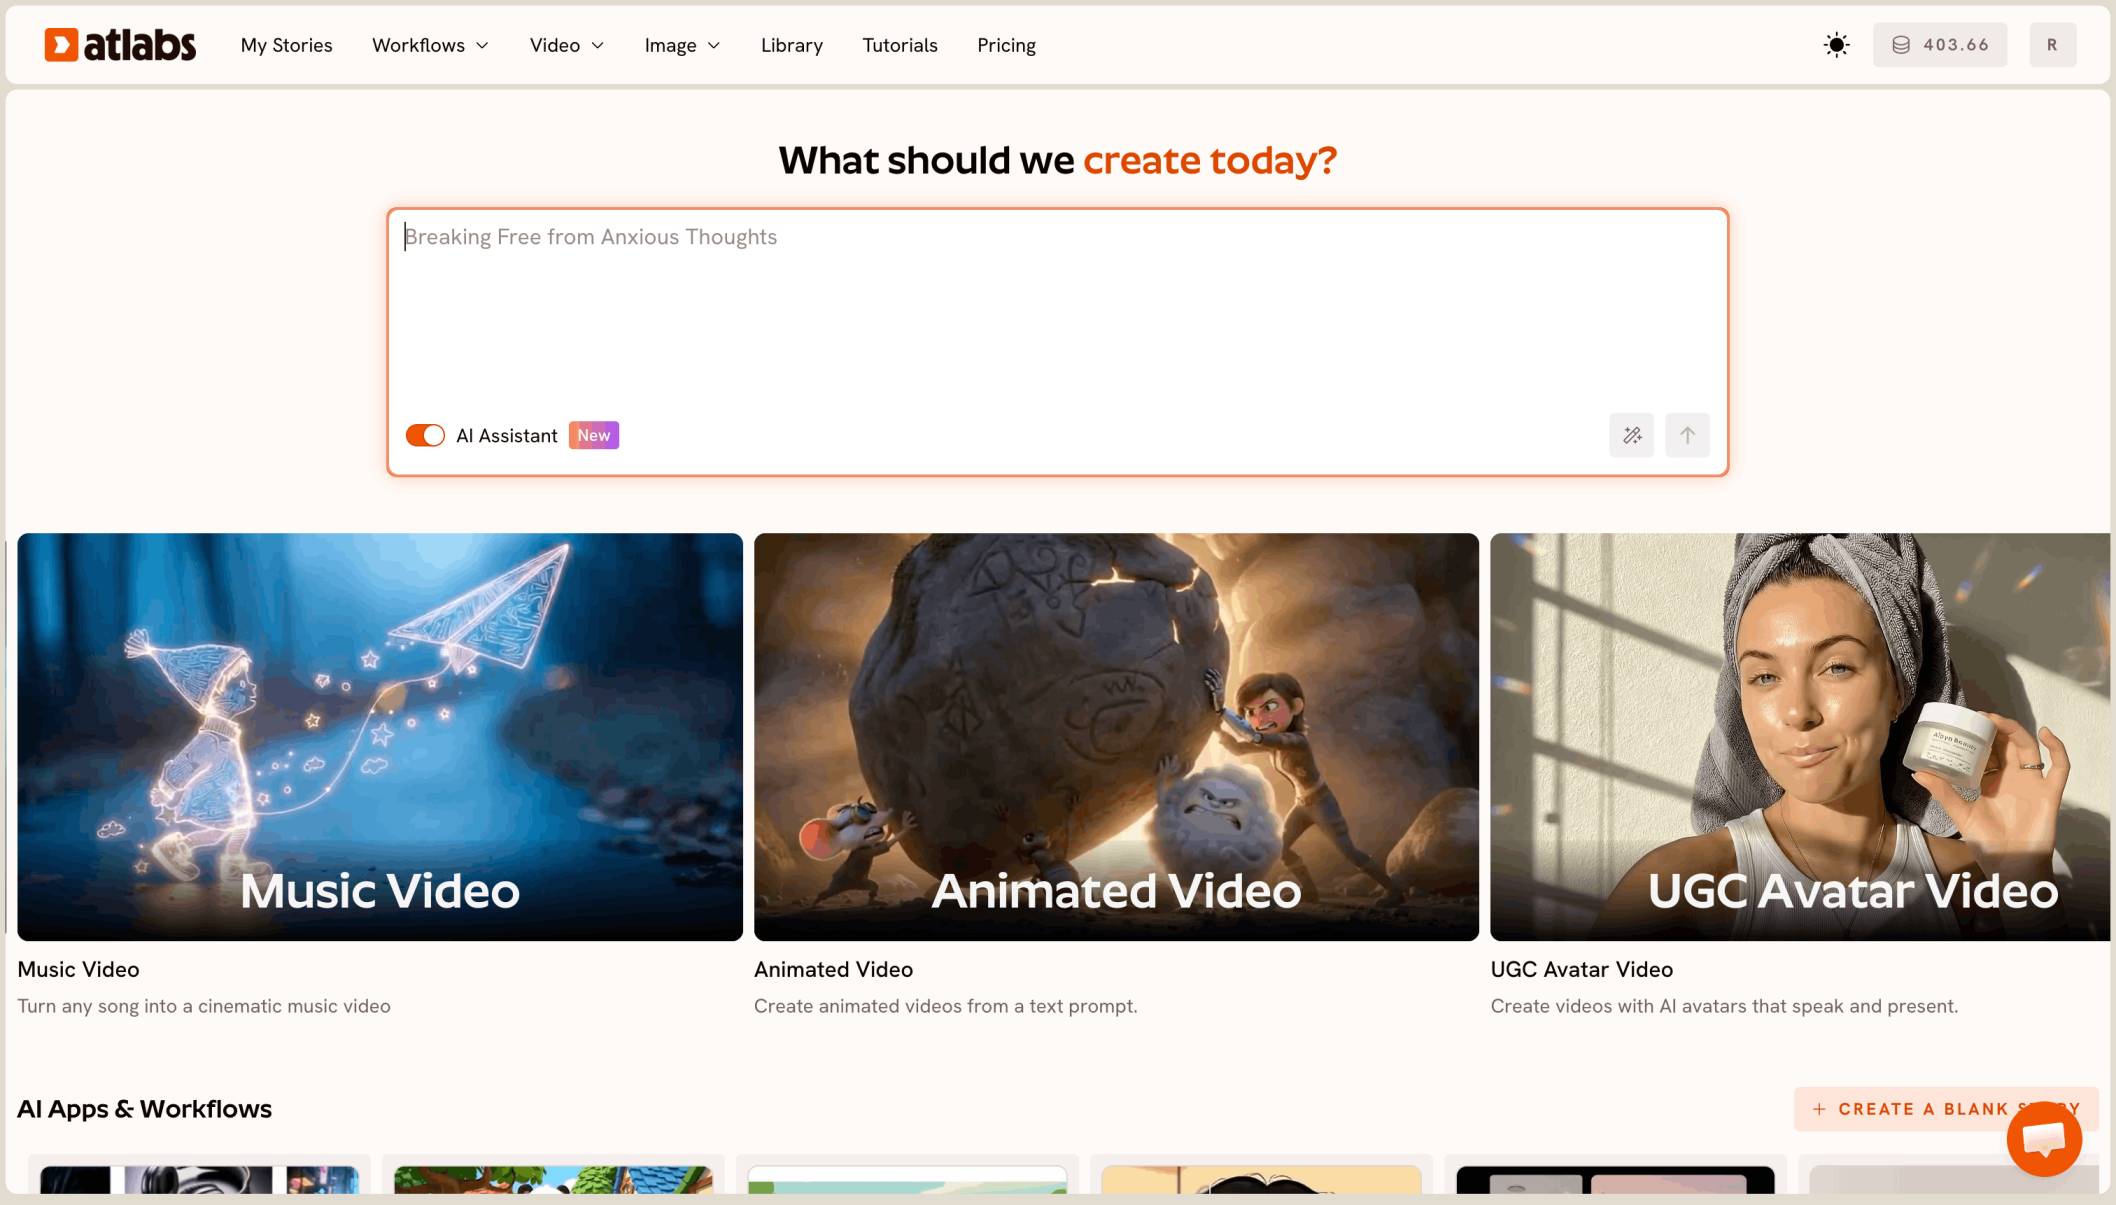
Atlabs에서는 Kling, Veo, Hailuo, Wan과 같은 모델 라인업과 함께 Seedance 2.5를 바로 선택하여 사용할 수 있습니다. 즉, 씬을 한 번만 작성하면 매번 다른 툴에 맞게 다시 작성할 필요 없이 원하는 모델만 선택하면 됩니다.
이러한 방식의 프롬프팅과 가장 잘 맞아떨어지는 워크플로우는 'Script to Video(스크립트로 비디오 생성)'입니다. 기억에만 의존해 긴 줄글을 쓰는 대신, 정해진 양식을 채워 넣는 형태로 체계적인 작업을 진행할 수 있도록 도와주기 때문입니다.
'Script to Video'는 3단계로 진행됩니다. 1단계에서는 자유 형식의 텍스트로 스크립트를 추가하거나 시나리오(대본)를 추가합니다. Atlabs가 시나리오 형식을 감지하면 'Screenplay Detected(시나리오 감지됨)' 알림을 표시하고 전용 섹션으로 전환됩니다. 이 섹션의 왼쪽 패널에는 AI가 분석한 내레이터 음성, 위치, 배우가 표시되고, 오른쪽 패널에는 위치 유형, 위치, 시간대별로 씬이 세부적으로 분할되어 나타납니다. 각 씬 내부에서는 개별 SHOT(샷) 설명과 DIALOGUE(대사) 블록을 볼 수 있으며, 각각 캐릭터 이름, 대사 내용, 대사 톤을 설정할 수 있습니다. 이 샷 리스트는 시간대별 비트를 인터페이스 형태로 구현한 것이며, 캐스팅 패널은 레퍼런스 태깅을 시각화한 것입니다.
음악 중심의 영상 작업의 경우, 'Music Video' 워크플로우에서 동일한 논리가 적용됩니다. 여기서는 'Creative Direction' 단계를 통해 트랙에서 감지된 템포, 분위기, 장르를 기반으로 6개의 씬 콘셉트를 자동으로 생성해 줍니다.
단계별 튜토리얼
1. 툴을 다루기 전에 먼저 비트를 서술해 보세요. 종이에 먼저 3~4개의 시간 블록으로 씬을 대략적으로 구상합니다. 블록당 하나의 행동과 하나의 카메라 움직임을 지정합니다. 만약 한 블록에 서로 관련 없는 두 가지 이벤트가 포함되어 있다면 분할하세요. 많은 이들이 이 단계를 건너뛰지만, 이 단계가 결과물의 사용 가능 여부를 결정짓는 핵심입니다.
2. 'Script to Video'를 열고 입력 모드를 선택합니다. 내레이션 중심의 콘텐츠라면 "Add your script"를 사용하고, 이미 구체적인 샷과 대사가 정해져 있다면 "Add your screenplay"를 선택합니다. 시나리오 형식을 갖춘 텍스트를 붙여넣으면 Atlabs가 'Screenplay Detected'를 활성화하고 구조화된 뷰로 전환합니다. 빈 칸에서부터 시작하는 대신 편집할 수 있는 기초 뼈대를 원한다면 'AI Script Writer' 버튼이나 3개의 생성된 시작점을 제안하는 'Suggested Scripts' 패널을 활용할 수도 있습니다.
3. 씬 구성을 세부적으로 설계합니다. 시나리오 모드에서 위치 유형(Location Type)을 실외(Exterior) 또는 실내(Interior)로 설정한 뒤, 위치(Location)와 시간대(Time of Day)를 지정합니다. 발생 순서에 맞춰 샷(SHOT) 설명을 비트당 하나씩 추가하고, 인물이 말하는 시점에 대사(DIALOGUE) 블록을 추가하여 캐릭터 이름, 대사, 전달 톤을 입력합니다. 각 씬마다 샷과 대사를 자유롭게 추가하거나 삭제할 수 있으므로, 문단을 통째로 다시 쓰고 막막하게 다시 생성하는 대신 이 단계에서 템포를 미세 조정할 수 있습니다.
4. 스타일을 설정합니다. 2단계에서는 화면 비율을 TikTok 및 Instagram용 9:16, YouTube용 16:9, 혹은 LinkedIn, Twitter, Facebook, Pinterest용 1:1 중에서 선택할 수 있습니다. 비디오 스타일(Video Style)로는 AI Video (추천), AI Storyboard, 그리고 본인의 미디어를 직접 가져오는 Upload 옵션을 제공합니다. 구도를 최종 결정하기 전에 비율을 먼저 선택하세요. 16:9에서 멋지게 연출된 푸시인 구도가 9:16 비율에서는 다르게 크롭될 수 있기 때문입니다.
5. 출연진을 최종 확정합니다. 3단계에는 스크립트에서 추출된 캐릭터 목록이 나타나며, 각각 'Click to Edit(클릭하여 편집)' 기능과 'Add Character(캐릭터 추가)' 옵션, 국가별 액센트 및 내레이터 음성 선택 드롭다운이 제공됩니다. 여기서 캐릭터를 정의하는 것은 레퍼런스 스택의 맨 위에 인물 이미지 레퍼런스를 두는 것과 같은 효과를 냅니다. 매 샷마다 모델이 새로운 인물을 추측하는 대신, 이 인물이 누구인지 고정된 기준 값을 제공해 줍니다.
6. Seedance 2.5로 생성한 뒤, 처음부터 다시 하기보다는 편집을 거치세요. 특정 구간이 마음에 들지 않는다면 해당 클립을 'Modify Video'로 가져가 업로드한 뒤, 프롬프트에서 이를 @Video1로 참조하고, 원하는 최종 비디오 상태를 설명합니다. 그리고 스타일 가이드를 위해 최대 4개의 참조 이미지를 첨부합니다. 'Keep Original Audio(원본 오디오 유지)' 온/오프 토글 기능이 있으므로 화면을 수정하더라도 마음에 드는 사운드트랙을 그대로 유지할 수 있습니다.
Atlabs에서 Script to Video 열기
이 방식이 Atlabs에서 특히 유용한 이유
첫째는 모델 라우팅입니다. 프롬프트 작성의 기본 원칙은 어디서나 통용되지만 시각적 감성은 제각각입니다. 스타일리시한 캐릭터 클로즈업을 잘 렌더링하는 모델이 광활한 해안가 배경을 잘 표현하는 모델과 일치하는 경우는 드뭅니다. Atlabs는 길고 연속적인 테이크와 레퍼런스 비중이 높은 씬에는 Seedance 2.5를, 스타일리시한 콘텐츠나 애니메이션 및 캐릭터 클로즈업에는 Seedance 2.0을, 시네마틱한 움직임과 부드러운 모션에는 Kling 3.0 및 Kling 2.6을, 극사실주의 및 전경(Establishing) 샷에는 Google Veo 3.1을, 역동적인 모션과 애니메이션 풍 비주얼에는 Hailuo 2.3을, 오픈 소스 기반의 시네마틱 결과물에는 Wan 2.6을 실행합니다. 하나의 워크플로우 안에서 다양한 모델을 배후에서 구동할 수 있어 별도의 API 계정들을 번거롭게 관리할 필요가 없습니다.
둘째로, 사용자가 일일이 기억하지 않더라도 인터페이스 자체에서 구조적 작성을 강제해 줍니다. 씬별로 샷과 대사 블록이 명확히 나누어진 샷 리스트 구조 덕분에, 장편 프롬프팅에서 가장 흔히 발생하는 실수인 '하나의 긴 줄글로 합쳐져 버리는 현상'을 방지해 줍니다.
셋째로, 움직임과 캐릭터 정체성을 분리할 수 있습니다. 'Motion Control(모션 제어)' 기능은 3초에서 30초 사이의 레퍼런스 비디오를 가져와 업로드한 캐릭터 이미지에 해당 모션을 입힙니다. 이때 프롬프트의 불확실성에 의존하지 않고 레퍼런스의 움직임을 온전히 따르며, 배경 및 씬 세부 묘사를 위한 옵션 프롬프트 필드도 지원합니다. 이는 비디오 레퍼런스를 오직 카메라 모션용으로만 사용하겠다고 선언하는 것과 같지만, 툴을 통해 이를 완벽하게 보장해 줍니다. 'Lip Sync(립싱크)' 기능도 연기 연출을 위해 동일한 방식으로 작동하며, 캐릭터 이미지나 비디오와 함께 2초에서 120초 사이의 오디오 파일을 사용합니다.
프롬프트 예시
1. 정교한 타이밍의 원테이크. 차콜 쓰리피스 수트를 입은 남성이 밤에 호텔 로비를 따라 걸어간다. 대리석 바닥, 황동 장식, 분위기 있는 황색 텅스텐 조명. 0s~8s: 남성이 바닥을 가로지를 때 뒤에서 따라가는 스테디캠 팔로우 샷, 스태프들이 고개를 돌려 그가 지나가는 모습을 바라본다. 8s~18s: 남성이 황동 문을 밀고 거리로 나서자 윕팬으로 전환되며 카메라 플래시를 터뜨리는 사진기자 무리가 나타난다. 18s~30s: 남성의 얼굴을 향해 느리게 푸시인하며 살짝 미소를 짓고, 초점이 뒤편의 대형 전광판(marquee)으로 이동(랙포커스)한다. 사운드는 군중의 웅성거림, 카메라 셔터 소리, 먼 곳의 교통 소음으로 구성하며 음악은 배제한다. (Seedance 2.5 라우팅 권장) Atlabs Script to Video에서 이 프롬프트 사용해보기
2. 자연스러운 다큐멘터리 스타일의 몽타주. 늦은 밤 무인 코인빨래방의 멀티 샷 관찰 푸티지, 총 7개의 샷, 완벽하지 않은 핸드헬드 구도, 단일 연속 테이크 없음. 오버사이즈 면 티셔츠를 입은 여성이 세탁기에 빨래를 넣고, 전화를 받고, 윙윙거리는 형광등 아래에 홀로 앉아 있다. 문가에서 바라본 와이드 샷, 이어서 세탁조 너머로 바라보는 숄더 샷, 그리고 창문 앞의 타이트한 프로필 샷. 사운드는 기계 소리, 야외 교통 소음 등 현장 오디오(동시녹음)로만 구성하며 배경음악은 넣지 않는다. (Seedance 2.5 라우팅 권장) Atlabs Script to Video에서 이 프롬프트 사용해보기
3. 비트 싱크 퍼포먼스. 빨간색 새틴 재킷을 입은 가수가 블루 아워의 비에 젖은 루프탑에서 노래를 부른다. 뒤편에는 네온사인 사인이 있고 도시의 안개가 빛을 머금고 있다. 카메라는 벌스(도입부) 구간에서는 천천히 회전하고, 사비(후렴구) 구간에서는 비트에 정확히 맞춰 더 과감하게 컷을 전환한다. 얕은 심도, 따뜻한 피부 톤과 대비되는 차가운 하이라이트, 시네마틱한 색보정. (Kling 3.0 라우팅 권장) Atlabs Music Video에서 이 프롬프트 사용해보기
4. 캐릭터 일관성 고정 샷. 목수가 톱밥 가루가 날리는 목공소 작업실을 걸어가다 완성된 호두나무 의자 옆에 멈춰 선다. 카메라는 뒤에서 따라가다가 측면 뷰로 이동하여, 팔걸이 위에 얹은 목수의 손을 타이트한 클로즈업 샷으로 잡으며 끝난다. 얼굴, 의상, 제품 형태 및 방의 구조를 정확하게 그대로 유지한다. 추가 인물 없음, 자막 없음, 추가 음악 없음, 카메라 컷 전환 없음. (Seedance 2.5 라우팅 권장) Atlabs Modify Video에서 이 프롬프트 사용해보기
5. 물리 법칙 테스트. 작업대 위 도미노, 황동 기어, 작은 나무 경사로로 구성된 연쇄 반응 트랙을 따라 유리 구슬이 빠르게 굴러간다. 끊김 없는 하나의 부드러운 샷, 매크로 아웃포커싱(얕은 심도), 모서리 실루엣을 강조하는 강한 측면 조명. 구슬은 전체 과정에서 실제 중력과 운동량을 정확히 따른다. 또렷한 마찰음, 구르는 유리 소리, 음악 없음, 컷 전환 없음. Atlabs Script to Video에서 이 프롬프트 사용해보기
6. 모션 트랜스퍼 (동작 전송). 느슨한 린넨 셔츠를 입은 무용수가 빈 콘크리트 갤러리에서 춤을 추고 있다. 높은 창문으로 들어오는 오후의 햇빛이 바닥에 선명한 직사각형 모양을 만들어내고, 빛줄기 속으로 먼지가 보인다. 동작은 전적으로 레퍼런스 클립에서 가져오며, 배경과 조명은 프롬프트를 따릅니다. 와이드 고정 프레임, 카메라 움직임 없음, 자연스러운 실내 리버브 음향. (Hailuo 2.3 라우팅 권장) Atlabs Motion Control에서 이 프롬프트 사용해보기
Atlabs에서 이 프롬프트들 실행해보기
전문가 팁
인물 사진 레퍼런스를 맨 앞에 배치하세요. 레퍼런스의 나열 순서는 가중치에 큰 영향을 미치며, 모델은 처음에 입력된 소스를 더 지배적인 기준으로 처리합니다. 인물 정체성(얼굴) 정보를 1번에 두고, 그 다음 의상, 배경, 마지막에 스타일 색감 순으로 배치하세요. 캐릭터의 얼굴이 자꾸 바뀐다면 프롬프트를 다시 쓰기 전에 순서부터 확인해 보시기 바랍니다.
각 레퍼런스의 제외 항목(무엇이 아닌지)을 명시하세요. "비디오 1은 카메라 움직임과 속도 제어 전용입니다"라고 명시하면 모델이 해당 비디오 클립의 조명이나 의상까지 엉뚱하게 복제해 오는 현상을 방지할 수 있습니다. 지시 사항만큼이나 배제 사항도 중요하므로, 레퍼런스 비중이 높은 프롬프트 끝에는 "자막 없음, 추가 음악 없음, 추가 인물 없음" 같은 문구를 기재하는 것이 좋습니다.
사운드를 직접 설명하지 않으면 무작위로 생성됩니다. 오디오 역시 영상과 동시에 생성되므로, 프롬프트에서 사운드를 비워두는 것은 조용하게 해달라는 요청이 아니라 모델에게 무작위 생성을 허용하는 것과 같습니다. 주변 앰비언스를 묘사하고, 대사가 있다면 어떤 언어인지 지정하세요. 만약 배경에 아무 소리도 얹고 싶지 않다면 명시적으로 "현장 수음 오디오(production sound only)"라고 명확히 작성해야 합니다.
자주 묻는 질문 (FAQ)
Atlabs에서 Seedance 2.5를 사용할 수 있나요? 네, 가능합니다. 다른 모델 라인업과 동일한 워크플로우 내에서 구동되므로, 'Script to Video' 또는 'Music Video'에서 씬을 구성한 다음 별도의 외부 계정을 만들 필요 없이 제너레이션 단계에서 Seedance 2.5를 선택하기만 하면 됩니다.
Seedance 2.5 클립의 길이는 최대 어느 정도인가요? 단일 패스 내에서 자체적으로 연속 생성할 수 있는 길이는 약 30초입니다. 더 이상 짧은 클립들을 조각조각 이어 붙일 필요가 없다는 점이 이전 버전과 비교해 가장 실질적이고 차별화된 장점입니다.
레퍼런스는 최대 몇 개까지 사용할 수 있나요? 이미지, 비디오, 오디오를 통틀어 최대 50개까지 가능합니다. 통상적으로 플랫폼 유형에 따라 이미지 약 30장, 비디오 클립 10개, 오디오 파일 10개 정도로 나누어 활용합니다. 먼저 배치한 소스가 더 높은 우선순위를 가지므로 중요도 순으로 정렬해 구성하세요.
긴 프롬프트의 품질을 가장 빠르게 개선할 수 있는 단 하나의 방법은 무엇인가요? 타임스탬프를 추가하는 것입니다. 30초짜리 요약본을 3~4개의 구체적인 시간대별 블록으로 나누어 주는 작업만으로도, 어떤 다른 수정 방식보다 흐름 및 흐트러짐 문제를 1분 만에 효과적으로 해결할 수 있습니다.
Seedance 2.5와 Seedance 2.0 중 어느 것을 써야 하나요? 생성하려는 클립의 길이가 길거나, 여러 레퍼런스의 형태를 일관되게 고정해야 하거나, 전체 씬이 하나의 연속된 흐름으로 정교하게 짜여야 할 때는 2.5를 선택하세요. 반면 30초 미만의 비교적 짧은 스타일라이즈드 작업, 애니메이션, 일관성이 덜 요구되는 캐릭터 클로즈업 등 빠른 결과물을 원할 때는 2.0을 사용하시면 됩니다.
영상 전체를 다시 생성하지 않고 일부분만 수정할 수 있나요? 네, 가능합니다. 'Modify Video' 기능은 3초에서 10초 사이의 기존 비디오 클립을 프롬프트에서 @Video1로 참조한 뒤, 원하는 최종 비디오 묘사와 최대 4장의 스타일 레퍼런스 이미지를 함께 입력해 특정 구간을 수정할 수 있습니다. 'Keep Original Audio' 기능을 켜두면 화면만 교정하면서 기존 오디오는 온전히 지킬 수 있습니다.
최종 결론
장편 비디오 프롬프팅은 화려한 묘사보다 정밀한 기획 단계에서 성패가 갈립니다. 문장을 작성하기 전에 타임라인 비트를 먼저 설계하고, 각 레퍼런스가 제어할 대상을 명확히 정의하며, 카메라 구도를 고민하듯 사운드 또한 세심하게 명명하세요. 이 세 가지 습관은 앞으로 접하게 될 모든 비디오 생성 모델에서 그대로 적용되므로, 새로운 모델이 출시될 때마다 매번 새로 배우기보다는 지금부터 체득해 두는 것이 훨씬 유용합니다.
다만, 프롬프트 외적인 부분들(샷 리스트 구성, 캐스팅 배치, 화면 비율 조정, 모델 분류 선택, 에러 수정 프로세스 등)은 개인이 매번 일일이 관리하기에 다소 까다로울 수 있습니다. 이를 체계적으로 지원하기 위해 통합 워크플로우가 존재합니다. Atlabs에서 'Script to Video'는 씬의 구조를 완벽하게 잡아주고, 'Music Video'는 템포 기반의 가이드를 제공하며, 'Modify Video' 및 'Motion Control'은 결과물을 매끄럽게 교정하도록 도우며 그 중심에서 Seedance 2.5가 최상의 퍼포먼스를 보장합니다.