TL;DR
무작위 AI 비디오 생성에 크레딧을 낭비하지 마세요. 다음 6가지 디렉터 수준의 기술을 마스터하세요:
제어력과 비용 효율성을 위한 텍스트 투 비디오보다 이미지 투 비디오
긴 문장 대신 짧은 프롬프트 공식 (주체 + 행동 + 위치)
세계관 일관성을 위한 앵커 키워드 & 캐릭터 시트
사양을 입력하는 대신 시네마틱 프리셋 (카메라 슬라이더 및 모션 컨트롤) 사용
IP를 모방하는 것이 아닌 장르 해체를 통한 시그니처 룩 개발
의도적인 앵글과 움직임을 통한 시네마틱 스토리텔링
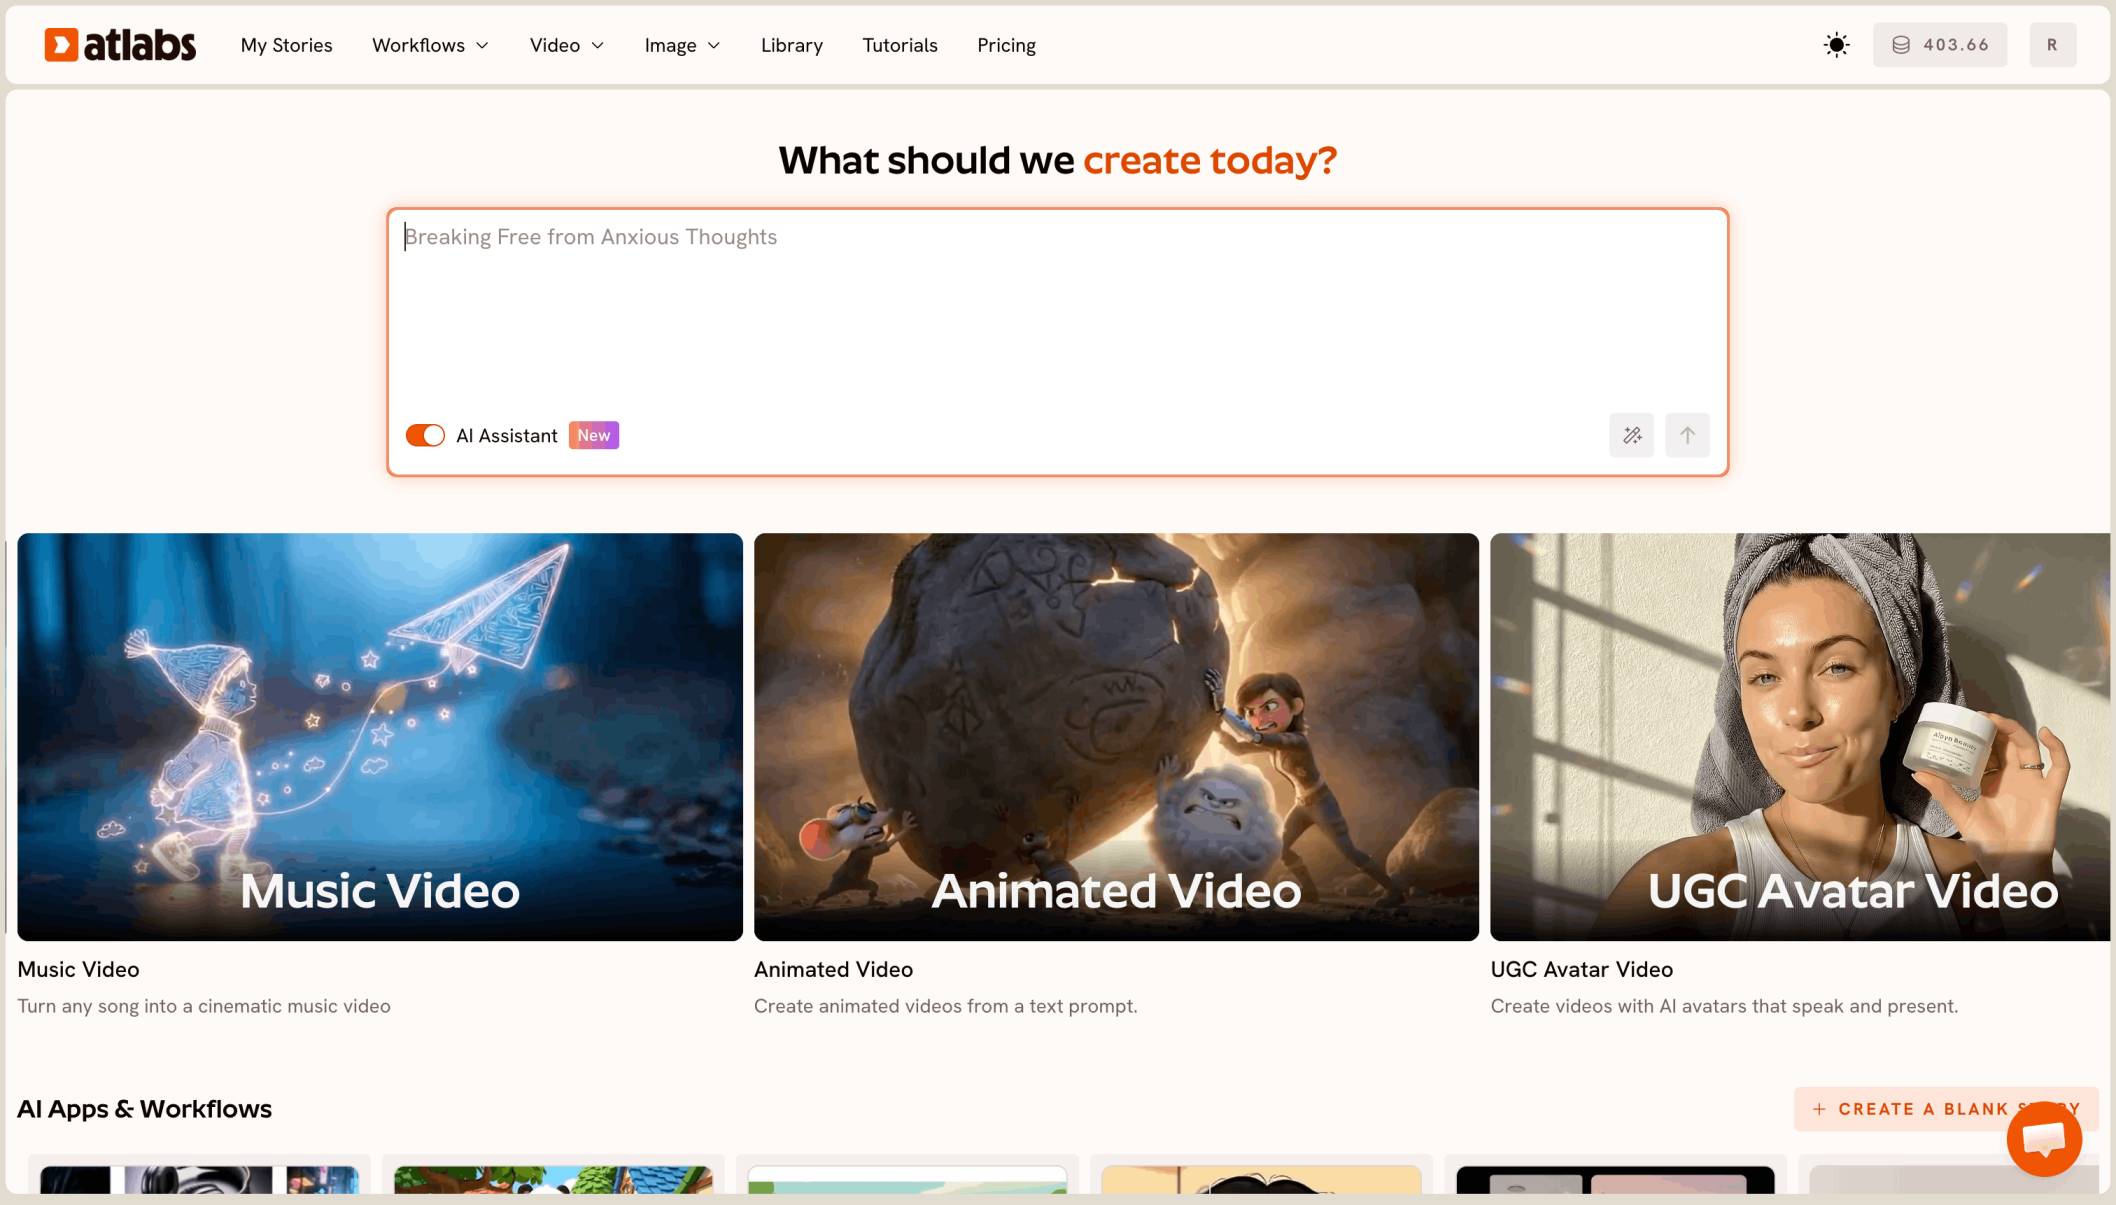
Atlabs AI에서 만들기 시작하기
문제점: "슬롯머신" 효과
저는 3년 동안 매일 AI 이미지와 비디오를 만들어 왔습니다. 냉정한 현실은 다음과 같습니다:
최고의 AI 비디오는 복잡하고 긴 문장으로 구성된 프롬프트로 만들어지지 않습니다.
무작위 생성에 의존한다면, 당신은 본질적으로 슬롯머신 레버를 당기며 행운의 결과가 나오기를 바라며 크레딧, 시간, 비용을 낭비하고 있는 것입니다. 그 결과물은 종종 파편화된 느낌을 줍니다:
클립 간에 캐릭터의 얼굴이 바뀜
조명이 일치하지 않음
스타일이 무작위로 변함
움직임이 부자연스러움
크레딧 낭비 중단 – Atlabs AI에서 만들기 시작하기
해결책: 디렉터의 워크플로우
해결책은 "프롬프터" 마인드에서 "디렉터" 마인드로 전환하는 것입니다. 간단하고 의도적인 기법을 사용하여 출력물을 제어할 수 있습니다.
Atlabs AI를 사용하면 시행착오를 신뢰할 수 있는 반복 가능한 워크플로우로 전환할 수 있습니다.
다음은 2026년에 시네마틱 AI 비디오 생성을 마스터하기 위해 필요한 6가지 핵심 기술입니다.
기술 #1: 올바른 AI 비디오 접근 방식 선택하기
첫 번째 단계는 모든 생성 방법이 동일하지 않다는 것을 이해하는 것입니다. Atlabs AI 내에서 비디오를 만드는 두 가지 고유한 방법이 있습니다.
방법 1: 텍스트 투 비디오 (속도)
이 방법은 나중에 로고와 브랜딩을 추가할 계획인 10초짜리 클립과 같은 빠른 소셜 비디오에 적합합니다.
워크플로우:
Atlabs AI Text to Video 내부에서 Kling 2.6 비디오 모델을 선택합니다.
"텍스트 투 비디오" 옵션을 사용합니다.
간단한 시네마틱 프로모션 프롬프트를 입력합니다.
재생 시간(예: 10초)을 선택합니다.
생성을 누릅니다.
결과: 사용할 수 있는 클립이 빠르게 생성됩니다.
단점: 특정 세부 사항에 대한 제어력이 떨어지므로 원하는 샷을 얻기 위해 여러 번 생성을 실행하고 더 많은 비용을 지출해야 할 수 있습니다.
방법 2: 이미지 투 비디오 (제어) ✓ 권장
일관성이 중요할 때, 이는 타협할 수 없는 전문적인 표준입니다. 작업을 두 단계로 나눕니다:
단계 1: 이미지 생성
Nano Banana Pro 와 같은 모델을 사용하여 먼저 시각적 구도를 완벽하게 만듭니다.
단계 2: 이미지 애니메이션화
해당 이미지를 비디오 생성의 입력값으로 사용합니다.
이 방법이 효과적인 이유:
이미지는 비디오보다 생성 비용이 훨씬 저렴합니다.
비디오 크레딧을 쓰기 전에 완벽할 때까지 조명, 캐릭터, 스타일을 조정할 수 있습니다.
이를 Atlabs 내의 Kling 2.6에 입력하면 움직임만 프롬프트로 지정하면 됩니다(예: "카메라가 여성의 얼굴로 줌인되고... 그녀는 편안하게 자세를 풉니다").
이를 통해 캐릭터의 얼굴이 변형되지 않고 스타일이 일관되게 유지됩니다.
프로 팁: 이미지는 비디오보다 비용이 10배 적게 듭니다. 먼저 프레임을 완벽하게 만든 다음 한 번만 애니메이션을 적용하세요.
Atlabs AI에서 이미지 투 비디오 사용해 보기
기술 #2: 올바른 이미지 프롬프트 방법 선택하기
완벽한 입력 이미지를 얻으려면 올바른 프롬프트 전략이 필요합니다.
방법 1: LLM 지원 (권장하지 않음)
ChatGPT나 Gemini를 사용하여 프롬프트를 작성하면 편집하기 번거롭고 길고 비대해진 프롬프트를 얻게 됩니다. LLM은 종종 불필요한 수식어로 가득 찬 300단어 이상의 프롬프트를 출력합니다.
문제점: 긴 프롬프트는 일관성이 없고 반복 수정하기 어렵습니다.
방법 2: 짧은 프롬프트 구조 ✓ 권장
더 빠른 워크플로우와 더 많은 제어를 위해 네 가지 간단한 구성 요소로 이루어진 모듈식 구조를 사용하세요.
공식:
예시:
주체(Subject): A Jedi woman
구도(Composition): Full body shot
행동(Action): In a focused stance holding an ignited cyan lightsaber
위치(Location): In a rocky vast desert
스타일(Style): Lit by low angle golden sunlight with long cinematic shadows and dust glowing in the air
최종 프롬프트:
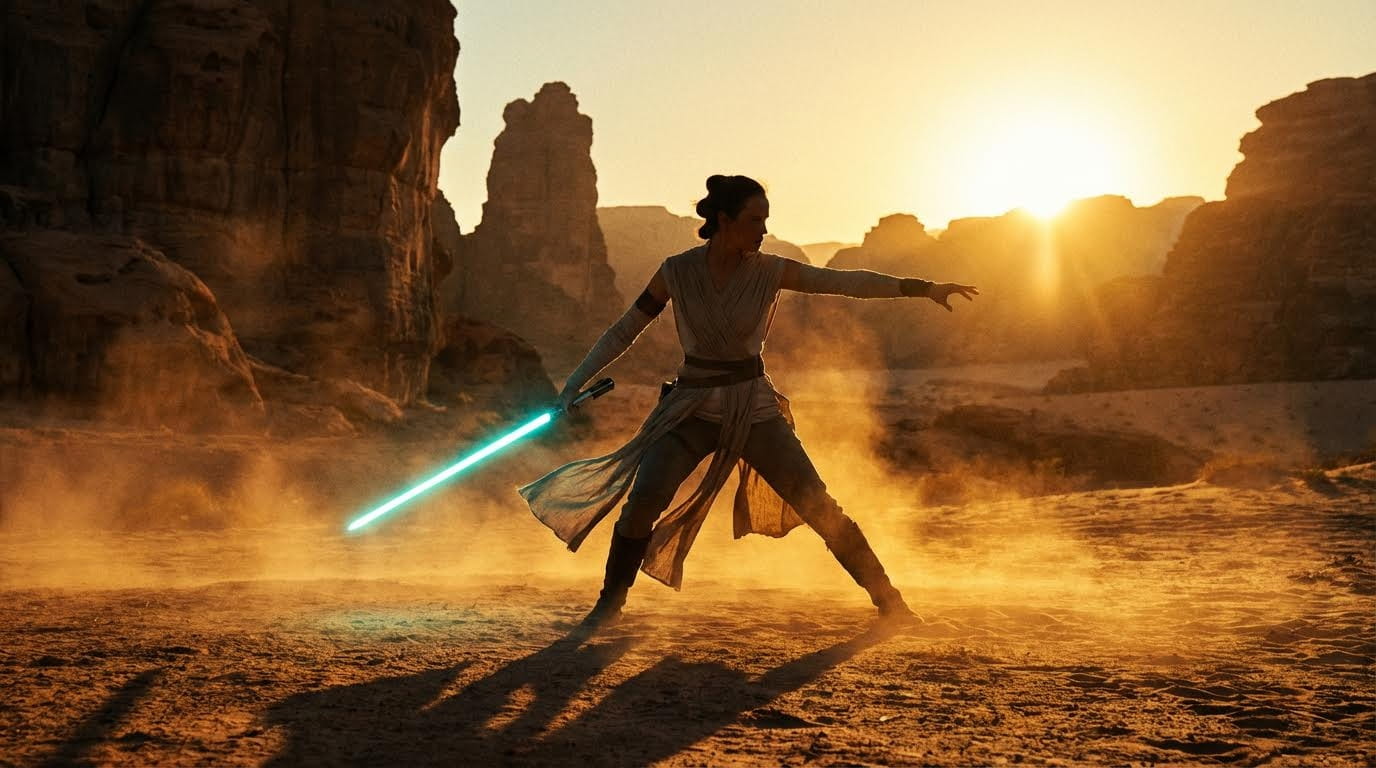
깔끔함. 명확함. 편집하기 쉬움.
이를 통해 쓸데없는 토큰 낭비 없이 이미지의 모든 요소를 세밀하게 제어할 수 있습니다.
Atlabs에서 첫 번째 시네마틱 이미지 생성하기
기술 #3: 캐릭터 및 세계관 일관성
모든 장면에서 주인공의 모습이 다르게 보인다면 영화라고 할 수 없습니다. Atlabs AI 내에서 일관된 세계관을 구축해야 합니다.
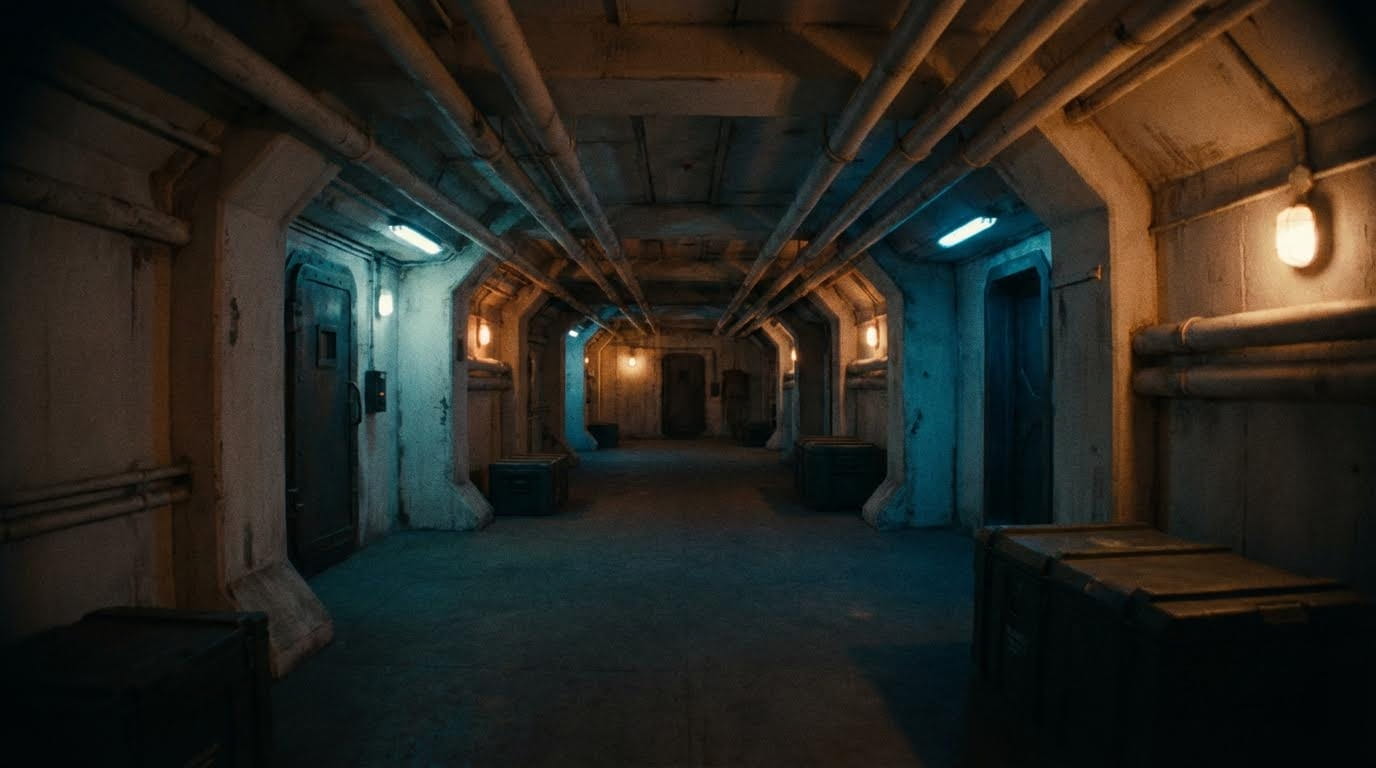
기둥 1: 배경 & 앵커 키워드
레퍼런스 이미지를 단순히 업로드하지 마세요. 밤 장면에 원치 않는 데이터(예: 노을빛 느낌)가 복사될 수 있습니다.
대신, 특정 시퀀스의 모든 프롬프트에 고정하여 사용할 '앵커 키워드'를 사용하세요.
앵커 시스템 예시:
스타일 앵커: "Military Sci-Fi aesthetic"
위치 앵커: "White underground tunnel complex"
분위기 앵커: "Gloomy cinematic atmosphere"
조명 앵커: "Bi-color global illumination, dark orange and cerulean"
프롬프트 전체에서 이러한 키워드를 동일하게 유지함으로써, 세계관은 안정적으로 유지하면서 행동만 변경할 수 있습니다.
고급 앵커:
카메라 및 렌즈: "Shot on Arri Alexa 65, 35mm wide-angle lens"
필름 스톡: "Fuji Superia 100 film, natural grain"
부정적 키워드(Negative Keywords): -- people, vehicles, text, watermark, camera info and date stamp.
프롬프트:
기둥 2: 캐릭터 일관성
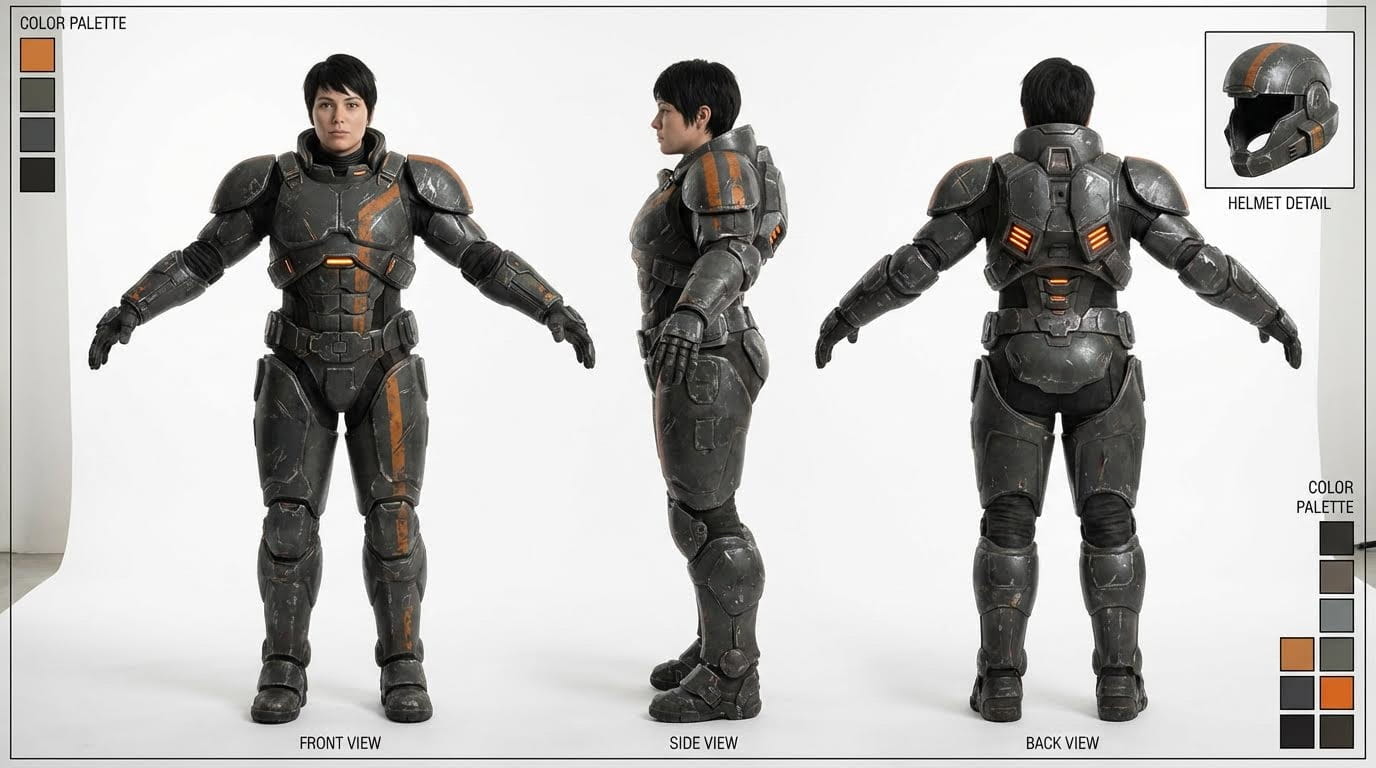
배우의 일관성을 유지하는 방법:
캐릭터 시트 만들기 (중립적인 배경에 캐릭터의 깔끔한 전신 샷)
이를 이미지 레퍼런스로 Atlabs AI에 업로드
텍스트 프롬프트에서 이 레퍼런스를 앵커 키워드와 결합
이를 통해 명확하고 일관된 시네마틱 스토리를 유지하면서 특정 배우를 어떤 위치에든 배치할 수 있습니다.
캐릭터 시트 프롬프트:
Atlabs AI에서 캐릭터 시트 생성하기
기술 #4: 시네마틱 일관성 프리셋 사용하기
프롬프트에서 시네마틱 카메라 프리셋을 활용하세요. 이것이 헐리우드 느낌을 내는 지름길입니다.
비주얼 프리셋
Atlabs 인터페이스 내에서 과도한 프롬프트 입력을 피하세요. 대신 프롬프트에 다음 사항을 고정하세요:
카메라: Sony Venice, Arri Alexa, RED Komodo
렌즈: Arri Signature Prime, Zeiss Supreme
초점 거리: 35mm (광각 샷용) 또는 85mm (인물 샷용)
조리개: f/1.4 (얕은 피사체 심도)
프롬프트에서 이러한 설정을 고정하면 생성하는 모든 이미지가 동일한 광학적 특성을 공유하게 되어 서로 유기적으로 연결된 느낌을 줍니다.
움직임 프리셋
Atlabs의 이미지 투 비디오(Image to Video) 탭으로 이동한 후:
"Models" 버튼을 클릭합니다.
Kling 2.6, Veo3 등과 같은 모델을 선택합니다.
재생 시간을 설정합니다 (예: 5초).
디렉터 모드(Director Mode)를 사용할 수 있습니다. 이를 통해 AI가 기괴한 물리 법칙을 잘못 구현하는 일 없이, 카메라가 구상한 대로 부드럽고 전문적으로 정확하게 움직이도록 보장합니다.
Atlabs AI에서 시네마틱 프리셋 사용하기
기술 #5: 고유한 시그니처 룩 만들기
유명 IP(예: 스타워즈)의 비주얼 스타일을 그대로 모방하는 것은 위험합니다. 이는 개성 없는 결과물을 만들고 저작권 문제를 초래할 수 있습니다.
2026년에 돋보이려면 독창적인 시그니처 룩이 필요합니다.
해체 기법
"Stormtrooper"라고 직접 프롬프트를 입력하지 마세요. 스톰트루퍼의 개념을 해체한 다음 다시 재구축하세요.
단계 1: 시각적 토대
AI(예: Gemini)에게 질문합니다: "스타워즈의 핵심 토대는 무엇인가?"
답변: Space Opera (스페이스 오페라)
단계 2: 네이밍
저작권으로부터 안전한 대체 이름을 요청합니다.
결과: "Stormtrooper" 대신 "Void-Guard"
단계 3: 시각적 묘사
저작권이 있는 이름을 사용하지 않고 의상에 대한 묘사를 요청합니다.
결과: "Glossy white composite armor, integrated respirator module" (광택이 나는 흰색 복합 아머, 통합 호흡기 모듈)
최종 프롬프트:
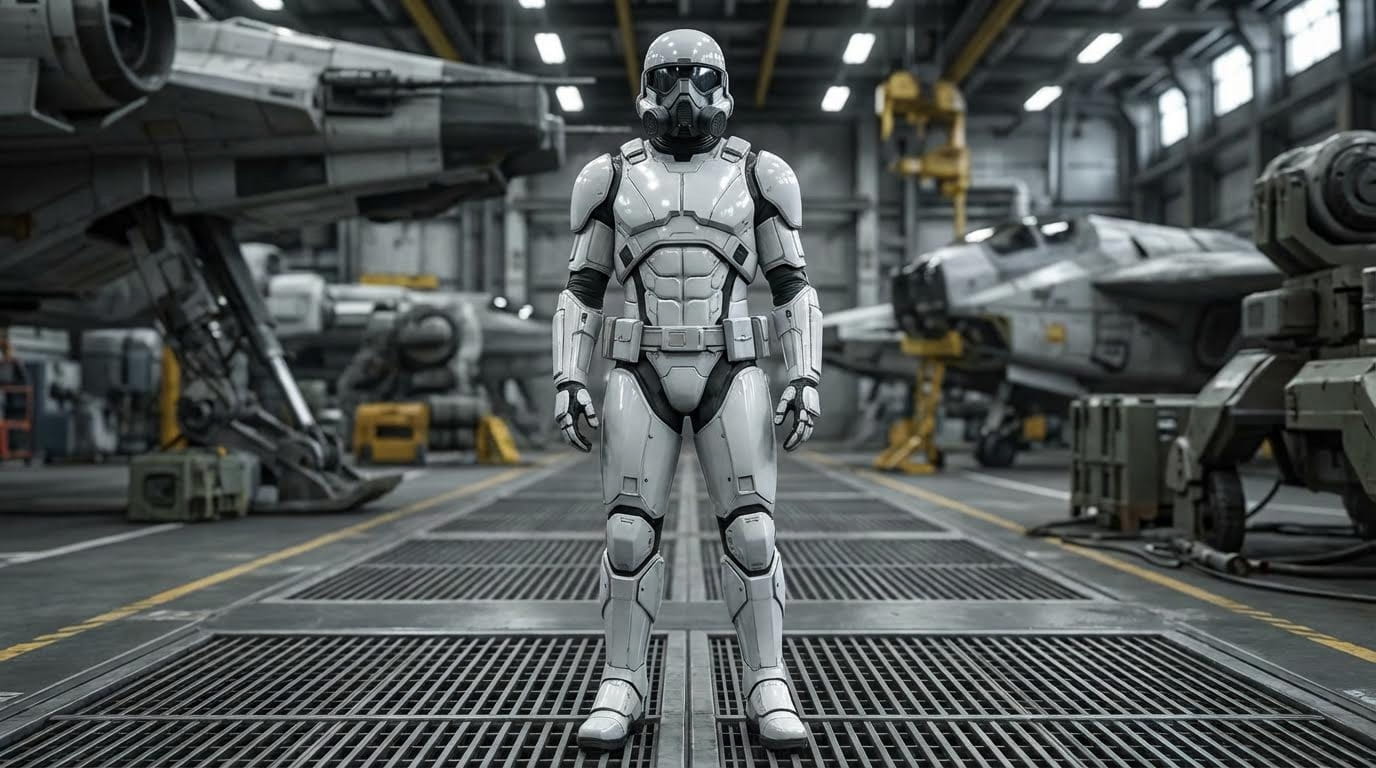
이 해체된 묘사를 Atlabs AI에 입력하면 장르의 본질을 담아내면서도 귀하의 브랜드에 100% 독창적인 캐릭터를 얻을 수 있습니다.
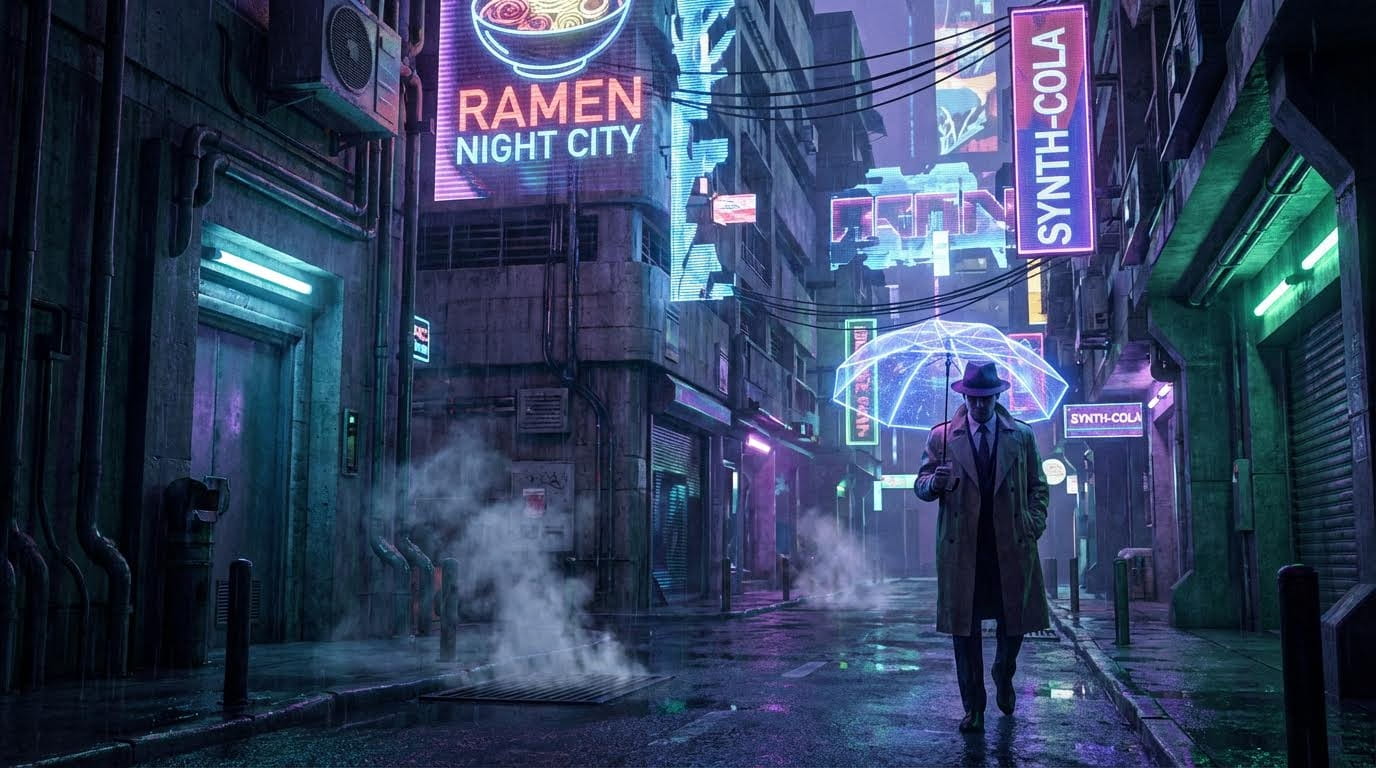
기타 해체 예시
블레이드 러너 → 사이버펑크 네오 누아르:
마블 히어로 → 도시 자경단:
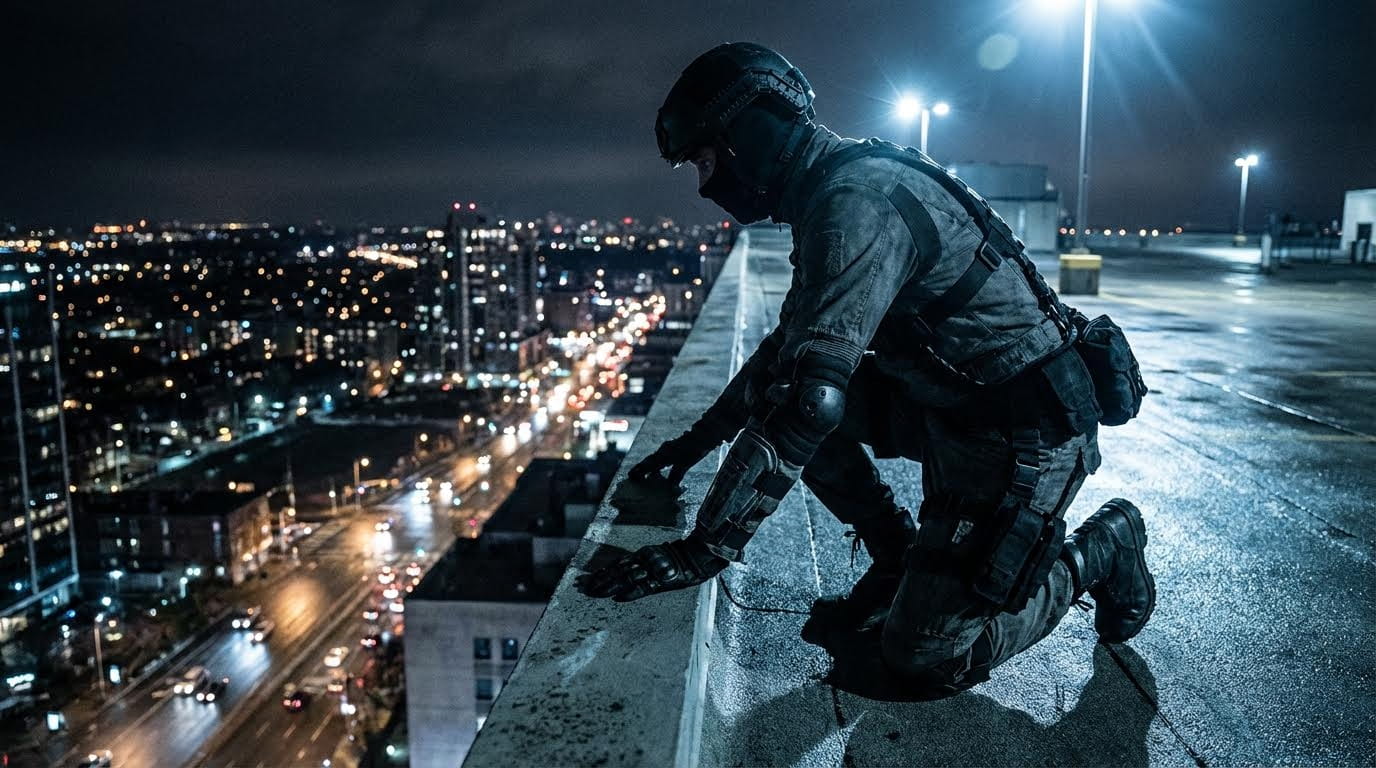
이 방법이 효과적인 이유:
✓ 법적 안전성 (직접적인 IP 모방 없음)
✓ 브랜드 고유성
✓ 장르의 본질 포착
✓ 컷 간의 일관성
Atlabs AI에서 시그니처 룩 구축하기
기술 #6: 시네마틱 스토리텔링
마지막 기술은 기술 데모를 영화로 바꾸는 것입니다. 위치, 카메라 앵글, 움직임을 사용하여 무의식 중에 스토리를 전달해야 합니다.
1. 분위기를 설정하는 로케이션
환경은 대사가 시작되기도 전에 관객에게 무엇이 중요한지 말해줍니다.
분화구 기지: 가치가 높은 타겟, 무언가 중요한 일이 일어나고 있음을 암시
넓은 사막: 노출됨, 취약성과 "숨을 곳 없음"을 암시
우주선 격납고: 거대하지만 그림자로 가득 참, 도사리고 있는 위험을 암시
지하 터널: 갇히고 폐쇄적인 느낌, 제한된 선택지 속에서 고립됨을 암시
2. 앵글 & 움직임 = 감정
Atlabs AI 내부에서 내러티브를 이끌어내기 위해 특정 움직임을 사용하세요:
오프센터(Off-Center) + 팬(Pan)
불안정함을 조성합니다. 빈 공간으로 패닝하면 긴장감이 생겨 관객은 위협 요소를 찾게 됩니다.
클로즈업(Close-Up) + 슬로우 줌(Slow Zoom)
맥락을 제거합니다. 느린 푸시인은 관객이 캐릭터의 내면적 공포나 생각에 몰입하도록 만듭니다.
하이 앵글(High Angle) + 줌 아웃(Zoom Out)
거대한 세계 속에서 캐릭터를 작고 고립되어 보이게 만듭니다.
로우 앵글(Low Angle)
캐릭터가 지배적이고 강력하며 통제력을 쥐고 있는 것처럼 보이게 만듭니다.
트래킹 샷(Tracking Shot)
낮은 구도의 핸드헬드 트래킹 샷은 관객이 장면에 동화되어 주인공과 함께 위험을 헤쳐 나가는 듯한 느낌을 줍니다.
시네마틱 언어 요약 가이드
전달하려는 감정/메시지 | 사용할 카메라 움직임 |
|---|---|
권력, 지배력 | 로우 앵글, 고정 샷 |
취약성, 패배감 | 하이 앵글, 줌 아웃 |
긴장감, 기대감 | 오프센터 팬 |
내면의 감정 | 클로즈업, 슬로우 줌인 |
긴박함, 혼돈 | 핸드헬드 트래킹 |
스케일, 웅장함 | 와이드 샷, 크레인 |
이 언어를 마스터하면 단순히 AI 비디오를 생성하는 것이 아니라 영화를 연출하게 됩니다.
종합: 전체 워크플로우 예시
6가지 기술을 모두 사용하여 3개 컷으로 구성된 시네마틱 시퀀스를 만들어 보겠습니다.
장면: 사막의 유일한 생존자 (고립 → 결의 → 희망)
샷 1: 익스트림 롱 샷/설정 샷 (고립)
앵커 키워드:
Post-apocalyptic desert wasteland, harsh daylight, desaturated color palette, desolate atmosphere
이미지 프롬프트:
이미지 생성 → 비디오로 업로드
모션 프롬프트: "Camera slowly zooms out revealing vast empty desert"
움직임 프리셋: Zoom Out, 6초
전달되는 감정: 고립감, 압도적인 역경
샷 2: 클로즈업 (결의)
이미지 프롬프트:
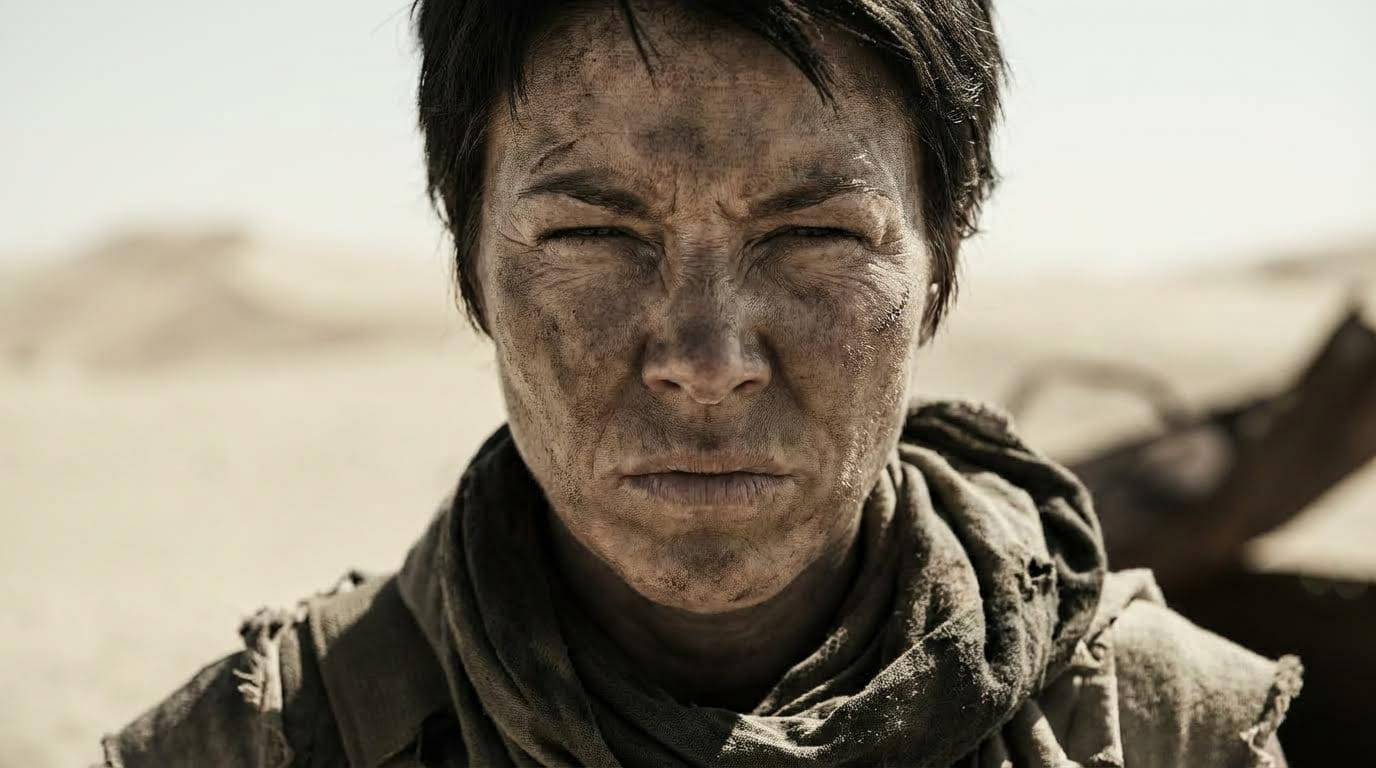
모션 프롬프트: "Slow push in on face, wind blowing hair, eyes narrow with resolve"
움직임 프리셋: Zoom In (Slow), 4초
전달되는 감정: 내면의 강인함, 포기하지 않는 의지
샷 3: 로우 앵글 (희망)
이미지 프롬프트:
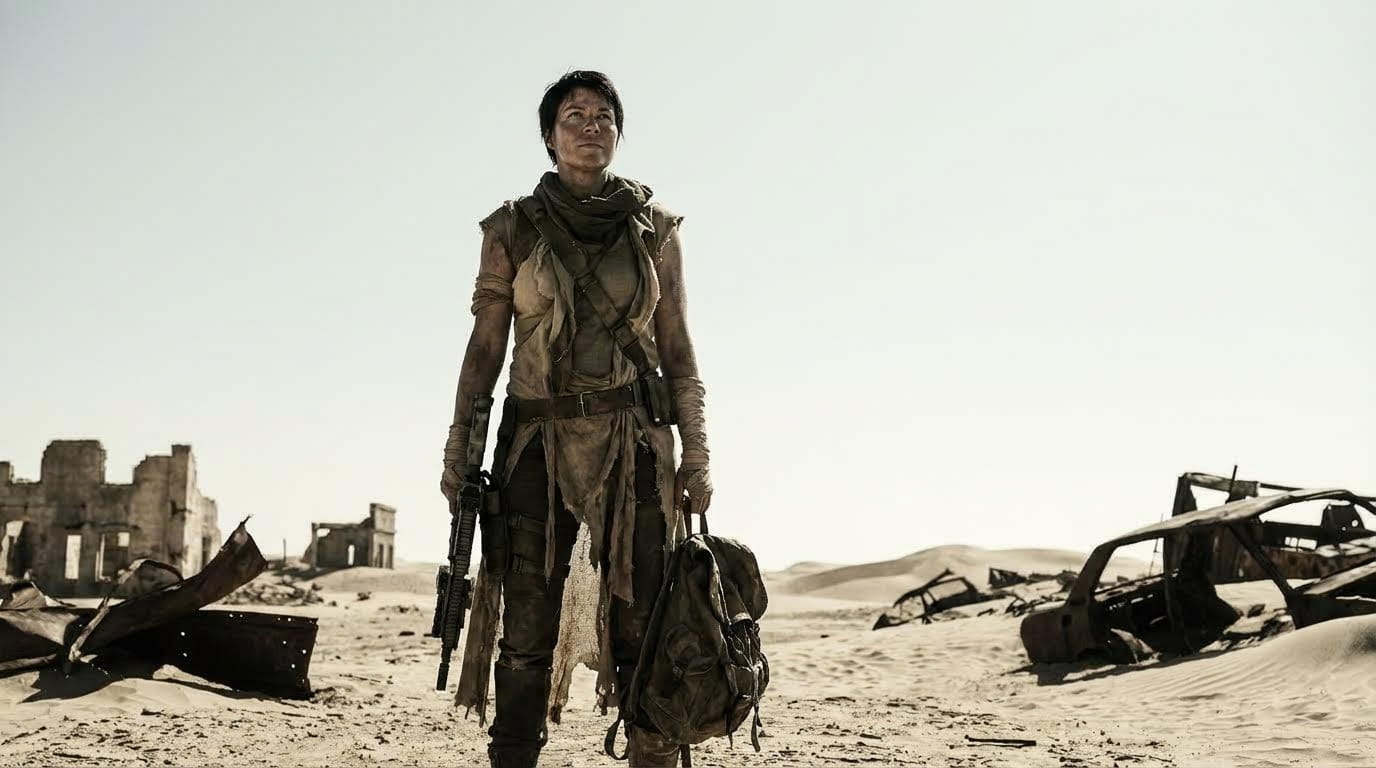
모션 프롬프트: "Camera tilts up from ground to survivor's face as they spot something on horizon"
움직임 프리셋: Tilt Up, 5초
전달되는 감정: 희망, 전환점
결과: 일관된 세계관, 캐릭터, 감정적 흐름을 가진 유기적인 15초 분량의 내러티브 시퀀스 완성.
총 비용: 이미지 생성 3회 + 비디오 생성 3회 = 텍스트 투 비디오 시행착오 비용의 극히 일부
Atlabs AI에서 시네마틱 시퀀스 시작하기
피해야 할 흔한 실수들
❌ 길고 긴 서술형 프롬프트 → ✅ 주체 + 구도 + 행동 + 위치 + 스타일
❌ 모든 작업에 텍스트 투 비디오 사용 → ✅ 일관성을 위한 이미지 투 비디오 사용
❌ 앵커 키워드 부재 → ✅ 스타일, 위치, 조명을 위한 고정 키워드 사용
❌ 무작위 카메라 움직임 → ✅ 의도가 담긴 특정 프리셋 사용
❌ IP 직접 모방 → ✅ 해체 기법을 통한 독창적인 콘셉트 생성
감독이 될 준비가 되셨나요?
더 이상 운과 복잡한 프롬프트에 의존하지 마세요. 오늘 Atlabs AI를 사용하여 이 6가지 기술을 적용하고, 창의적인 비전을 온전히 제어하여 일관되고 영화 같은 결과물을 만들어 보세요.
Atlabs AI에서 시네마틱 AI 비디오 마스터하기 – 무료 체험 시작
빠른 참조 요약본
짧은 프롬프트 공식:
필수 앵커 유형:
스타일: 장르의 미학
위치: 고정된 환경
조명: 색상 및 연출
카메라: 렌즈 및 설정
움직임 = 감정:
권력 → 로우 앵글
취약성 → 하이 앵글 + 줌 아웃
긴장감 → 오프센터 팬
감정 → 클로즈업 + 슬로우 줌
혼돈 → 핸드헬드 트래킹
관련 가이드
태그: 시네마틱 AI 비디오, Atlabs AI 튜토리얼, 이미지 투 비디오, AI 영화 제작 2026, 일관된 AI 캐릭터, 카메라 무브먼트 프리셋, AI 비디오 생성, AI 감독 워크플로우