AI 비디오 생성에서 목소리 일관성 문제
AI 비디오 생성의 가장 큰 과제 중 하나는 목소리의 불일치입니다. 자체 오디오 생성을 지원하는 이미지-비디오(image-to-video) 또는 텍스트-비디오(text-to-video) 모델을 사용할 때, 각 클립은 동일한 캐릭터에 대해서도 서로 다른 목소리를 생성합니다.
한 장면에서 주인공은 자신감 넘치고 강력한 목소리로 말할 수 있지만, 다른 장면에서는 소심하고 하이톤의 목소리로 말할 수 있습니다. 이러한 당혹스러운 불일치는 시청자에게 인공지능이 생성한 콘텐츠를 보고 있음을 인지하게 만들고 즉각적으로 몰입감을 깨뜨립니다.
문제점:
장면 1 생성: 캐릭터가 깊고 성숙한 목소리를 가짐
장면 2 생성: 동일한 캐릭터가 이제 젊고 다른 목소리를 가짐
장면 3 생성: 목소리가 다시 완전히 바뀜
이러한 현상은 AI 모델이 이전 생성에 대한 기억이 없기 때문에 새로운 클립마다 목소리를 무작위로 생성하기 때문에 발생합니다.
지금 바로 일관된 캐릭터 목소리를 만들어보세요!
Atlabs Mirror Voice가 이를 해결하는 방법
Atlabs AI는 목소리 불일치 문제를 특별히 해결하기 위해 Mirror Voice 기능을 도입했습니다. 매 생성마다 무작위 목소리를 얻는 대신, Mirror Voice를 사용하면 특정 목소리를 고정하고 캐릭터의 모든 장면에 걸쳐 일관되게 사용할 수 있습니다.
해결책:
장면 1 생성: 캐릭터가 깊고 성숙한 목소리를 가짐
Mirror Voice → 장면 2: 동일하고 깊고 성숙한 목소리
Mirror Voice → 장면 3: 동일하고 깊고 성숙한 목소리
완벽한 일관성 보장
Mirror Voice 작동 방식
Mirror Voice는 생성된 클립 중 하나에서 정확한 목소리 특징을 캡처하여 동일한 캐릭터의 향후 모든 생성에 동일한 목소리를 적용할 수 있도록 합니다.
3단계 프로세스
1단계: 첫 번째 클립 생성 Atlabs AI의 텍스트-비디오 또는 이미지-비디오 모델을 사용하여 캐릭터의 첫 번째 대사 장면을 만듭니다. AI가 캐릭터의 목소리를 생성합니다.
2단계: 목소리 선택 Atlabs AI의 목소리 라이브러리에서 목소리를 선택합니다. 이 목소리는 이제 이 프로젝트를 위한 Mirror Voice 라이브러리가 됩니다.
3단계: 모든 다른 장면에 미러링 적용 동일한 캐릭터가 등장하는 모든 후속 장면에서 Mirror Voice 기능을 사용하여 동일한 목소리를 선택합니다. Atlabs AI는 정확히 동일한 목소리로 새로운 오디오를 생성합니다.
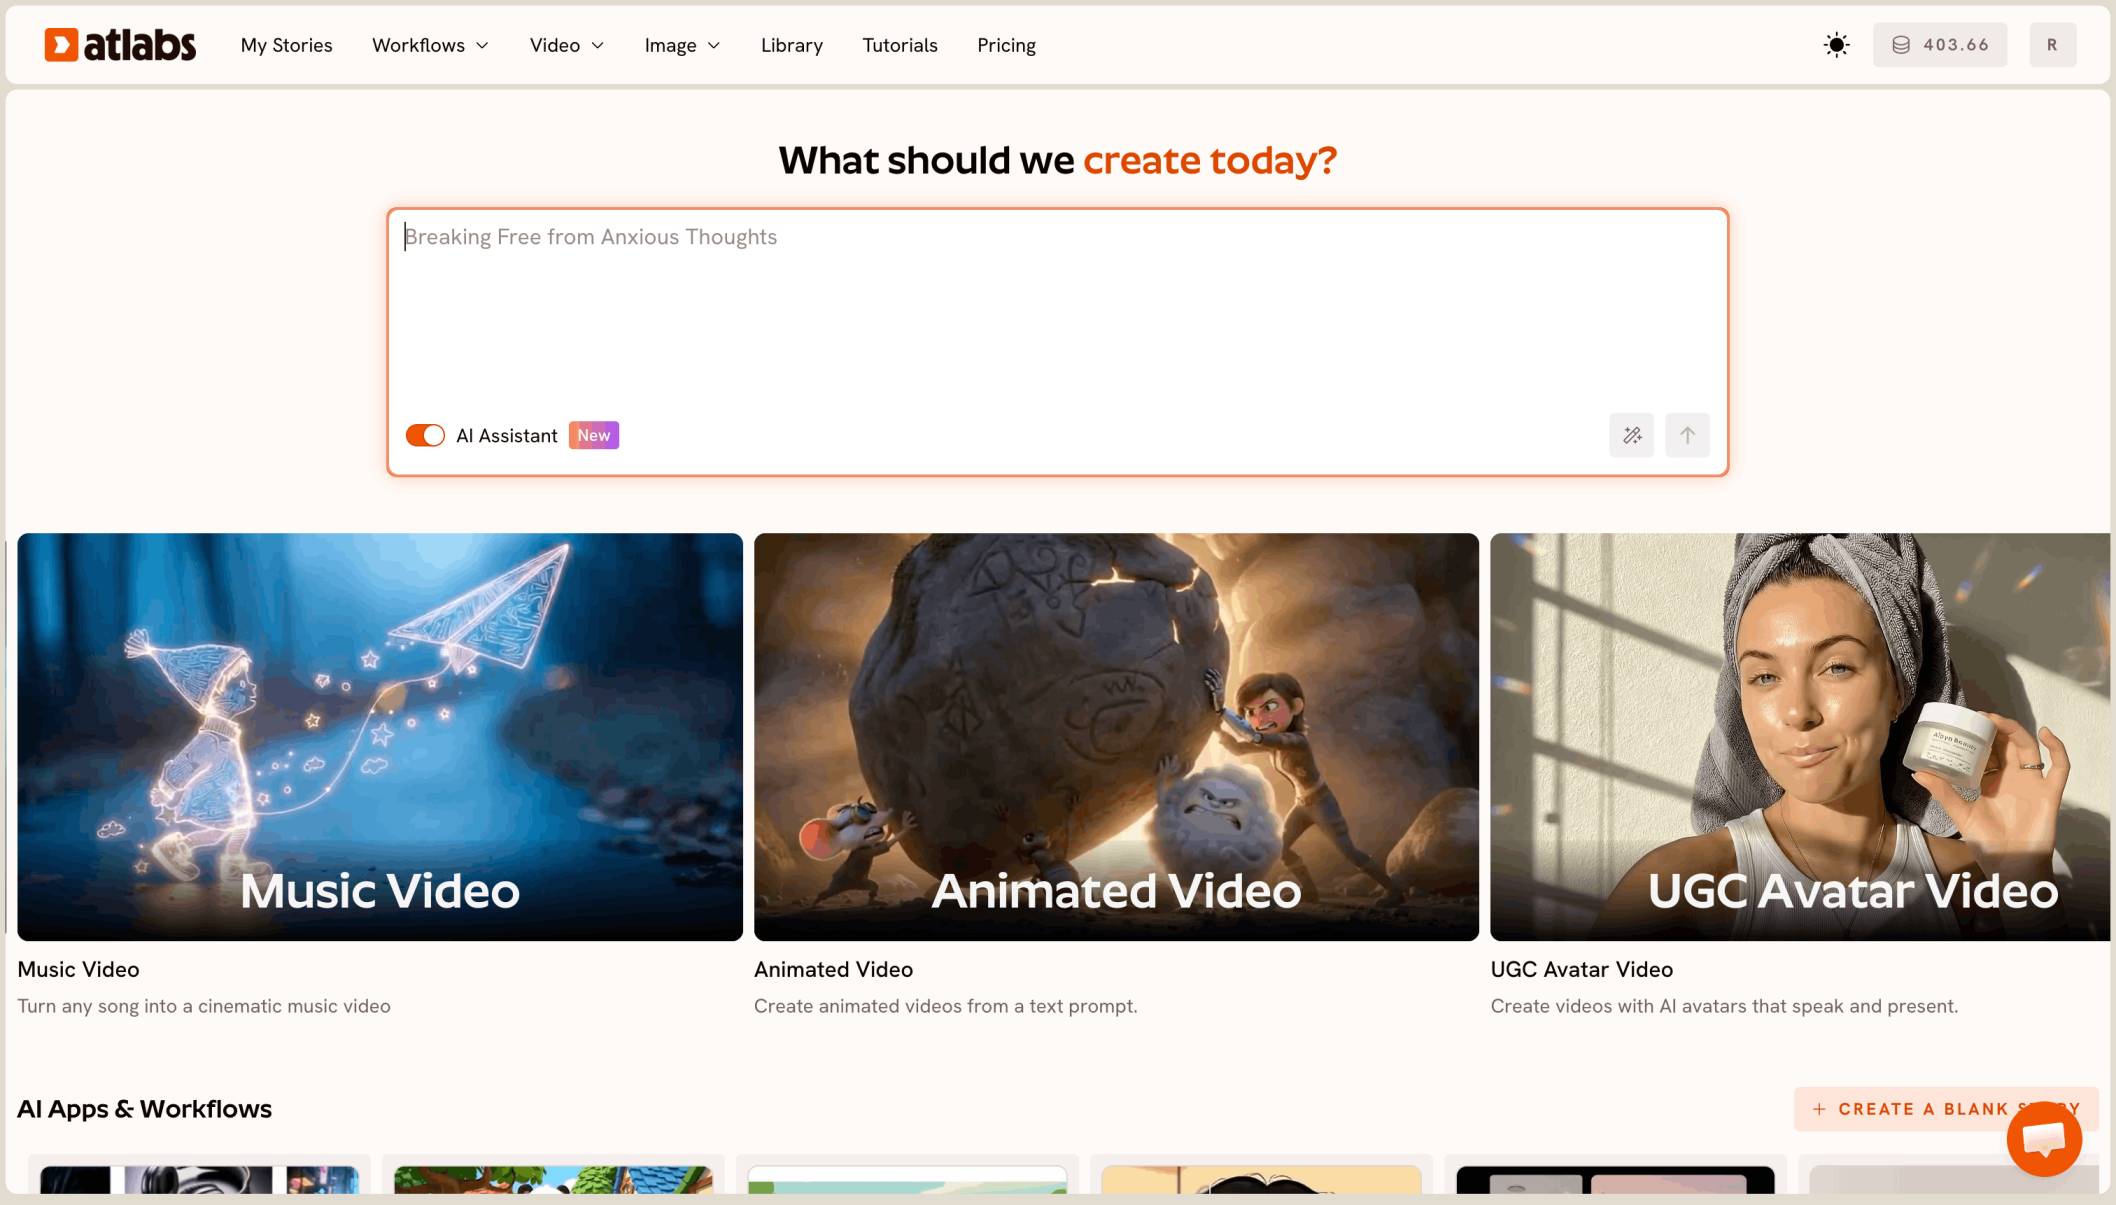
단계별 가이드: Atlabs AI에서 Mirror Voice 사용하기
첫 번째 캐릭터 장면 설정하기
Atlabs AI 프로젝트 열기
첫 번째 장면의 대사 작성 또는 대사 프롬프트가 포함된 이미지 업로드
텍스트-비디오 또는 이미지-비디오를 사용하여 비디오 생성
Mirror Voice 라이브러리에서 목소리 선택
Sync Voice(목소리 동기화) 클릭
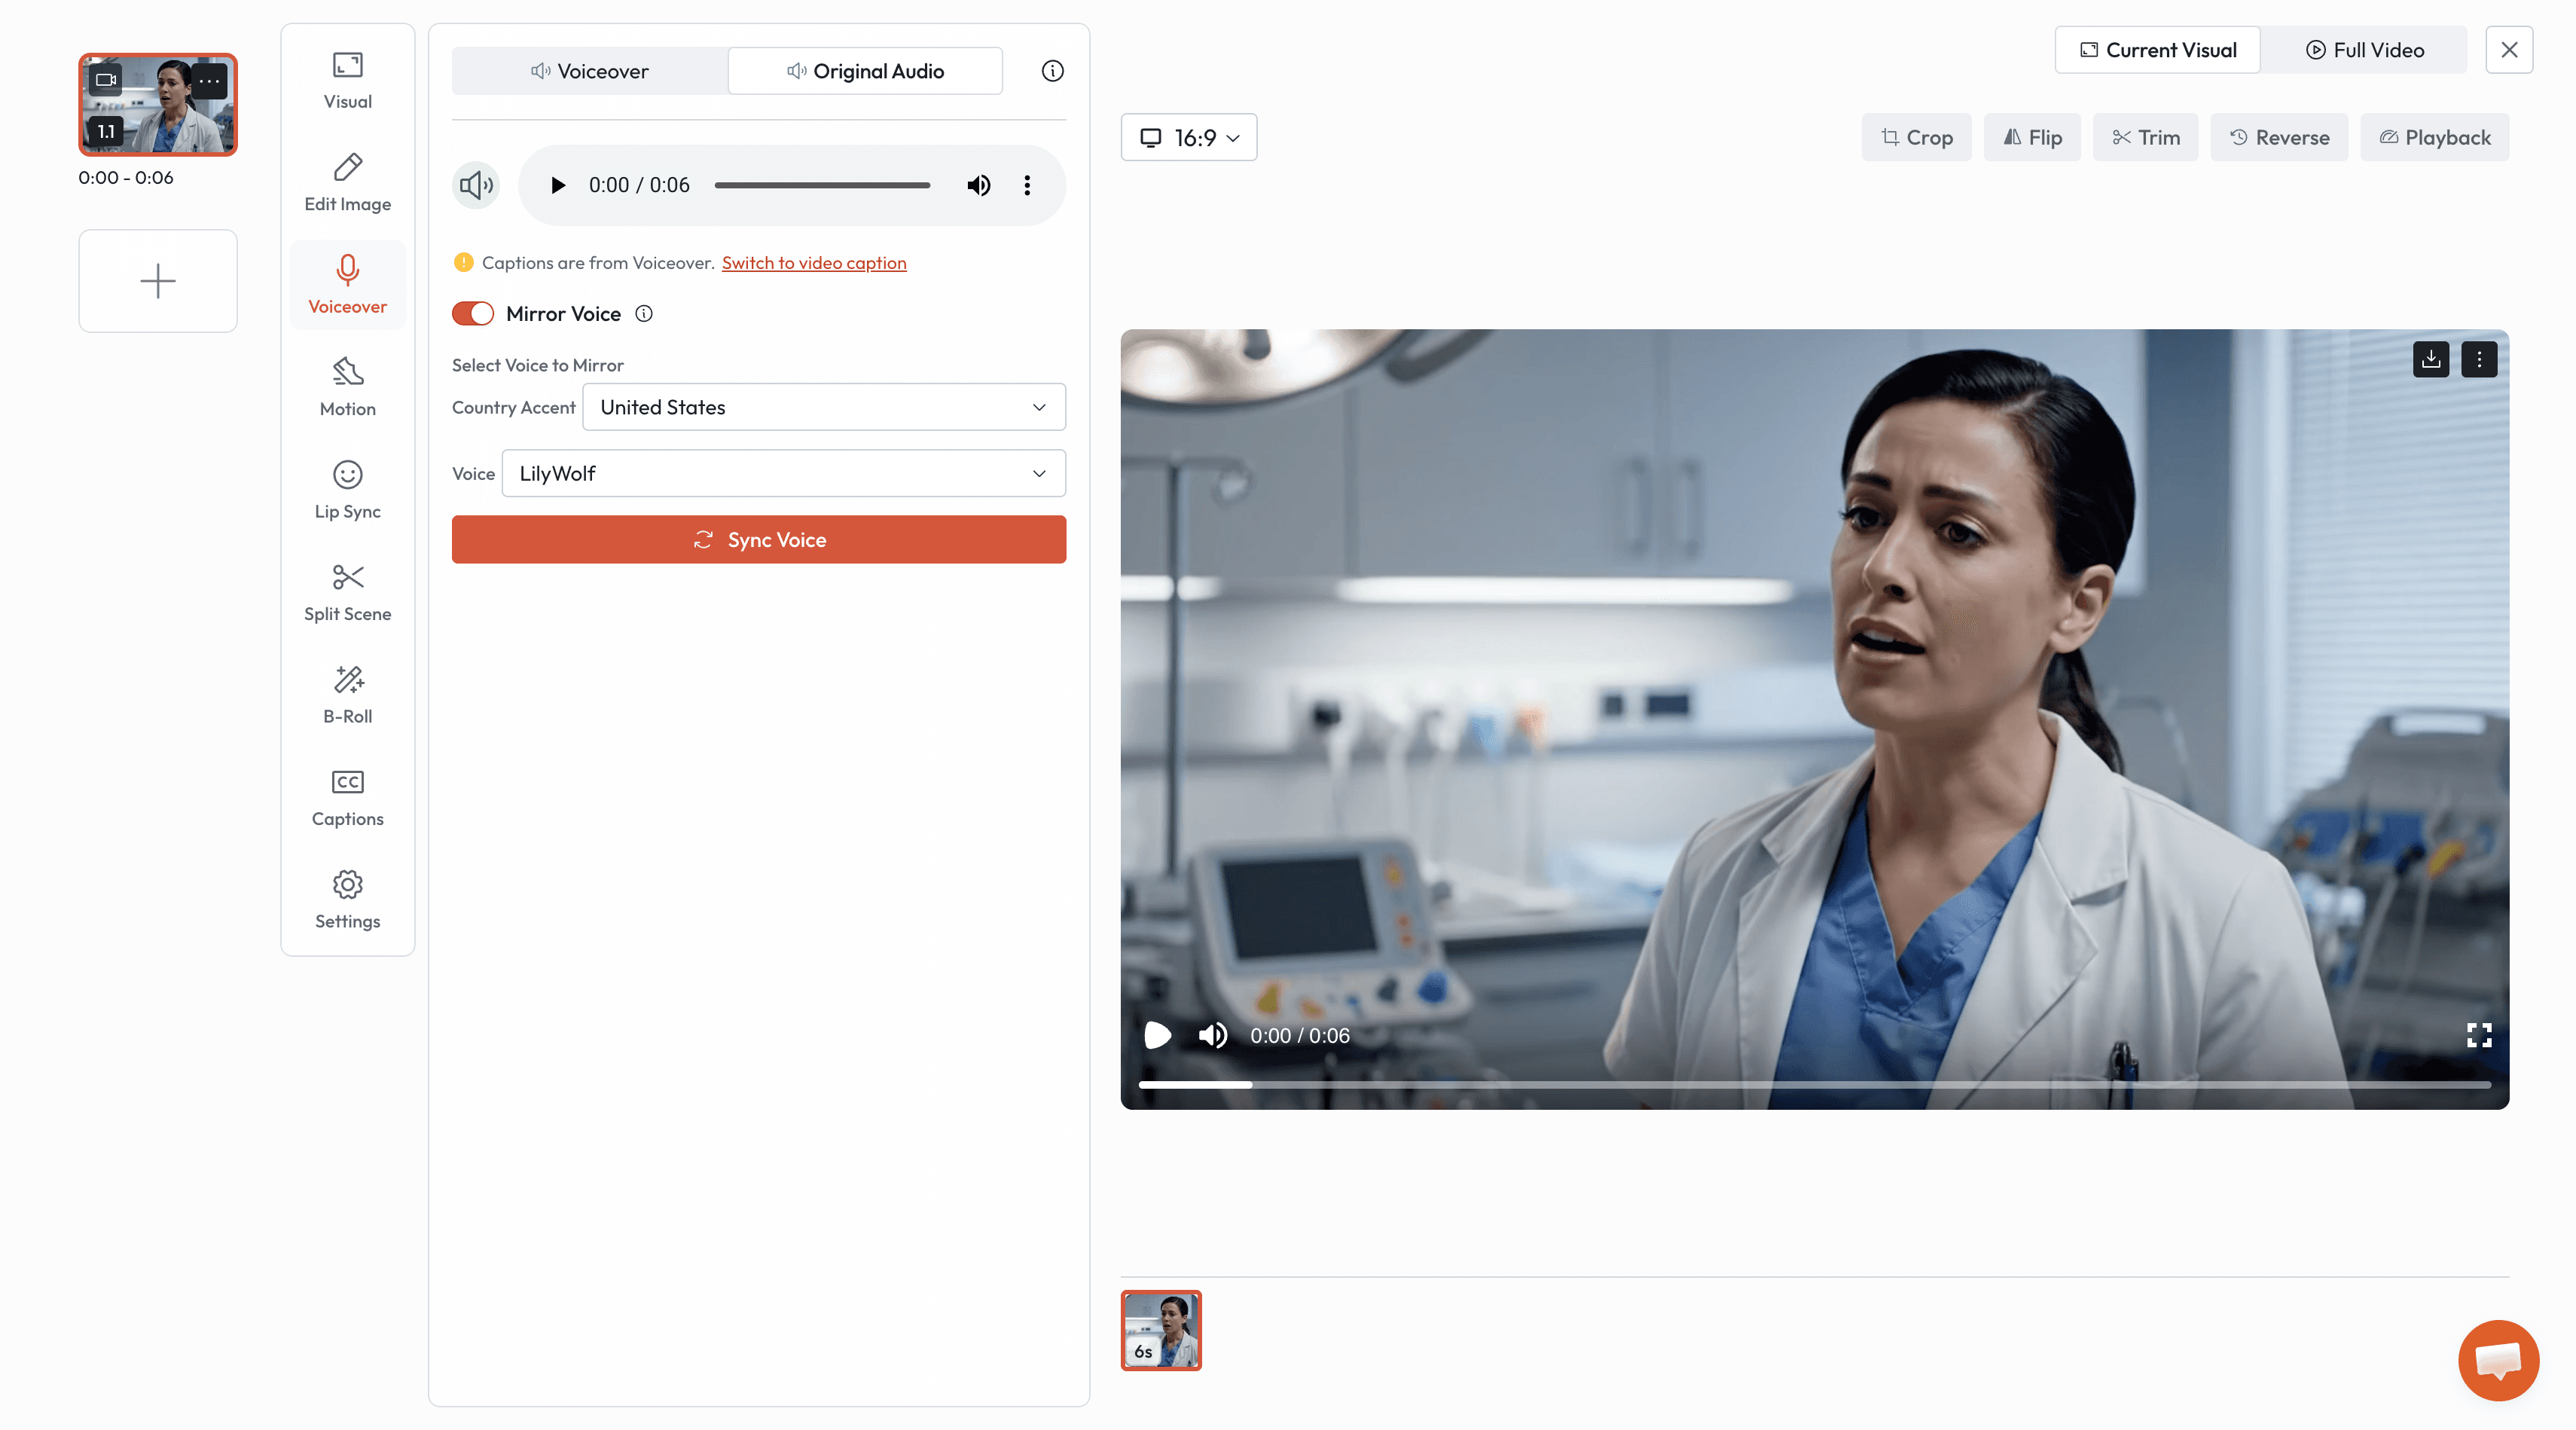
후속 장면에 Mirror Voice 사용하기
동일한 캐릭터의 다음 장면 대사 작성
비디오 생성 - 캐릭터가 일시적으로 다른 목소리로 말하게 둡니다
Voice over(더빙) 섹션에서 Mirror Voice 기능 선택
Atlabs AI 라이브러리에서 동일한 목소리 선택
Sync Voice(목소리 동기화) 클릭
이 캐릭터가 등장하는 남은 모든 장면에 대해 반복
실제 예시: 3개 장면의 미스터리 작품 만들기
Mirror Voice를 사용하여 세 명의 캐릭터가 등장하는 미스터리 장면을 만드는 전체 예시를 살펴보겠습니다.
장면 1: 발견
대사: "제대로 된 부검을 할 장비는 없지만, 자연사한 것은 아닙니다."
프로세스:
빈 Atlabs AI 프로젝트 만들기
모션 생성 섹션에 프롬프트 입력
비디오 생성
더빙 섹션 - 원본 오디오 클릭
Mirror Voice 클릭
마음에 드는 목소리 선택
목소리 동기화(Sync)
장면 2: 반응
대사: "그럴 줄 알았어요. 무엇 때문이라고 생각하시나요? 일종의 독약인가요?"
프로세스:
새로운 대사 입력
Mirror Voice 활성화
"Dr. Chen Voice" 선택
비디오 생성 결과: 첸 박사의 목소리가 장면 1과 동일하게 들림
장면 3: 경고
대사: "아무도 이 사실을 알아선 안 됩니다. 너무 위험해요."
프로세스:
새로운 대사 입력
Mirror Voice 활성화
"Dr. Chen Voice" 선택
비디오 생성 결과: 첸 박사가 세 장면 모두에서 동일한 목소리를 유지함
Atlabs Mirror Voice의 장점
1. 완벽한 일관성
85~95%의 일관성을 제공하는 수동 프롬프트 방식과 달리, Mirror Voice는 정확히 동일한 목소리 모델을 사용하므로 100%의 목소리 일관성을 제공합니다.
2. 시간 절약
복잡한 목소리 묘사 프롬프트를 작성할 필요가 없음
다양한 프롬프트로 시행착오를 겪을 필요가 없음
목소리 불일치로 인해 클립을 다시 생성할 필요가 없음
10~15분 대신 2~3분 만에 새로운 장면 생성 가능
3. 초보자 친화적
기술적 지식 필요 없음
목소리 특징에 대한 이해 필요 없음
간편한 토글 및 선택 인터페이스
매번 첫 번째 시도에서 바로 작동
4. 전문적인 결과물
방송 품질 수준의 목소리 일관성
클라이언트 프로젝트 및 상업적 용도에 적합
사후 오디오 수정 작업 불필요
시청자의 몰입감 지속 유지
5. 무제한 캐릭터
프로젝트에 필요한 만큼 많은 캐릭터 생성 가능
각 캐릭터가 자신만의 독특한 목소리를 유지
다중 캐릭터 대화를 간편하게 관리
다양한 인물이 등장하는 복잡한 내러티브에 적합
자주 묻는 질문 (FAQ)
Q: Mirror Voice가 작동하려면 동일한 비디오 모델을 사용해야 하나요?
A: 아닙니다. Mirror Voice는 Atlabs AI 내의 텍스트-비디오 및 이미지-비디오 모델 모두에서 작동합니다. 텍스트-비디오 클립의 목소리를 이미지-비디오 클립으로 미러링할 수 있습니다.
Q: 미러링된 목소리를 편집할 수 있나요?
A: Mirror Voice는 라이브러리의 정확한 목소리를 사용합니다. 다른 목소리를 원하시면 라이브러리에서 새로운 목소리를 선택하시면 됩니다.
Q: 프로젝트당 몇 개의 목소리를 저장할 수 있나요?
A: 제한 없이 무제한으로 목소리를 가질 수 있습니다.
Q: Mirror Voice는 배경 캐릭터에게도 작동하나요?
A: 네! 대사가 있는 모든 캐릭터는 주인공이든 배경 캐릭터든 상관없이 Mirror Voice를 사용할 수 있습니다.
Mirror Voice vs 기존 방식
Mirror Voice 미사용 시
매 생성마다 무작위 목소리 생성
수동 목소리 설명 프롬프트 필요
상세한 프롬프트를 사용해도 일관성 없는 결과
시간이 많이 걸리는 시행착오
기껏해야 85~90%의 일관성
고급 프롬프트 작성 기술 필요
Atlabs Mirror Voice 사용 시
매 생성마다 동일한 목소리 보장
첫 클립 이후 프롬프트 불필요
자동으로 완벽한 일관성 유지
한 번의 클릭으로 해결
100% 일관성
초보자도 쉽게 사용 가능
결론
목소리 일관성은 더 이상 AI 비디오 생성의 걸림돌이 아닙니다. Atlabs AI의 Mirror Voice 기능은 무작위 목소리 생성을 제거하고 모든 장면에서 모든 캐릭터가 일관되고 전문적인 목소리를 유지하도록 보장합니다.
Atlabs AI만의 장점:
100% 목소리 일관성 보장
기술적 기술 요구 사항 없음
수많은 재생성 시간 절약
전문적인 방송 품질의 결과물
프로젝트당 무제한 캐릭터 지원
텍스트-비디오 및 이미지-비디오 간 완벽 작동
일관성 없는 캐릭터 목소리로 더 이상 스트레스받지 마세요. Atlabs Mirror Voice를 사용하여 모든 장면에서 완벽한 목소리 일관성을 갖춘 전문적인 AI 비디오 제작을 시작해 보세요.
간편한 목소리 일관성을 경험할 준비가 되셨나요?