Quatre changements, une seule direction
La plupart des vidéos générées par l'IA ont un défaut révélateur, et ce n'est pas la résolution. C'est que tout arrive à une seule personne, au même endroit, dans le même type de plan. Un clip musical devient un chanteur devant un fond pendant quatre-vingt-dix secondes. Une leçon devient une narration sur des images. Une scène avec deux personnes devient deux générations séparées que vous montez ensemble en espérant que personne ne regarde de trop près.
Les quatre changements arrivés récemment poussent tous contre ce même mur. Music Performance compose désormais par défaut des types de scènes variés, y compris des instruments et de la performance scénique plutôt que des plans de chant répétés. Elle accepte aussi vos propres données dès le départ et caste à la fois des personnages qui chantent et d'autres qui ne chantent pas à partir des images que vous fournissez. Kids Performance peut construire une leçon autour d'un personnage enseignant avec synchronisation labiale. Et la synchronisation labiale gère désormais plusieurs personnages dans la même vidéo.
Lus séparément, ils ressemblent à quatre améliorations distinctes. Lus ensemble, ils décrivent un seul basculement : les parties d'une vidéo que vous deviez assembler vous-même se produisent maintenant à l'intérieur de la génération.
Découvrir les nouveautés d'Atlabs
Music Performance : des scènes qui dépassent le simple chanteur

Le changement porte sur la composition et le cadrage. Music Performance produit désormais une plus large gamme de types de scènes dans une même vidéo, y compris des scènes d'instruments et de performance scénique, plutôt que des variantes d'une personne qui chante face caméra.
Pour comprendre pourquoi c'est important, pensez à la façon dont un vrai clip musical est monté. Presque aucune partie de la durée n'est un plan fixe sur un chanteur. Vous avez le chanteur, puis des mains qui bougent sur un manche de guitare, puis un batteur à moitié éclairé au fond d'une salle, puis un plan large de la scène avec le public en silhouette, puis de nouveau le chanteur sous un autre angle, à une autre distance. Le rythme de ces coupes explique en grande partie ce qui fait qu'une vidéo se perçoit comme un clip musical plutôt que comme l'enregistrement de quelqu'un qui chante. Un modèle qui ne produit que le premier type de plan vous laisse des images techniquement correctes mais structurellement plates, et la solution consistait à générer chaque type de plan supplémentaire séparément, puis à les monter vous-même.
Produire ces types de plans dans un seul flux signifie que le rythme de montage devient disponible sans passe de montage séparée. La vidéo arrive déjà variée, ce qui est un point de départ différent d'une vidéo qui arrive uniforme et qu'il faut varier.
Le détail à retenir est que cela s'applique en mode par défaut. Les améliorations qui n'apparaissent qu'une fois les réglages avancés configurés sont des améliorations que la plupart des gens ne rencontrent jamais, car la plupart des gens génèrent une fois avec les réglages par défaut et jugent l'outil sur ce qui revient. Un meilleur résultat dès la première exécution non configurée est la version de cette amélioration qui atteint réellement les utilisateurs.
Concrètement, cela élargit le public du flux. Un artiste indépendant qui sort un single obtient quelque chose de plus proche d'une vidéo de performance que d'un visuel de paroles. Un artiste de reprises obtient des plans d'instruments sans posséder de caméra. Quiconque produit du contenu musical en langue régionale, où le budget d'un tournage existe rarement alors que le public attend une vraie vidéo, obtient la variété de plans sur laquelle repose cette attente.
Castez votre propre clip musical
Le deuxième changement est une refonte de la façon dont Music Performance démarre. Vous pouvez ajouter vos propres données au début du flux, et le casting accepte à la fois des images de chanteur et de non-chanteur.
Ce second point pèse plus lourd qu'il n'y paraît. Jusqu'ici, les personnes d'un clip musical généré étaient des personnes inventées par le modèle, ce qui limite l'usage du résultat. Une vidéo mettant en scène un inconnu est une pièce d'ambiance. Une vidéo mettant en scène l'artiste est un atout de sortie. Ajouter votre propre chanteur signifie que la personne qui se produit à l'écran est celle qui se produit sur le morceau, et ce simple changement fait passer le résultat de quelque chose que vous montrez à vos amis à quelque chose que vous mettez dans une sortie officielle.
L'emplacement du non-chanteur ouvre une catégorie jusqu'ici entièrement fermée. De nombreuses chansons ne parlent pas de l'acte de chanter, elles parlent d'une personne, et cette personne doit être à l'écran sans jamais dire une ligne. Le répertoire romantique en est le cas le plus clair. Une chanson d'amour est un duo : l'artiste se produit et un second rôle principal porte la moitié émotionnelle de l'histoire, apparaissant dans les scènes que décrivent les paroles plutôt que de les mimer. Caster un partenaire, un ami ou un acteur comme personnage non chanteur vous donne directement ce second rôle principal.
La même structure couvre bien plus que la romance dès qu'on la cherche. Un traitement narratif où l'artiste se produit tandis que d'autres personnages jouent l'histoire. Un hommage où le sujet apparaît du début à la fin sans chanter. Une pièce familiale ou communautaire où de vraies personnes sont présentes en tant qu'elles-mêmes. Une collaboration de marque où un porte-parole apparaît aux côtés de l'artiste. Tout cela a la même forme : une voix, plusieurs visages.
Combiné à la synchronisation labiale sur la chanson de votre choix, le flux devient un outil de casting plutôt qu'un générateur dont vous acceptez le résultat. C'est un changement de posture important. Vous décidez qui figure dans la vidéo avant la génération, au lieu d'évaluer après coup qui s'y est présenté.
Bien choisir les images sources aide ici comme pour toute génération pilotée par l'identité. Des visages de face, uniformément éclairés et dégagés laissent le moins de place à la devinette. Une forte ombre sur la moitié du visage, des lunettes de soleil, un flou de mouvement et des angles extrêmes réduisent tous la constance avec laquelle cette personne se maintient d'une scène à l'autre, ce qui mérite une minute de sélection d'images avant de dépenser une génération pour le découvrir.
Castez votre propre clip musical
Kids Performance : un enseignant qui parle vraiment
Kids Performance peut désormais construire du contenu éducatif autour d'un personnage enseignant dont la bouche bouge sur ses propres répliques, et uniquement les siennes.
La vidéo éducative pour enfants a une exigence que la génération vidéo généraliste a tendance à manquer. Les jeunes spectateurs suivent les visages. L'attention se maintient quand un personnage les regarde et leur parle, et elle chute quand une voix narre par-dessus des illustrations qui ne lui répondent pas. C'est proche du fonctionnement de l'attention à cet âge, et c'est pourquoi presque tous les formats pour enfants qui réussissent, sur n'importe quelle plateforme, reposent sur un présentateur, une marionnette ou un personnage qui s'adresse directement au public.
Ce qui posait problème auparavant, c'était ce qui se passait quand un second personnage partageait le cadre. Chaque bouche de la scène bougeait sur chaque réplique, si bien qu'un enseignant et un élève mimaient tous deux la phrase de l'enseignant, et la vidéo cessait de se lire comme une leçon pour se lire comme une erreur. Désormais, la parole est attribuée. L'enseignant dit la réplique, l'élève reste immobile et écoute, et le spectateur peut savoir qui parle, ce qui est tout le fondement d'une leçon à deux personnages.
C'est cette attribution, et non la seule synchronisation labiale, qui fait fonctionner les formats. L'explication de concepts fonctionne parce qu'un personnage peut dire « regardez ce qui se passe quand je fais ça » puis le faire. La phonétique et les sons des lettres fonctionnent parce que la forme de la bouche fait partie de l'apprentissage plutôt que d'en être un accessoire. Le comptage et les suites de nombres fonctionnent parce que le rythme vient d'une personne qui parle plutôt que d'un minuteur de sous-titres. La science pas à pas fonctionne parce qu'un présentateur peut mener un spectateur à travers une séquence d'une façon qu'une narration sur des images fixes ne peut pas. Les formats questions-réponses fonctionnent désormais comme ils ne le pouvaient tout simplement pas avant, car l'élève peut poser la question et l'enseignant y répondre sans que les deux semblent dire la même chose.
Pour l'exploitant d'une chaîne pour enfants, cela fait passer la question de production de comment faire des diaporamas narrés plus vite à comment faire des leçons avec une distribution. Pour un enseignant ou une équipe edtech, cela signifie que le matériel de classe peut mettre en scène un présentateur constant, et un second personnage pour poser les questions qu'une classe poserait, sans filmer personne.
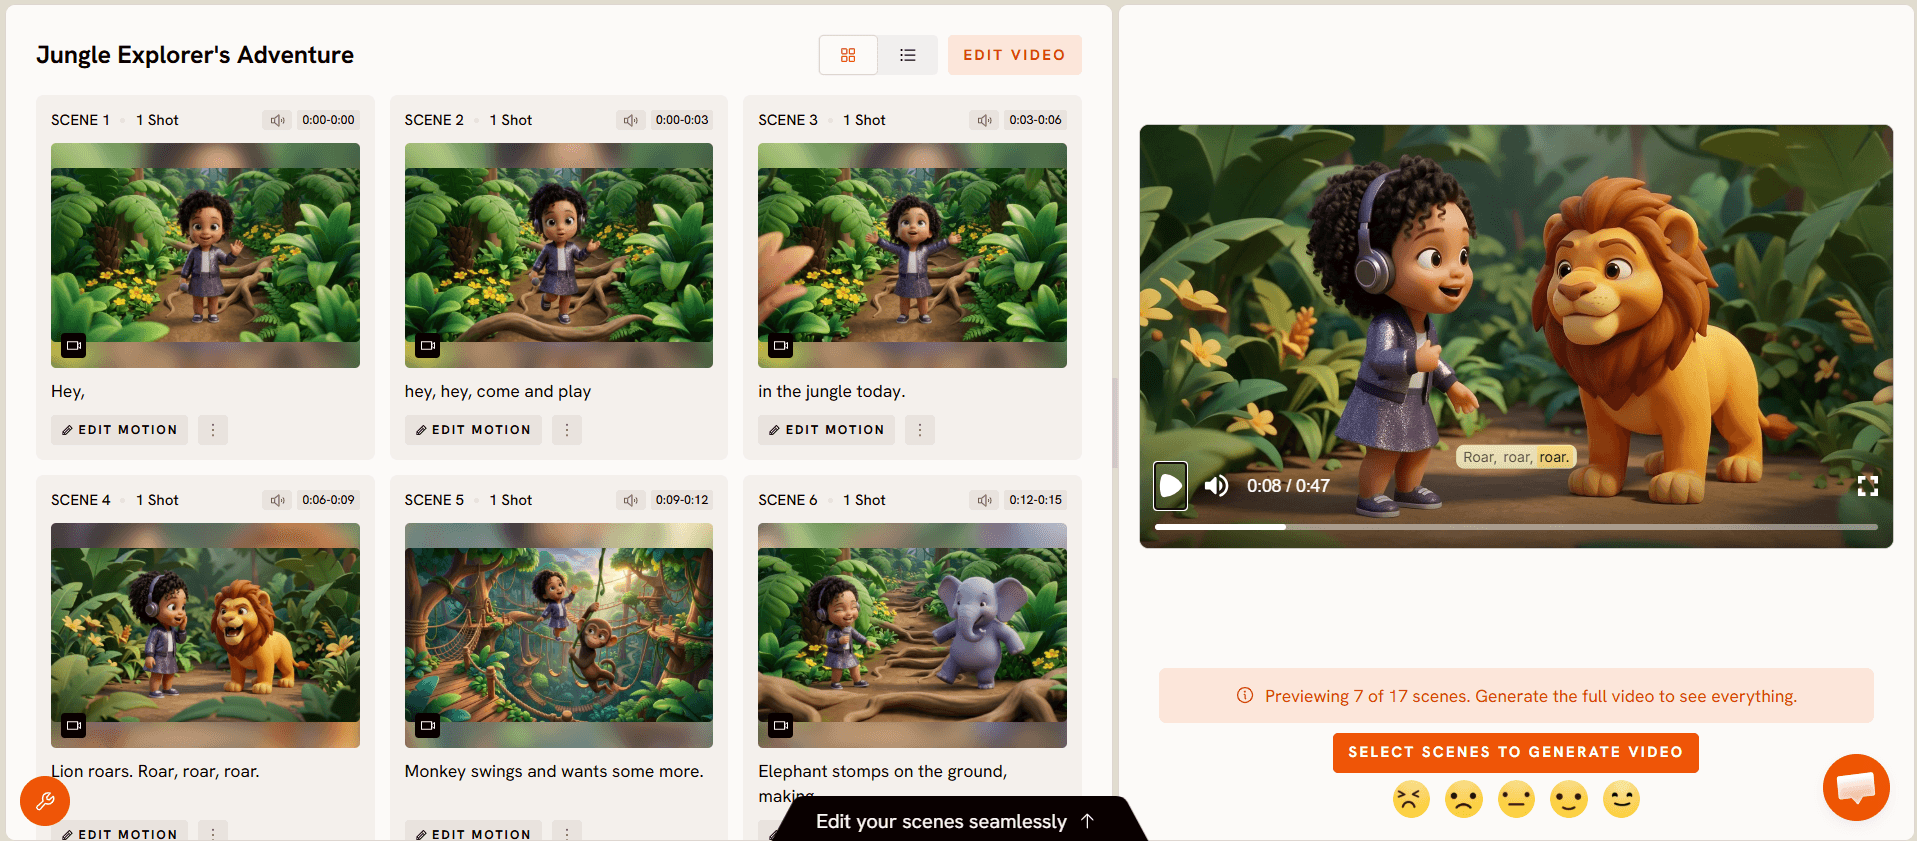
Écrire pour ce public récompense la retenue. Une idée par temps, des phrases courtes et une répétition délibérée de l'expression clé. Un personnage synchronisé qui lit des phrases denses d'adulte produit une vidéo qui fonctionne techniquement mais n'enseigne rien, car la diction dépasse l'auditeur.
Synchronisation labiale multi-personnages
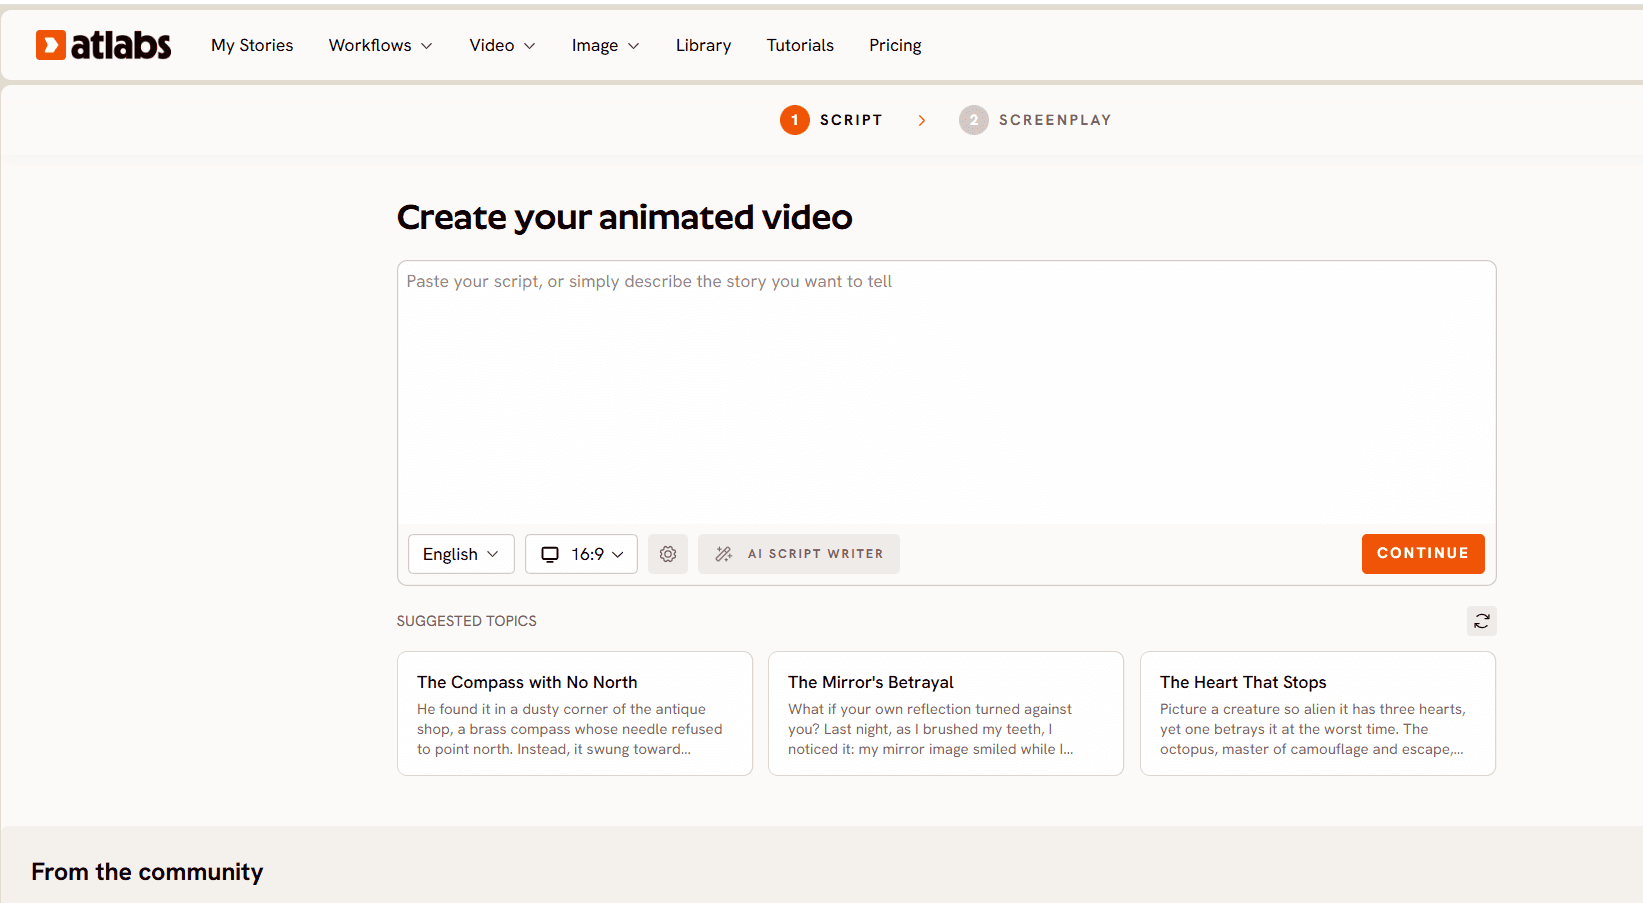
La synchronisation labiale fonctionne désormais avec plusieurs personnages plutôt qu'un seul.
La synchronisation labiale à un seul personnage couvre le plan de tête parlante, et la tête parlante couvre une bande étonnamment étroite de ce que les gens veulent créer. Tout ce qui est conversationnel reste en dehors. Deux personnages qui échangent des répliques. Un enseignant et un élève. Une interview. Un client et un agent du support dans une vidéo explicative de produit. Un parent et un enfant dans une histoire. Une section d'appel et de réponse dans un refrain. Dans chacun de ces cas, la réponse compte autant que la réplique.
Les produire avec une synchronisation labiale à un seul personnage impliquait de générer chaque intervenant séparément, puis de passer de l'un à l'autre au montage. C'est lent, et surtout cela se voit pour ce que c'est. Les deux moitiés ne partagent jamais tout à fait une pièce, les lignes de regard ne concordent pas, la lumière dérive, et le timing de l'échange doit être fabriqué au montage plutôt que joué. Quiconque a essayé de simuler ainsi une conversation à deux sait que le résultat se lit comme deux monologues posés côte à côte.
Gérer plus d'un intervenant dans la même génération fait du dialogue une sortie native. L'échange se déroule dans un seul espace, avec un seul éclairage, et avec un timing qui appartient à la scène plutôt qu'à votre timeline.
C'est aussi la capacité qui se trouve sous la plupart des trois autres. Un clip musical casté avec un second rôle non chanteur cesse d'être convaincant dès que ce personnage doit dire quelque chose. Une leçon avec un personnage enseignant s'améliore nettement quand un second personnage peut poser la question à laquelle la leçon répond. La synchronisation labiale multi-personnages est ce qui fait tenir ces formats ensemble.
Comment tirer le meilleur de ces changements
1. Décidez de votre distribution avant d'écrire quoi que ce soit. Qui chante, qui apparaît et qui parle sont désormais trois questions différentes, et y répondre dès le départ change ce que vous écrivez. Une chanson avec un second rôle principal a besoin de scènes où ce rôle peut figurer.
2. Rassemblez correctement les images sources. De face, uniformément éclairées, un seul visage net par image. Prenez la minute supplémentaire ici plutôt que de diagnostiquer plus tard une dérive d'identité.
3. Générez d'abord en mode par défaut. Les améliorations de composition des scènes s'y appliquent, votre première exécution est donc un test honnête du flux plutôt qu'un exercice de configuration. Modifiez les réglages une fois que vous avez vu une base de référence.
4. Écrivez le dialogue comme un échange, pas comme deux discours. Maintenant que plusieurs personnages peuvent parler, de courtes répliques alternées valent mieux que de longs blocs. Laissez le second personnage interrompre, demander ou réagir.
5. Pour le contenu enfants, écrivez au rythme, pas à la page. Une idée par temps, répétez l'expression clé et laissez au personnage la place d'être regardé plutôt que seulement écouté.
Exemples de prompts
1. Performance d'un groupe complet. Un quatuor indie se produit dans un entrepôt aménagé au crépuscule, des guirlandes lumineuses au-dessus, de la poussière dans l'air. Alternance entre la chanteuse au micro, des mains qui bougent sur le manche d'une basse, le batteur à moitié éclairé au fond, et un plan large de la salle avec le petit public en silhouette. Éclairage chaud et naturel, faible profondeur de champ, rendu caméra à l'épaule sur les plans larges. Essayez ceci dans Atlabs Music Performance
2. Traitement romantique à deux rôles principaux. Un toit-terrasse à l'heure bleue, la brume de la ville accrochant les dernières lueurs. L'artiste se produit devant la ligne d'horizon pendant qu'un second personnage, qui ne chante jamais, traverse les scènes décrites par les paroles : assis sur le rebord, parcourant la cage d'escalier, observant depuis l'embrasure de la porte. Étalonnage doux et froid, tons chair chauds, mouvements de caméra lents du début à la fin. Essayez ceci dans Atlabs Music Performance
3. Focus sur un instrument solo. Un interprète seul devant un piano droit dans une salle de répétition vide, lumière du matin par de hautes fenêtres. Alternance entre un plan large de la salle, un gros plan sur les mains, un profil à hauteur des yeux et un lent travelling vers le visage sur la dernière phrase. Palette atténuée, lumière naturelle uniquement. Essayez ceci dans Atlabs Music Performance
4. Explication par un personnage enseignant. Une enseignante animée et chaleureuse, dans une salle de classe lumineuse, explique pourquoi la glace flotte en s'adressant directement à la caméra. Elle lève un verre d'eau, y laisse tomber un glaçon et pointe du doigt tandis qu'il remonte. Phrases courtes, une idée à la fois, l'expression clé répétée à la fin. Couleurs chaudes, arrière-plan simple, rien qui ne rivalise avec son visage. Essayez ceci dans Atlabs Kids Performance
5. Leçon à deux personnages. Un personnage enseignant et un élève curieux dans un jardin. L'élève demande pourquoi les feuilles changent de couleur, l'enseignant répond en trois courtes étapes, et l'élève répète la réponse. Les deux personnages parlent face caméra avec une lumière et des lignes de regard cohérentes. Palette lumineuse, douce, style livre d'histoires. Essayez ceci dans Atlabs Kids Performance
Lancez-les dans Atlabs
FAQ
Puis-je désormais utiliser mon propre visage dans un clip musical ? Oui. Music Performance accepte vos propres images dès le début du flux, pour les personnages qui chantent comme pour ceux qui ne chantent pas.
À quoi sert un membre de la distribution non chanteur ? À tout personnage qui apparaît sans interpréter la partie vocale. Un rôle romantique, un personnage d'histoire, le sujet d'un hommage, ou toute personne dont la présence compte pour le concept plutôt que pour la performance.
L'amélioration de la composition des scènes nécessite-t-elle des réglages particuliers ? Non. La gamme élargie de compositions, de cadrages et de types de scènes s'applique en mode par défaut, une première génération sans configuration en bénéficie donc.
Quels types de plans Music Performance produit-elle désormais ? Au-delà du chant face caméra, elle compose des types de scènes variés, y compris des scènes d'instruments et de performance scénique, dans la même vidéo.
À quoi sert la synchronisation labiale multi-personnages ? À toute vidéo où plus d'une personne parle. Conversations, échanges enseignant-élève, interviews et séquences d'appel et de réponse deviennent possibles en une seule génération.
Que puis-je créer avec un personnage enseignant synchronisé ? Des explications de concepts, de la phonétique et des sons de lettres, des séquences de comptage, de la science pas à pas, de l'apprentissage des langues et des leçons narratives. Tout ce qui passe mieux par un présentateur que par une narration.
Ces changements fonctionnent-ils ensemble ? Oui, et c'est là que se trouve l'essentiel de la valeur. Le casting associé à la synchronisation labiale multi-personnages est ce qui fait tenir un clip musical à deux rôles principaux ou une leçon à deux personnages comme une seule scène.
Ce que tout cela représente
Le fil conducteur de ces quatre changements est que le travail qui se faisait après la génération se fait désormais pendant celle-ci. La variété des plans était un problème de montage. Un second personnage était une seconde génération. Un dialogue, c'était deux clips montés ensemble. Le casting n'était pas vraiment disponible du tout.
Pour les créateurs de musique, cela donne une vidéo qui paraît montée plutôt que générée, mettant en scène l'artiste réel et les personnes réelles dont parle la chanson. Pour les créateurs de contenu éducatif, cela donne une leçon avec un présentateur plutôt qu'un diaporama narré. Dans les deux cas, cela signifie moins de générations séparées à réconcilier et moins d'endroits où les coutures se voient.