¿Qué es Flux 3?
Flux 3, también escrito FLUX 3 o FLUX.3, es el primer modelo de video de Black Forest Labs. Genera clips de hasta 20 segundos con audio nativo sincronizado en una sola pasada a 480p y 720p, con Full HD disponible en algunas plataformas. Admite texto a video, imagen a video, primer y último fotograma, fotogramas clave y continuación de video.
Lo que lo separa del resto no es la resolución. Es el conocimiento del formato. Nombra una época y un medio, como "un reporte de noticias locales de 1987", y el modelo reconstruye el trabajo de cámara, la iluminación, el ritmo, el vestuario y el ritmo de edición de ese formato, a menudo a partir de una frase corta que no tuviste que sobreespecificar.
Cuatro cosas que vale la pena saber antes de escribir tu primer prompt:
Audio nativo en la misma pasada: El sonido no es un segundo paso. El diálogo, el ambiente y los efectos se generan junto con la imagen, lo que significa que una mezcla no especificada sigue siendo una mezcla, solo que una que no elegiste.
Comprensión profunda del mundo y del formato: Los documentales históricos, las explicaciones de procesos y las adaptaciones de dominio público funcionan inusualmente bien, incluyendo tipografía en pantalla precisa, fechas y etapas de construcción.
Narrativa de múltiples tomas dentro de un solo clip: Una generación de 20 segundos puede contener varias tomas y un pequeño arco narrativo en lugar de un único momento estático.
Modo borrador: Iteración rápida y de bajo costo para probar una idea antes de comprometerse con un render de calidad completa.
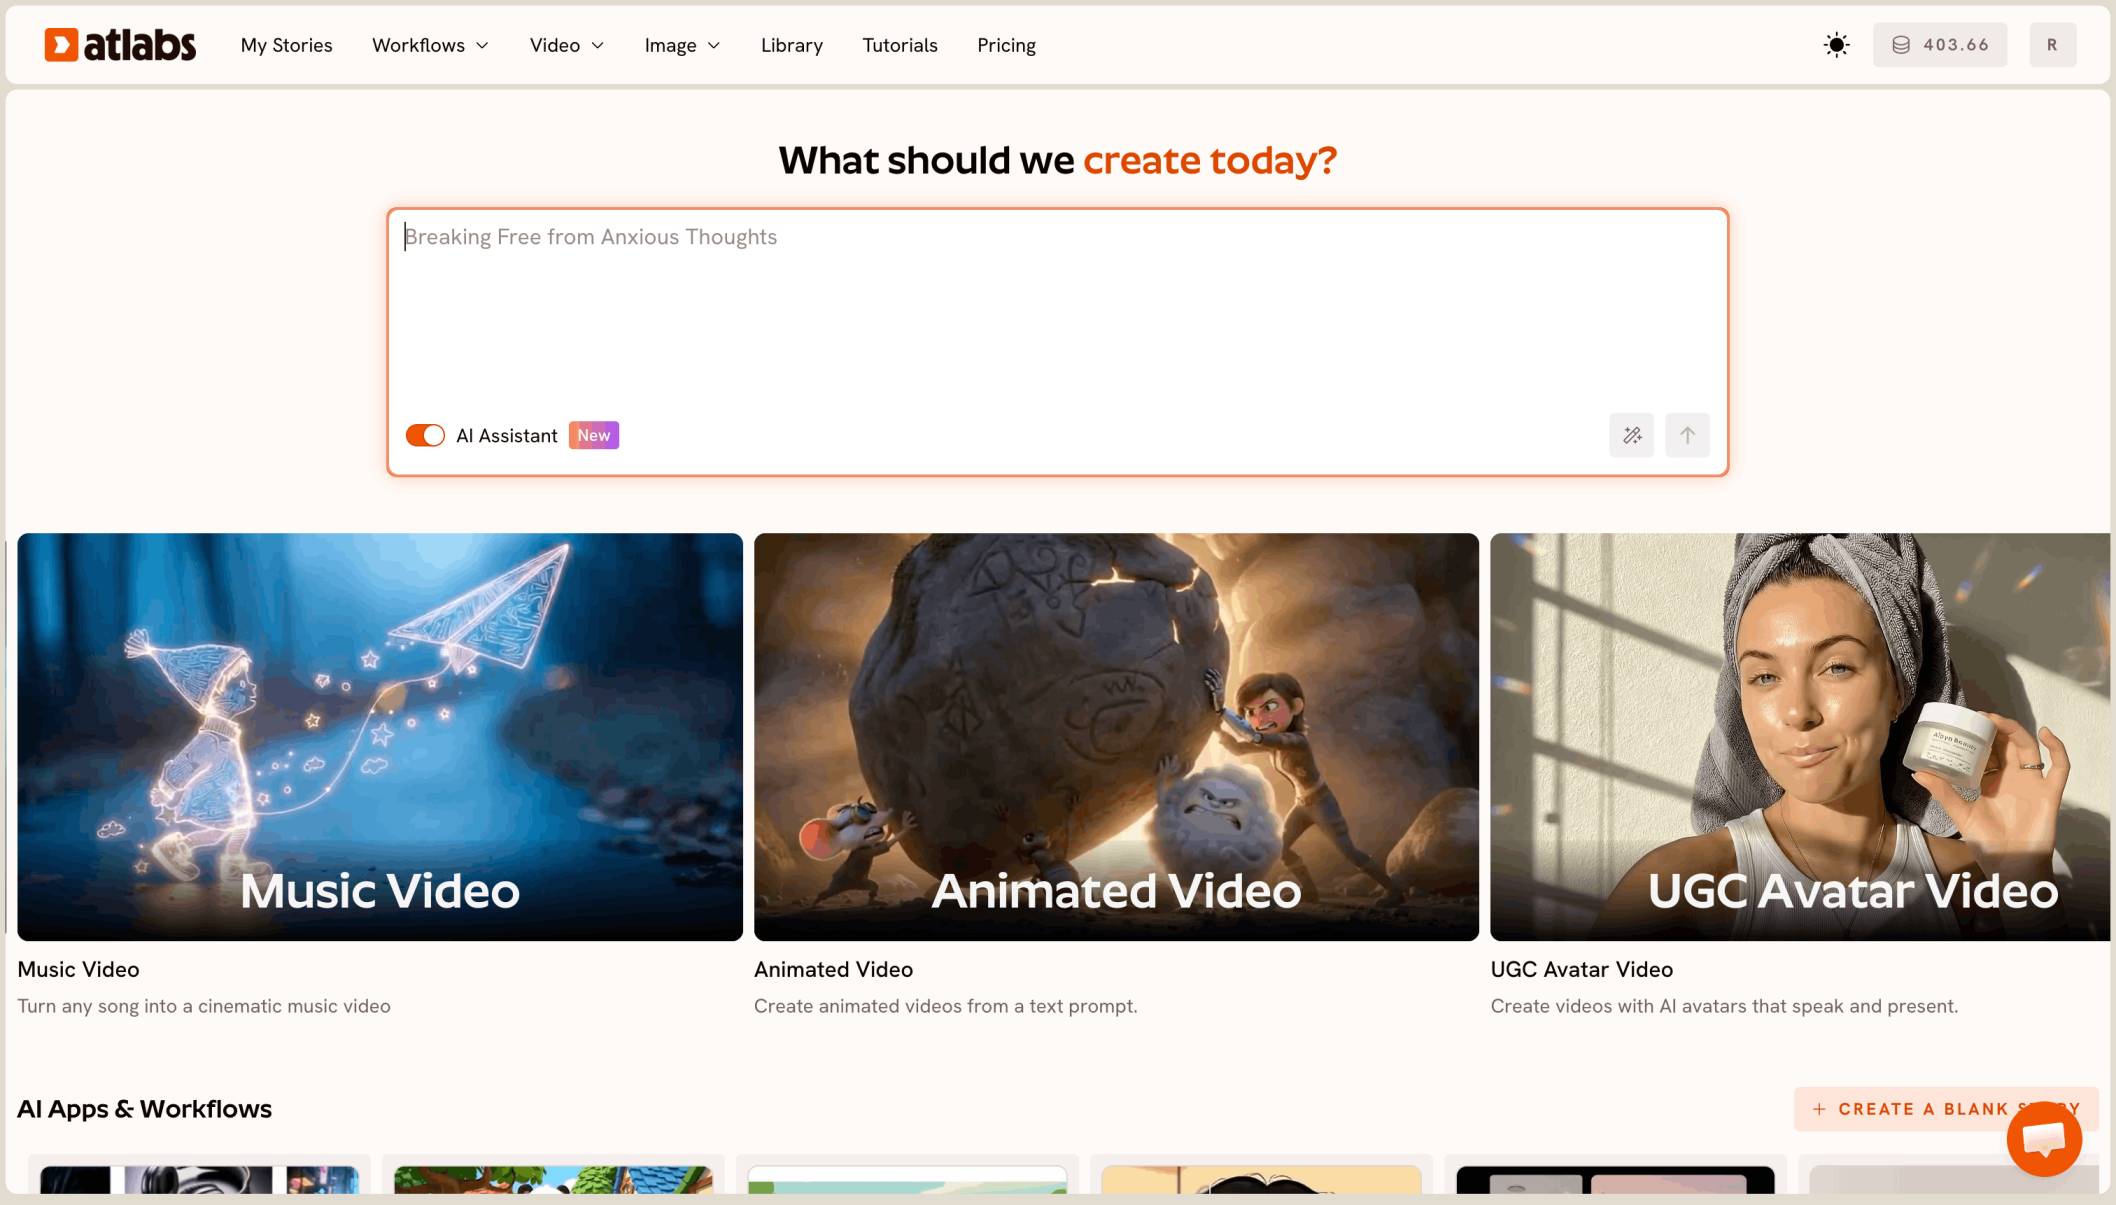
Flux 3 está disponible dentro de la gama de modelos de Atlabs, por lo que puedes ejecutarlo junto a Kling, Veo y Seedance sin necesidad de gestionar cuentas separadas para cada uno.
Prueba Flux 3 en Atlabs →
La fórmula del "prompt perfecto"
Flux 3 premia el hecho de nombrar el formato más que el de apilar adjetivos. Esto es lo opuesto a cómo se estructuraban los prompts para la mayoría de los modelos de video en 2024 y 2025, y es el hábito más difícil de desaprender. El prompt más fuerte suele ser el más corto.
La fórmula corta:
[Formato o época] + [Sujeto o evento]
La fórmula ampliada, para cuando necesitas un control más estricto:
[Sujeto] + [Acción] + [Entorno] + [Movimiento de cámara] + [Audio] + [Estilo]
La estructura confiable de una sola línea:
toma de [cámara] de [sujeto] [acción] en [entorno]
Desglose de ejemplo:
Toma el prompt más corto posible: un documental de 1969 sobre Woodstock. Seis palabras. Lo que se obtiene de vuelta incluye cámara en mano, textura de película descolorida, encuadre abarrotado, comportamiento espontáneo de la multitud, ropa de la época y el registro emocional del evento. Ninguna de esas palabras aparece en el prompt. El modelo ya sabía cómo se ve ese formato, y pedirlo por su nombre lo trajo todo de una vez.
Ahora la versión dirigida, para cuando tienes una toma específica en mente:
Una toma de seguimiento baja de un zorro corriendo a toda velocidad a través de un pinar húmedo al amanecer. Luz natural suave, profundidad de campo superficial, sonidos ambientales del bosque y cantos de pájaros lejanos. Estilo cinematográfico de documental de vida silvestre.
Ambos prompts son correctos. El primero utiliza el conocimiento del modelo, el segundo lo anula. Recurre al segundo solo cuando realmente necesites un encuadre específico, porque acumular adjetivos puede opacar lo que el modelo ya hace mejor por sí solo.
Construye tu primer clip →
5 plantillas de prompt de alto rendimiento
Copia estas en el generador de videos con IA en Atlabs e intercambia tu propio sujeto.
1. El documental histórico
Ideal para: atmósfera de época y reconstrucción de medios. Una frase es todo el prompt.
un reporte de noticias locales de 1987 sobre adolescentes pasando el rato en el centro comercial
un documental de televisión de 1989 sobre la caída del Muro de Berlín
una transmisión de televisión de 1969 del alunizaje
metraje de archivo del primer vuelo de los hermanos Wright en 1903. Sin sonido
2. El explicador de procesos
Ideal para: secuencias de cómo se construyó y cómo funciona, en el orden correcto.
Cómo se construyó el puente Golden Gate
Cómo se hizo la Gran Muralla China
¿Cómo se hacen las pirámides? Visualízalo.
3. El tráiler de dominio público
Ideal para: narrativa cinematográfica extraída de una obra conocida.
Visualiza Frankenstein de Mary Shelley como una película.
4. La toma cinematográfica dirigida
Ideal para: control preciso de cámara y movimiento.
La toma de un dron se desliza sobre un bosque bioluminiscente por la noche, luciérnagas flotando entre árboles resplandecientes, una suave niebla rodando por el suelo del bosque. Avance lento con un suave descenso de altitud. Sonidos ambientales del bosque y cantos de búhos lejanos. Gradación de color cinematográfica, niebla volumétrica.
5. La escena de diálogo multilingüe
Ideal para: habla natural y sincronización labial en varios idiomas.
Un mostrador de conexiones de aerolínea en Charles de Gaulle después de una cancelación. Un agente, una larga cola, una pantalla llena de rojo. AGENTE (francés): "Monsieur, je vous mets sur le vol de dix-huit heures." Continúa con líneas en árabe, inglés, portugués y ruso a medida que avanza la cola.
Prueba estas plantillas →
Galería de la comunidad
Cuatro creaciones que vale la pena estudiar, con las publicaciones originales para que puedas ver el resultado junto al prompt.
Velas de cumpleaños y física no solicitada por steve johnson: el modelo resolvió la causa y el efecto reales de soplar velas y volvió a encender las luces de la habitación sin que se lo pidieran. Ver la publicación
Secuencia de anime de 20 segundos con subtítulos precisos por Koh Terai: tipografía en pantalla que se mantiene legible y correcta a lo largo de una generación de duración completa. Ver la publicación
Escena de cola de aeropuerto en cinco idiomas por Koh Terai: la plantilla de diálogo multilingüe ejecutándose en su totalidad, con la sincronización labial manteniéndose a través de los cambios de idioma. Ver la publicación
Toma única de terror espacial de 20 segundos por Dominik Filkus: una sola escena de terror continua construida directamente a partir de la guía oficial de prompts. Ver la publicación
Haz un clip como estos →
Características avanzadas
¿Cómo obtengo los mejores resultados con prompts cortos?
Nombra el formato de grabación, la época y el sujeto. Flux 3 ya sabe cómo se ve y se mueve un paquete de noticias locales de los años 80, un documental de 1969 o una película de construcción de los años 30, incluyendo la duración de las tomas y el grano. Los adjetivos adicionales compiten con ese conocimiento interno en lugar de aportar, así que empieza con algo corto, observa el resultado y añade detalles específicos solo donde la generación no haya acertado.
Imagen a video y continuación
Dale al modelo una imagen inicial, o un primer y último fotograma, luego describe únicamente el movimiento o el cambio que deseas. Conecta los fotogramas manteniendo el lenguaje visual de la fuente. Para piezas más largas, la continuación te permite entregar unos segundos de metraje existente y describir qué debería pasar a continuación, que es como se supera el límite de 20 segundos sin un corte evidente.
Audio nativo
Describe el sonido siempre que sea importante. Pon el diálogo entre comillas con una etiqueta de idioma, nombra el ambiente y los efectos, y escribe "Sin sonido" cuando desees silencio. Debido a que el audio se genera en la misma pasada, dejarlo fuera no es una solicitud de un clip silencioso, sino una solicitud para cualquier mezcla que el modelo decida.
Empieza a generar en Atlabs →
Errores comunes que debes evitar
Describir en exceso un sujeto que el modelo ya conoce. Un prompt de formato de seis palabras supera regularmente a un párrafo de 100 palabras. Escribe la versión larga solo después de que la corta te haya fallado.
Olvidar el formato. "Adolescentes en un centro comercial" te da una toma. "Un reporte de noticias locales de 1987 sobre adolescentes pasando el rato en el centro comercial" te da un paquete de transmisión completo, con generador de caracteres incluido.
Ignorar el audio. Nómbralo o el modelo inventará una mezcla completa, y pasarás la siguiente generación intentando deshacer una banda sonora que nunca pediste.
Esperar una toma continua de 30 segundos. El límite es de 20 segundos. Planifica piezas más largas como continuaciones o clips encadenados en lugar de una única solicitud imposible.
Escribir prompts negativos. Los modelos de la familia Flux no utilizan prompts negativos tradicionales. Describe únicamente lo que quieres en el encuadre.
Comparación: Flux 3 frente a modelos de video típicos
Característica | Flux 3 | Competidores típicos |
|---|---|---|
Duración máxima nativa | Hasta 20 segundos | De 10 a 30 segundos dependiendo del modelo |
Audio nativo | Sí, en la misma pasada | Varía según el modelo |
Conocimiento del mundo y del formato | Muy fuerte | Fuerte pero con menor conciencia del formato |
Estilo de prompt | Los nombres de formato cortos suelen ganar | Instrucciones estructuradas más largas |
Iteración | Modo borrador para pruebas rápidas y de bajo costo | Por lo general, solo en calidad completa |
Ideal para | Documentales, explicadores, trailers | Tomas únicas cinematográficas, consistencia de personajes |
Versión corta: recurre a Flux 3 cuando el formato en sí mismo se encargue de contar la historia, lo que abarca documentales, material de archivo, explicadores y trabajos de adaptación. Recurre a un modelo enfocado en la consistencia cuando un rostro específico deba sobrevivir a una toma larga. Ambos se encuentran dentro de la gama de modelos de Atlabs, por lo que cambiar es cuestión de un menú desplegable en lugar de una cuenta nueva.
Compara modelos en Atlabs →
Recursos recomendados
Ejemplos y prompts de fal.ai Flux 3: fal.ai/learn/tools/flux-3-video-examples-prompts
Blog oficial de Black Forest Labs: bfl.ai/blog/flux-3-video
Guía oficial de prompts de FLUX: docs.bfl.ml/guides/prompting_summary
Guía de Morphic Flux 3: morphic.com/resources/how-to/flux-3-guide
Preguntas frecuentes
P: ¿Qué longitud puede tener un clip de Flux 3? R: Hasta 20 segundos en una sola generación. Para piezas más largas, usa la continuación y dale al modelo unos segundos de metraje existente a partir del cual construir.
P: ¿Flux 3 genera audio? R: Sí, audio nativo sincronizado en la misma pasada que la imagen. Especifica lo que deseas, incluyendo diálogos con etiquetas de idioma, o escribe "Sin sonido" para silencio.
P: ¿Qué tipo de prompt funciona mejor? R: Nombra el formato y el sujeto en una frase clara. Añade detalles de cámara, movimiento y audio solo cuando necesites un control más estricto que el que te ofrece el propio conocimiento del modelo.
P: ¿Puedo continuar un clip existente? R: Sí. Proporciona hasta unos segundos de video existente y describe qué debería pasar a continuación. El modelo conserva el lenguaje visual a través de la unión.
P: ¿Funcionan los prompts negativos? R: No. Los modelos de la familia Flux no utilizan prompts negativos tradicionales, así que describe únicamente lo que quieres ver en lugar de enumerar lo que quieres evitar.
Pensamos que esto podría interesarte
[Marcador de posición para insertar tutorial de YouTube de Atlabs]
Haz tu primer video con IA en Atlabs →
Dos cosas a confirmar antes de enviar esto. Primero, enlacé Flux 3 a la página general de modelos en lugar de a una página de modelo dedicada, ya que no conozco la estructura del enlace. Si hay una página activa de /models/flux-3, cambia ambas menciones. Segundo, si quieres que Flux 3 sea nombrado dentro de un flujo de trabajo específico de Atlabs, dime a través de cuál se dirige y lo integraré en la introducción y en el veredicto de la comparación.