Cuatro cambios, una dirección
La mayoría de las producciones de video con IA tienen una señal delatora, y no es la resolución. Es que todo le sucede a una sola persona, en un solo lugar, en un solo tipo de toma. Un video musical se convierte en un cantante frente a un fondo durante noventa segundos. Una lección se convierte en una narración sobre imágenes. Una escena con dos personas en ella se convierte en dos generaciones separadas que cortas para unirlas y esperas que nadie mire demasiado de cerca.
Los cuatro cambios que llegaron recientemente empujan contra esa misma pared. Music Performance ahora compone tipos de escena mixtos por defecto, incluyendo instrumentos y actuación en el escenario en lugar de repetidas tomas de canto. También toma tu propio prompt al inicio y selecciona el reparto de personajes tanto cantantes como no cantantes a partir de las imágenes que proporciones. Kids Performance puede construir una lección en torno a un personaje docente con sincronización labial. Y la sincronización labial ahora maneja múltiples personajes en el mismo video.
Leídos individualmente, parecen cuatro mejoras separadas. Leídos en conjunto, describen un solo cambio: las partes de un video que antes requerían que las ensamblaras, ahora ocurren dentro de la generación.
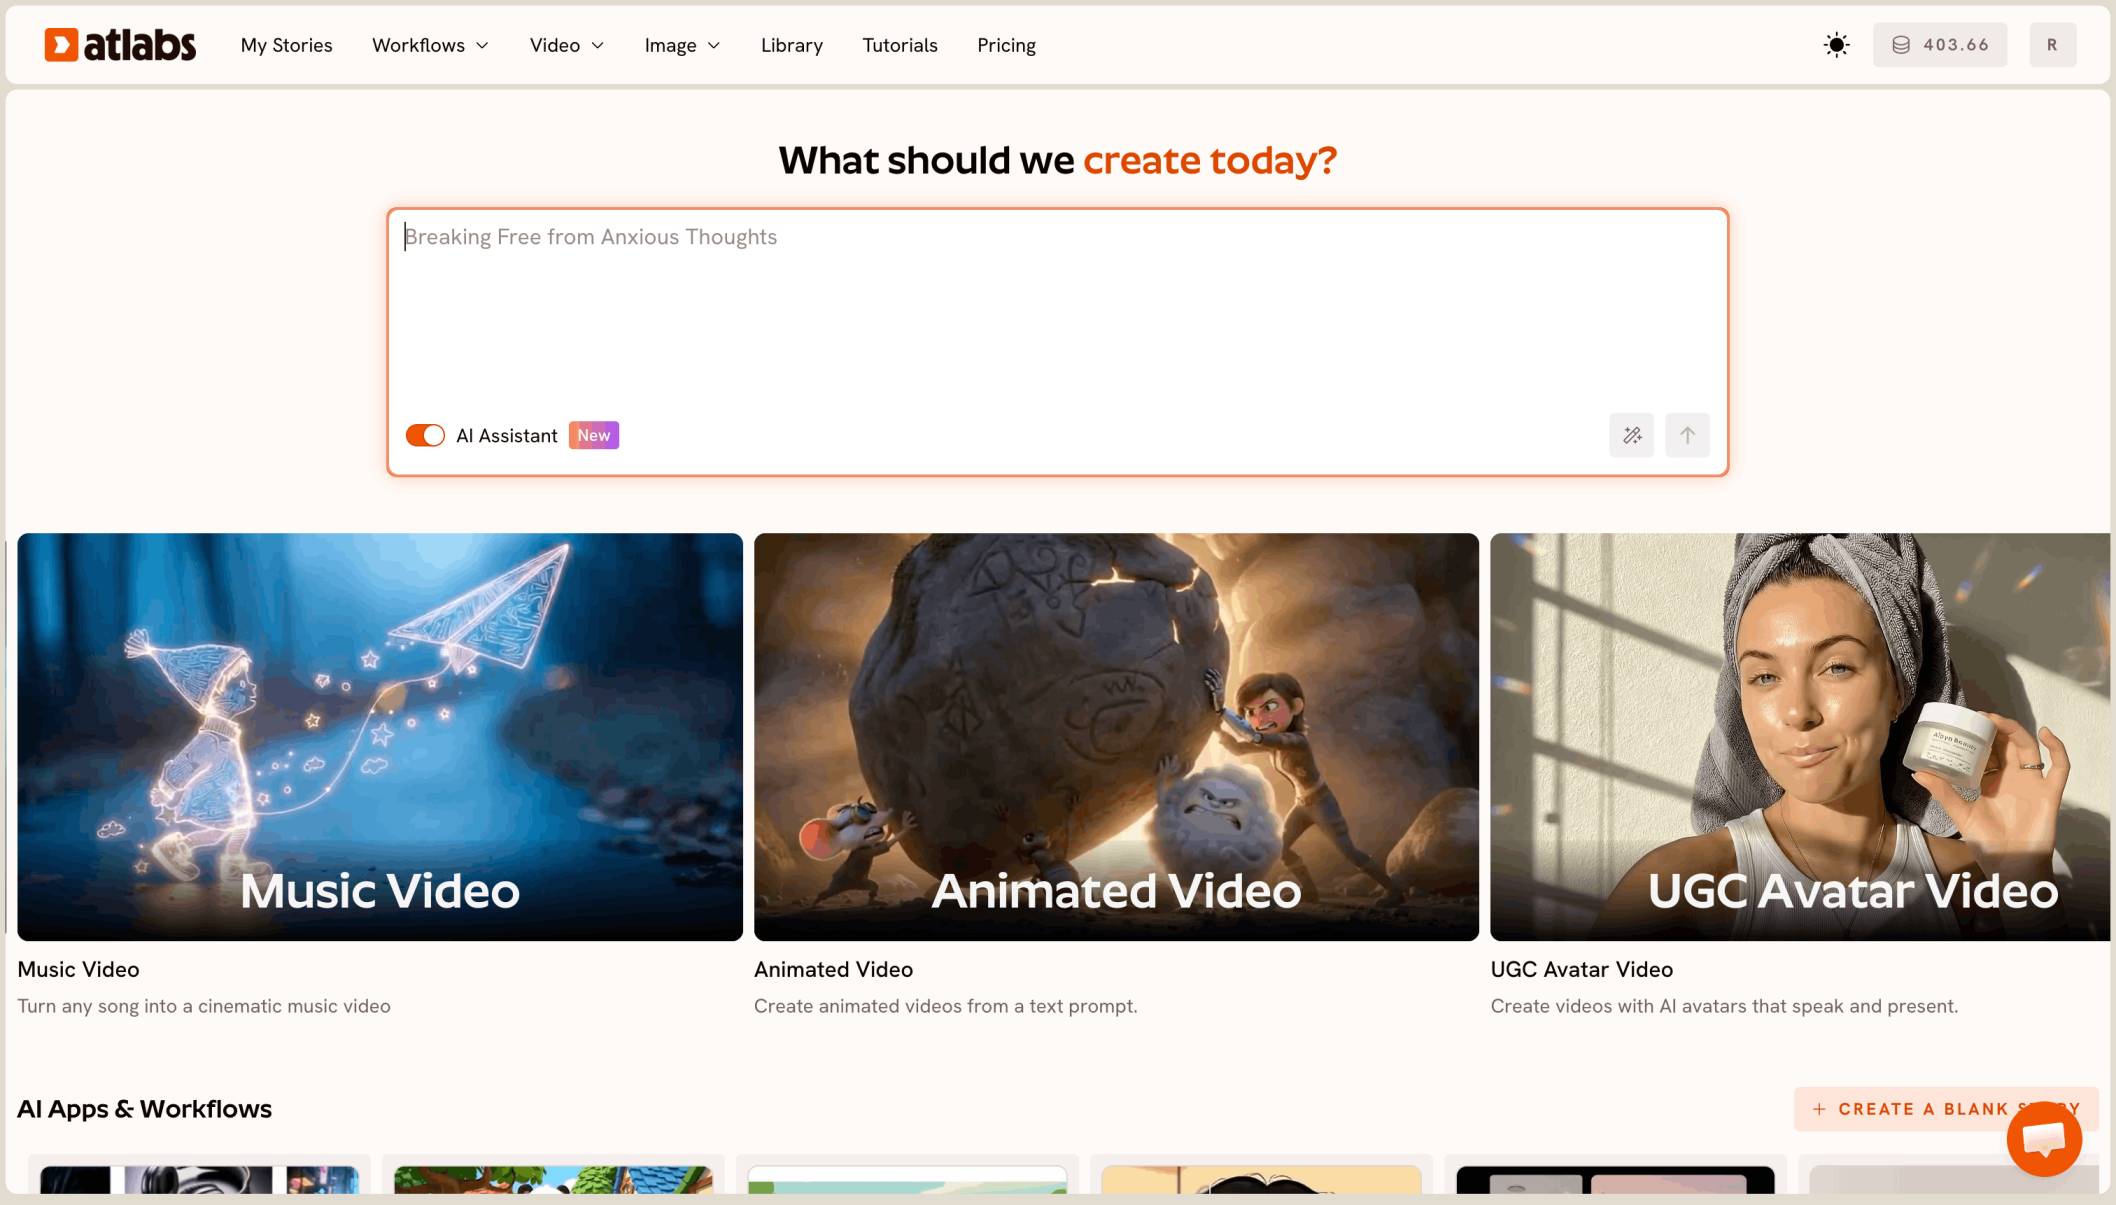
Mira las novedades en Atlabs
Music Performance: Escenas que son más que un solo cantante

El cambio aquí está en la composición y el encuadre. Music Performance ahora produce una gama más amplia de tipos de escena dentro de un solo video, incluyendo escenas de instrumentos y actuación en el escenario, en lugar de variaciones de una sola persona cantando a la cámara.
Para entender por qué eso importa, piensa en cómo se corta un video musical real. Casi nada del tiempo de reproducción es una toma estática de un vocalista. Tienes al vocalista, luego manos moviéndose en un diapasón, luego un baterista a media luz en el fondo de una habitación, luego un plano abierto del escenario con la multitud a contraluz, luego de vuelta al vocalista desde un ángulo diferente a una distancia diferente. El ritmo de esos cortes es una gran parte de lo que hace que el video se sienta como un video musical en lugar de una grabación de alguien cantando. Un modelo que solo produce el primer tipo de toma te deja con un metraje que técnicamente está bien pero estructuralmente plano, y la solución solía ser generar cada tipo de toma adicional por separado y cortarlos tú mismo.
Producir esos tipos de tomas dentro de un solo flujo significa que el ritmo de corte está disponible sin una fase de edición separada. El video llega ya variado, lo cual es un punto de partida diferente al de un video que llega uniforme y necesita ser variado.
El detalle que vale la pena señalar es que esto se aplica en el modo por defecto. Las mejoras que solo surgen una vez que configuras los ajustes avanzados son mejoras con las que la mayoría de la gente nunca se encuentra, porque la mayoría de la gente genera una vez con los valores por defecto y juzga la herramienta por lo que devuelve. Un mejor resultado en una primera ejecución sin configurar es la versión de esta mejora que realmente llega a los usuarios.
Prácticamente, esto amplía a quién sirve el flujo. Un artista independiente que lanza un sencillo obtiene algo más cercano a un video de actuación en lugar de un visual de letra. Un artista de covers obtiene cobertura de instrumentos sin tener una cámara. Cualquiera que produzca contenido de música en un idioma regional, donde rara vez existe el presupuesto para una filmación pero sí la expectativa del público de un video adecuado, obtiene la variedad de tomas sobre la que se construye esa expectativa.
Selecciona el reparto de tu propio video musical
El segundo cambio es un rediseño de cómo comienza Music Performance. Puedes agregar tu prompt al principio del flujo, y la selección del reparto acepta imágenes tanto de cantantes como de no cantantes.
Esa segunda parte tiene más peso de lo que parece a primera vista. Hasta ahora, las personas en un video musical generado eran personas inventadas por el modelo, lo que limita para qué se puede usar el resultado. Un video con un extraño es una pieza ambiental. Un video con el artista es un recurso de lanzamiento. Agregar a tu propio cantante significa que la persona que actúa en la pantalla es la persona que interpreta la canción, y ese único cambio mueve el resultado de algo que muestras a tus amigos a algo que incluyes en un lanzamiento.
El espacio para no cantantes abre una categoría que antes estaba completamente cerrada. Muchas canciones no tratan sobre el acto de cantar, tratan sobre una persona, y esa persona necesita estar en pantalla sin decir una sola línea. El material romántico es el caso más claro. Una canción de amor es cosa de dos. El artista actúa y un segundo coprotagonista lleva la mitad emocional de la historia, apareciendo en las escenas que la letra describe en lugar de gesticularlas. Seleccionar como reparto a una pareja, un amigo o un actor como un personaje no cantante te da ese segundo coprotagonista directamente.
La misma estructura cubre mucho más que el romance una vez que la buscas. Un tratamiento narrativo donde el artista actúa y otros personajes interpretan la historia. Un homenaje donde el sujeto aparece en todo momento sin cantar. Una pieza familiar o comunitaria donde personas reales están presentes como ellas mismas. Una colaboración de marca donde un portavoz aparece junto al artista que actúa. Todos estos tienen la misma forma: una voz, varios rostros.
Combinado con la sincronización labial en la canción elegida, el flujo se convierte en una herramienta de reparto en lugar de un generador cuyo resultado aceptas. Ese es un cambio significativo de postura. Estás decidiendo quién está en el video antes de la generación en lugar de evaluar quién apareció en él después.
Elegir buenas imágenes de origen ayuda aquí de la misma manera que ayuda a cualquier generación impulsada por la identidad. Rostros de frente, iluminados uniformemente y sin obstrucciones le dan al modelo menos cosas que adivinar. Una sombra intensa en la mitad de un rostro, gafas de sol, desenfoque de movimiento y ángulos extremos reducen la consistencia con la que esa persona se mantiene a través de las escenas, lo que bien vale un minuto de selección de imágenes antes de gastar una generación para averiguarlo.
Selecciona el reparto de tu propio video musical
Kids Performance: Un docente que realmente habla
Kids Performance ahora puede construir contenido educativo en torno a un personaje docente cuya boca se mueve con sus propias líneas y solo con sus propias líneas.
El video educativo para niños tiene un requisito que la generación de video general suele pasar por alto. Los espectadores jóvenes siguen los rostros. La atención se mantiene cuando un personaje los mira y habla, y decae cuando una voz narra sobre ilustraciones que no responden a ella. Así es como funciona la atención a esa edad, y es por eso que casi todos los formatos infantiles exitosos en cualquier plataforma se construyen en torno a un presentador, un títere o un personaje que se dirige directamente a la audiencia.
La parte que solía fallar era lo que sucedía cuando un segundo personaje compartía el encuadre. Cada boca en la escena se movía con cada línea, por lo que un docente y un estudiante gesticulaban la frase del docente, y el video dejaba de percibirse como una lección y comenzaba a percibirse como un error. Ahora el habla está atribuida. El docente pronuncia la línea, el estudiante se queda quieto y escucha, y el espectador puede saber quién está hablando, lo cual es la base misma de una lección de dos personajes.
Esa atribución es lo que hace que los formatos funcionen, más que la sincronización labial sola. La explicación de conceptos funciona porque un personaje puede decir "mira lo que pasa cuando hago esto" y luego hacerlo. La fonética y los sonidos de las letras funcionan porque la forma de la boca es parte de la enseñanza en lugar de algo incidental. El conteo y las secuencias de números funcionan porque el ritmo proviene de una persona que habla en lugar del temporizador de un subtítulo. La ciencia paso a paso funciona porque un presentador puede guiar al espectador a través de una secuencia de una manera que la narración sobre imágenes fijas no puede. Los formatos de preguntas y respuestas funcionan ahora de una manera que simplemente no podían antes, porque el estudiante puede preguntar y el docente puede responder sin que ambos parezcan decir lo mismo.
Para el operador de un canal infantil, esto cambia la pregunta de producción de cómo hacer presentaciones de diapositivas narradas más rápido a cómo hacer lecciones con un reparto. Para un docente o un equipo de tecnología educativa, significa que el material del aula puede contar con un presentador constante y un segundo personaje para hacer las preguntas que haría una clase, sin filmar a nadie.
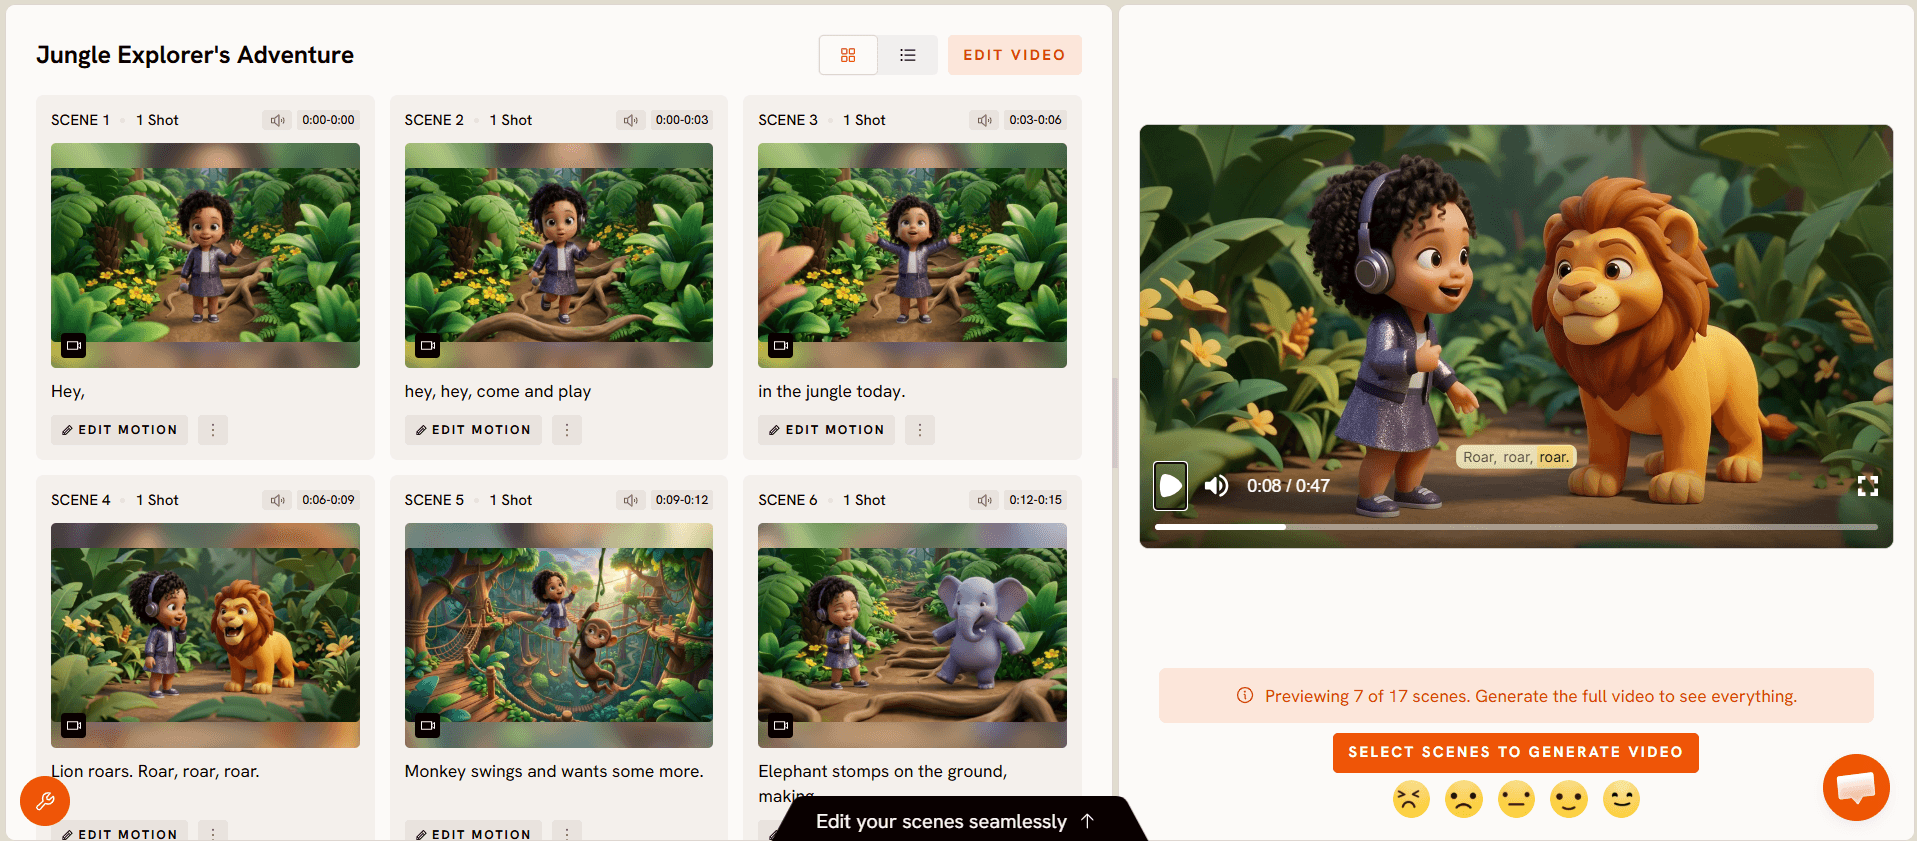
Escribir un guion para esta audiencia premia la moderación. Una idea por pulso, frases cortas y repetición deliberada de la frase clave. Un personaje con sincronización labial que lee frases densas para adultos produce un video que técnicamente funciona pero que no enseña nada, porque la entrega supera al oyente.
Sincronización labial multipersonaje
La sincronización labial ahora funciona en múltiples personajes en lugar de uno solo.
La sincronización labial de un solo personaje cubre el busto parlante, y el busto parlante cubre una franja sorprendentemente estrecha de lo que la gente quiere crear. Todo lo conversacional queda fuera de ella. Dos personajes intercambiando líneas. Un docente y un estudiante. Una entrevista. Un cliente y un agente de soporte en un video explicativo de producto. Un padre y un hijo en una historia. Una sección de llamada y respuesta en un coro. En cada uno de ellos, la respuesta importa tanto como la línea.
Producirlos con sincronización labial de un solo personaje significaba generar a cada hablante por separado y cortar entre ellos. Eso es lento y, lo que es más importante, se nota lo que es. Las dos mitades nunca llegan a compartir realmente una habitación, las líneas de mirada no coinciden, la iluminación varía y el ritmo del intercambio tiene que fabricarse en la edición en lugar de ser interpretado. Cualquiera que haya intentado fingir una conversación de dos personas de esta manera sabe que el resultado se percibe como dos monólogos uno al lado del otro.
Manejar más de un hablante dentro de la misma generación hace que el diálogo sea un resultado nativo. El intercambio ocurre en un solo espacio, con una sola configuración de iluminación y con un ritmo que pertenece a la escena en lugar de a tu línea de tiempo.
Esta es también la capacidad que sustenta a la mayoría de las otras tres. Un video musical con reparto y un segundo coprotagonista que no canta deja de ser convincente en el momento en que ese personaje necesita decir algo. Una lección con un personaje docente mejora sustancialmente cuando un segundo personaje puede hacer la pregunta que responde la lección. La sincronización labial multipersonaje es lo que hace que esos formatos se mantengan unidos.
Cómo sacar el máximo provecho de estos cambios
1. Decide tu reparto antes de escribir nada. Quién canta, quién aparece y quién habla son tres preguntas diferentes ahora, y responderlas de antemano cambia lo que escribes. Una canción con un segundo coprotagonista necesita escenas en las que ese coprotagonista pueda estar.
2. Reúne las imágenes de origen correctamente. Rostros de frente, iluminados uniformemente, un rostro claro por imagen. Dedica el minuto extra aquí en lugar de diagnosticar variaciones de identidad más tarde.
3. Genera primero en el modo por defecto. Las mejoras en la composición de la escena se aplican allí, por lo que tu primera ejecución es una prueba justa del flujo en lugar de un ejercicio de configuración. Cambia las cosas después de haber visto una línea de base.
4. Escribe el diálogo como un intercambio, no como dos discursos. Ahora que más de un personaje puede hablar, las líneas cortas y alternas superan a los bloques largos. Deja que el segundo personaje interrumpa, pregunte o reaccione.
5. Para contenido infantil, escribe el guion siguiendo el pulso, no la página. Una idea por pulso, repite la frase clave y deja espacio para que el personaje sea mirado en lugar de solo escuchado.
Ejemplos de prompts
1. Actuación de banda completa. Una banda indie de cuatro integrantes actuando en un almacén convertido al atardecer, luces de cadena en el techo, polvo en el aire. Cortes entre el vocalista en el micrófono, manos moviéndose en el diapasón de un bajo, el baterista a media luz al fondo y un plano abierto de la sala con la pequeña multitud a contraluz. Iluminación práctica cálida, profundidad de campo reducida, sensación de cámara en mano en las tomas abiertas. Prueba esto en Atlabs Music Performance
2. Tratamiento romántico con dos coprotagonistas. Una azotea en la hora azul, la bruma de la ciudad captando la última luz. El artista actúa contra el horizonte mientras un segundo personaje, que nunca canta, se mueve a través de las escenas que describe la letra, sentado en la cornisa, subiendo la escalera, observando desde el umbral de la puerta. Tonalidad fría suave, tonos de piel cálidos, movimientos lentos de cámara en todo momento. Prueba esto en Atlabs Music Performance
3. Enfoque en un instrumento solista. Un solo intérprete en un piano vertical en una sala de ensayo vacía, luz de la mañana a través de ventanas altas. Alterna entre un plano abierto de la sala, un primer plano de las manos, un perfil a la altura de los ojos y un empuje lento hacia el rostro en la frase final. Paleta apagada, solo luz natural. Prueba esto en Atlabs Music Performance
4. Explicador con personaje docente. Una docente amigable animada en un aula luminosa explica por qué flota el hielo, dirigiéndose directamente a la cámara. Sostiene un vaso de agua, deja caer un cubo de hielo y señala mientras este flota. Frases cortas, una idea a la vez, repitiendo la frase clave al final. Colores cálidos, fondo simple, nada que compita con su rostro. Prueba esto en Atlabs Kids Performance
5. Lección de dos personajes. Un personaje docente y un estudiante curioso en un entorno de jardín. El estudiante pregunta por qué las hojas cambian de color, el docente responde en tres pasos cortos y el estudiante repite la respuesta. Ambos personajes hablan frente a la cámara con iluminación y líneas de mirada coordinadas. Paleta brillante, suave, de libro de cuentos. Prueba esto en Atlabs Kids Performance
Ejecuta estos en Atlabs
Preguntas frecuentes
¿Puedo usar mi propio rostro en un video musical ahora? Sí. Music Performance acepta tus propias imágenes al inicio del flujo, tanto para personajes cantantes como no cantantes.
¿Para qué sirve un miembro del reparto que no canta? Cualquier personaje que aparece sin interpretar la parte vocal. Un coprotagonista romántico, un personaje de la historia, el sujeto de un homenaje o cualquiera cuya presencia importe para el concepto más que para la interpretación.
¿La composición mejorada de la escena necesita ajustes especiales? No. La gama más amplia de composición, encuadre y tipos de escena se aplica en el modo por defecto, por lo que una primera generación sin configurar la refleja.
¿Qué tipos de tomas produce Music Performance ahora? Más allá de cantar a la cámara, compone tipos de escena mixtos que incluyen escenas de instrumentos y actuación en el escenario dentro del mismo video.
¿Para qué es útil la sincronización labial multipersonaje? Cualquier video donde hable más de una persona. Conversaciones, intercambios entre docente y estudiante, entrevistas y secuencias de llamada y respuesta se vuelven posibles en una sola generación.
¿Qué puedo crear con un personaje docente con sincronización labial? Explicaciones de conceptos, fonética y sonidos de letras, secuencias de conteo, ciencia paso a paso, aprendizaje de idiomas y lecciones basadas en historias. Cualquier cosa que funcione mejor entregada por un presentador que por una narración.
¿Funcionan estos cambios en conjunto? Sí, y ahí es donde reside la mayor parte del valor. El reparto más la sincronización labial multipersonaje es lo que hace que un video musical de dos coprotagonistas o una lección de dos personajes se mantengan unidos como una sola escena.
Lo que todo esto significa
El hilo conductor de los cuatro cambios es que el trabajo que antes ocurría después de la generación ahora ocurre durante ella. La variedad de tomas era un problema de edición. Un segundo personaje era una segunda generación. El diálogo eran dos clips cortados y unidos. La selección de reparto no estaba realmente disponible en absoluto.
For los creadores de música, esto significa un video que parece editado en lugar de generado, que presenta al artista real y a las personas reales de las que trata la canción. Para los creadores de educación, significa una lección con un presentador en lugar de una presentación de diapositivas narrada. Para ambos, significa menos generaciones separadas que conciliar y menos lugares donde se noten las costuras.